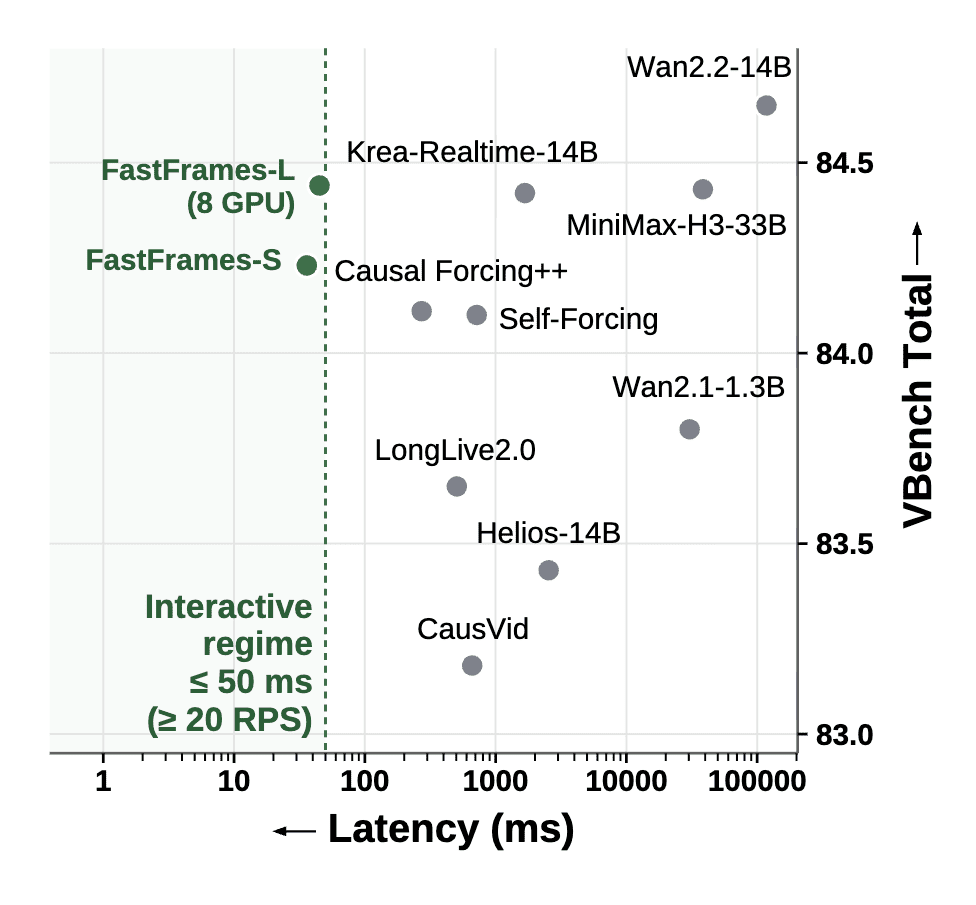
Исследователи Apple и Cornell University представили FastFrames, семейство авторегрессионных диффузионных моделей, которые генерируют видео в реальном времени и тратят на кадр меньше 50 мс. По исследованиям взаимодействия человека с компьютером, задержку около 50-60 мс люди уже замечают. Поэтому такая скорость нужна играм и интерактивным симуляторам. FastFrames-S собрана на основе Causal Forcing++, самой быстрой из прошлых моделей: трансформер у них общий, но FastFrames-S тратит на кадр 36 мс на одной видеокарте B200 вместо 272 мс и по VBench не уступает оригиналу. FastFrames-L на 14 млрд параметров укладывается в 45 мс на восьми B200. Ни одна из совревенных моделей не генерирует кадр быстрее 50 мс. Код инференса и обучения открыт под лицензией Apple Sample Code License, веса доступны только для некоммерческих исследований, а внутренний датасет из 10 тысяч видео не опубликован. Код лежит на GitHub, веса FastFrames-S и FastFrames-L на Hugging Face, примеры видео есть на странице проекта.
Почему для видео в реальном времени мало FPS
Авторегрессионная модель генерирует видео по тексту кадр за кадром и опирается на уже готовые кадры. Поэтому между шагами в генерацию можно добавить новую команду, например поворот камеры. Генерацию видео в реальном времени часто подтверждают числом кадров в секунду (FPS), но оно не говорит о скорости реакции. Модель, которая за секунду генерирует пачку из 30 кадров, работает на 30 FPS, но с задержкой в 1 секунду после получения команды. Например, Helios заявляет 19.5 FPS на одной H100, а в замерах авторов FastFrames её ответа на B200 ждут 2.5 секунды. Поэтому авторы оценивают сквозную (end-to-end) задержку от получения команды до первого кадра с реакцией на него. Из неё считают число генераций в секунду: RPS = 1000 / задержка в мс. Порогу 50 мс соответствуют 20 RPS, у FastFrames-S их 27.8, у Causal Forcing++ 3.68.
Куда уходит время
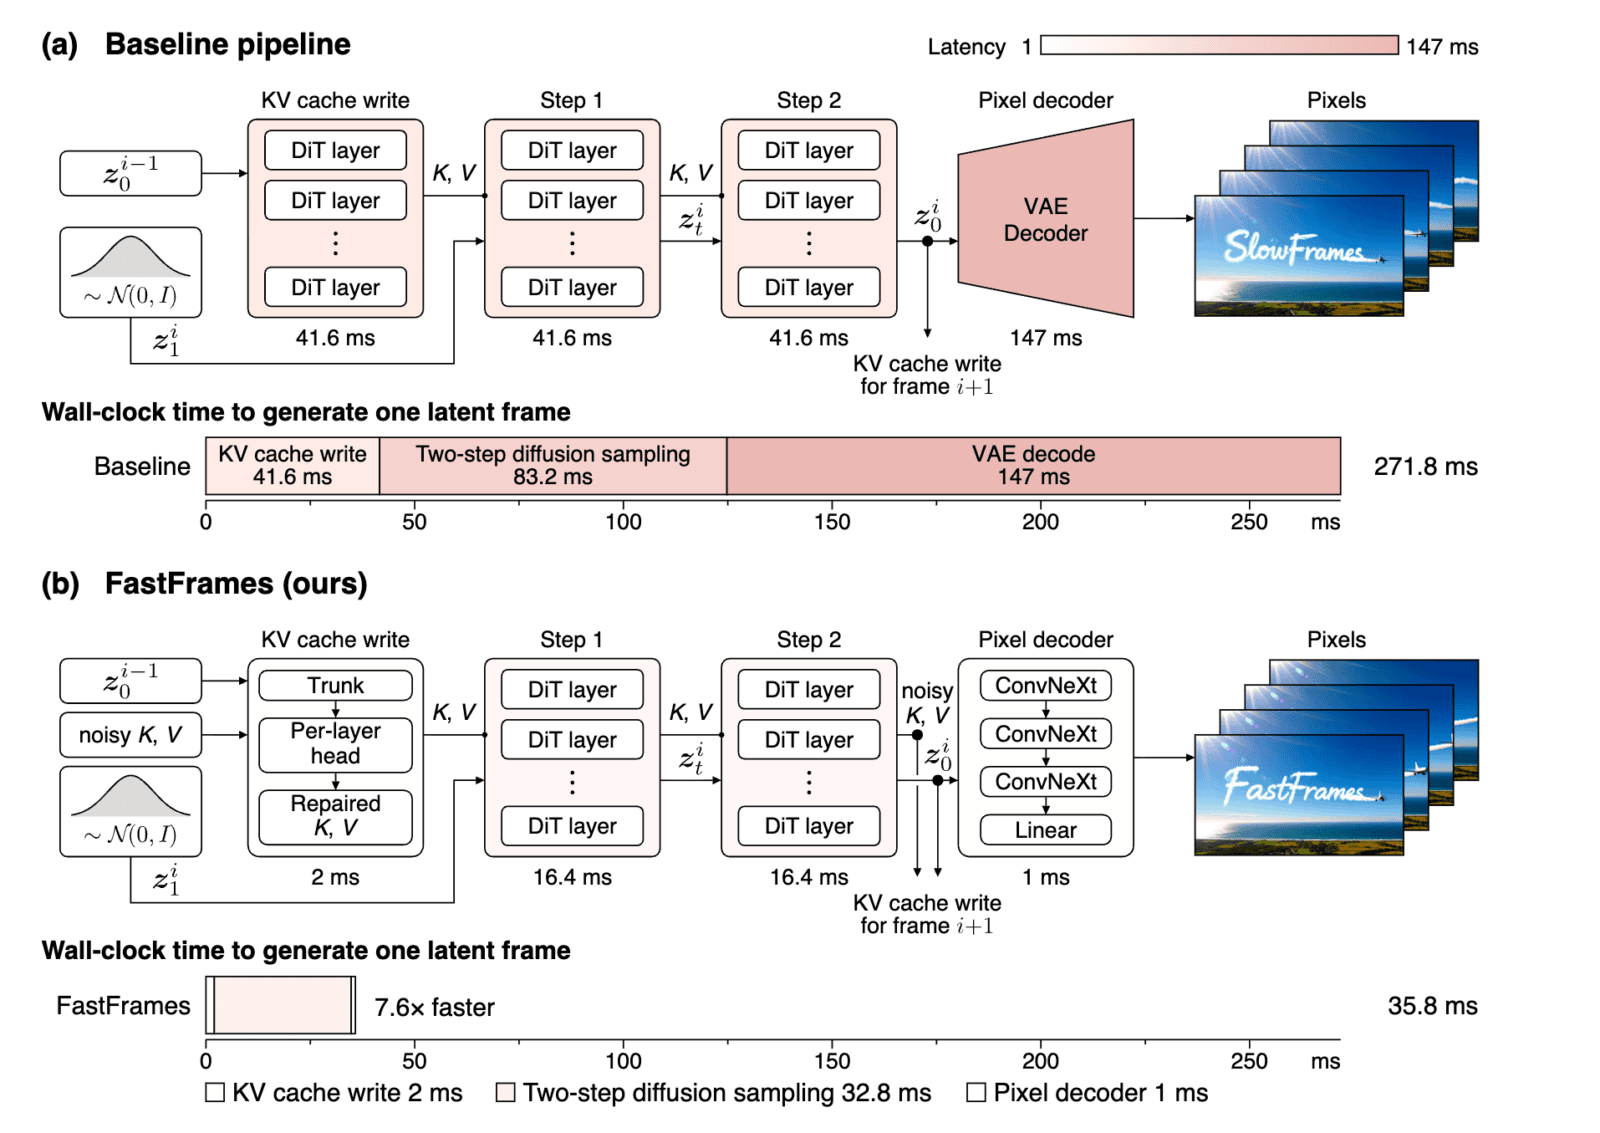
Авторы разобрали по шагам Causal Forcing++ на базе Wan 2.1 с 1.3 млрд параметров. За один шаг модель генерирует латентный кадр, который декодер разворачивает в четыре обычных кадра. На одной B200 шаг занимает 271.8 мс:
- Обновление KV-кэша, 41.6 мс. Диффузионный трансформер (DiT) помнит прошлые кадры через KV-кэш, то есть сохранённые ключи и значения слоёв внимания. Чтобы записать туда чистую версию предыдущего кадра, модель делает лишний проход DiT;
- Диффузия, 83.2 мс. Два шага расшумления по 41.6 мс. С одним шагом качество заметно падает, а задержка сокращается всего на 15%;
- Декодер VAE, 147 мс. Перевод латента в пиксели.
На само расшумление приходится около 30% времени, а декодер VAE в одиночку втрое превышает бюджет в 50 мс. Поэтому FastFrames ускоряет прежде всего декодер и кэш.
Пиксельный декодер вместо VAE
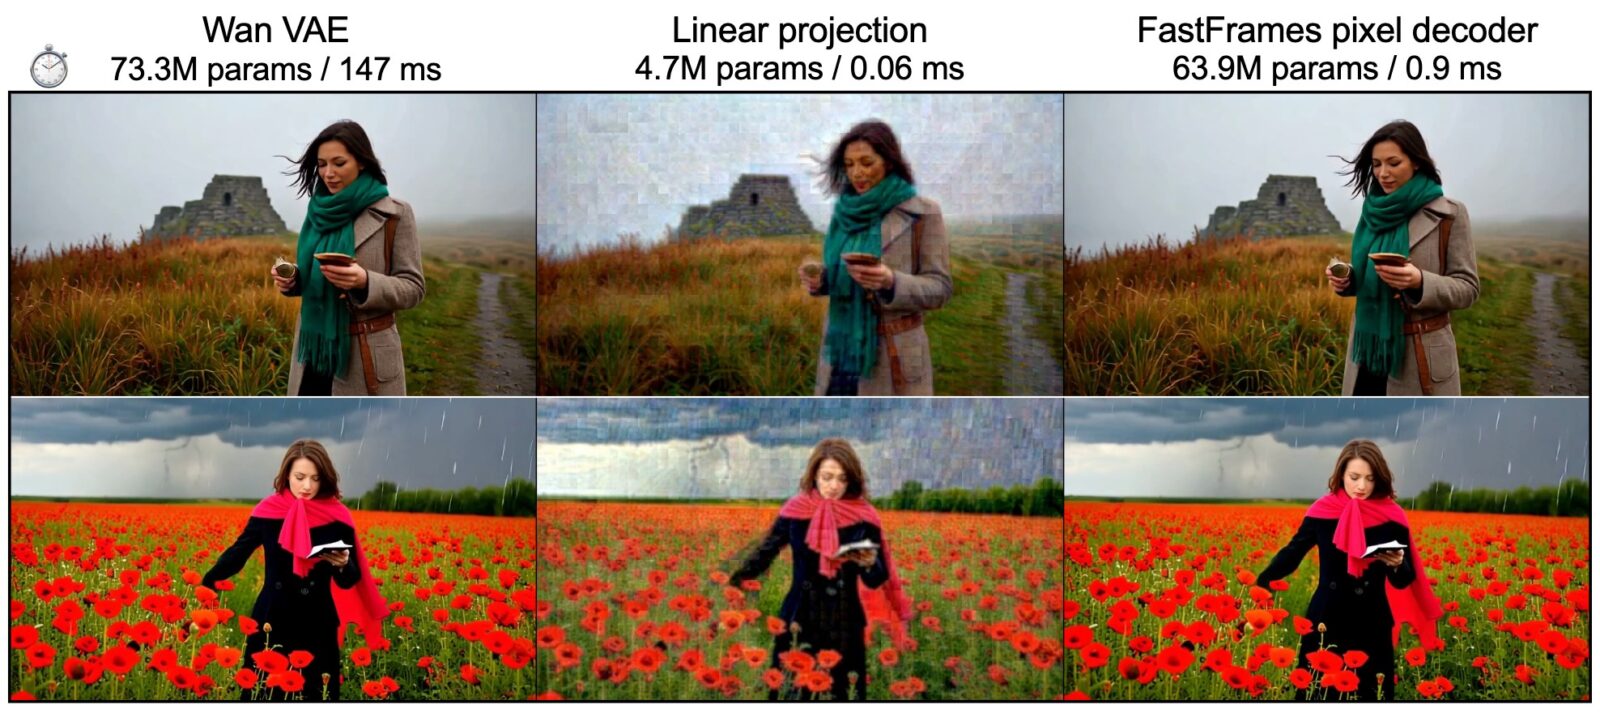
Декодер VAE от Wan весит всего 73.3 млн параметров, но многократно повышает разрешение и считает плотные 3D-свёртки. Авторы проверили, нужен ли он вообще: один линейный слой, обученный повторять выход VAE, дал размытое, но узнаваемое видео.
Финальный декодер из трёх каузальных 3D-блоков в стиле ConvNeXt работает прямо на сетке токенов DiT. Последний линейный слой превращает каждый токен в фрагмент из четырёх кадров по 16×16 пикселей. При 63.9 млн параметров декодер тратит 0.9 мс вместо 147 мс. Сначала его учат повторять выход VAE при замороженном DiT, затем дообучают с дискриминатором на основе DINOv3 на 10 тысячах реальных видео. Такое состязательное обучение (adversarial training) в пикселях стало практичным: новому декодеру нужно около 5 ГБ видеопамяти против 68 ГБ у VAE. Минус: один VAE подходит всем моделям Wan, а пиксельный декодер обучают под каждую модель.
Обновление KV-кэша за 2 мс
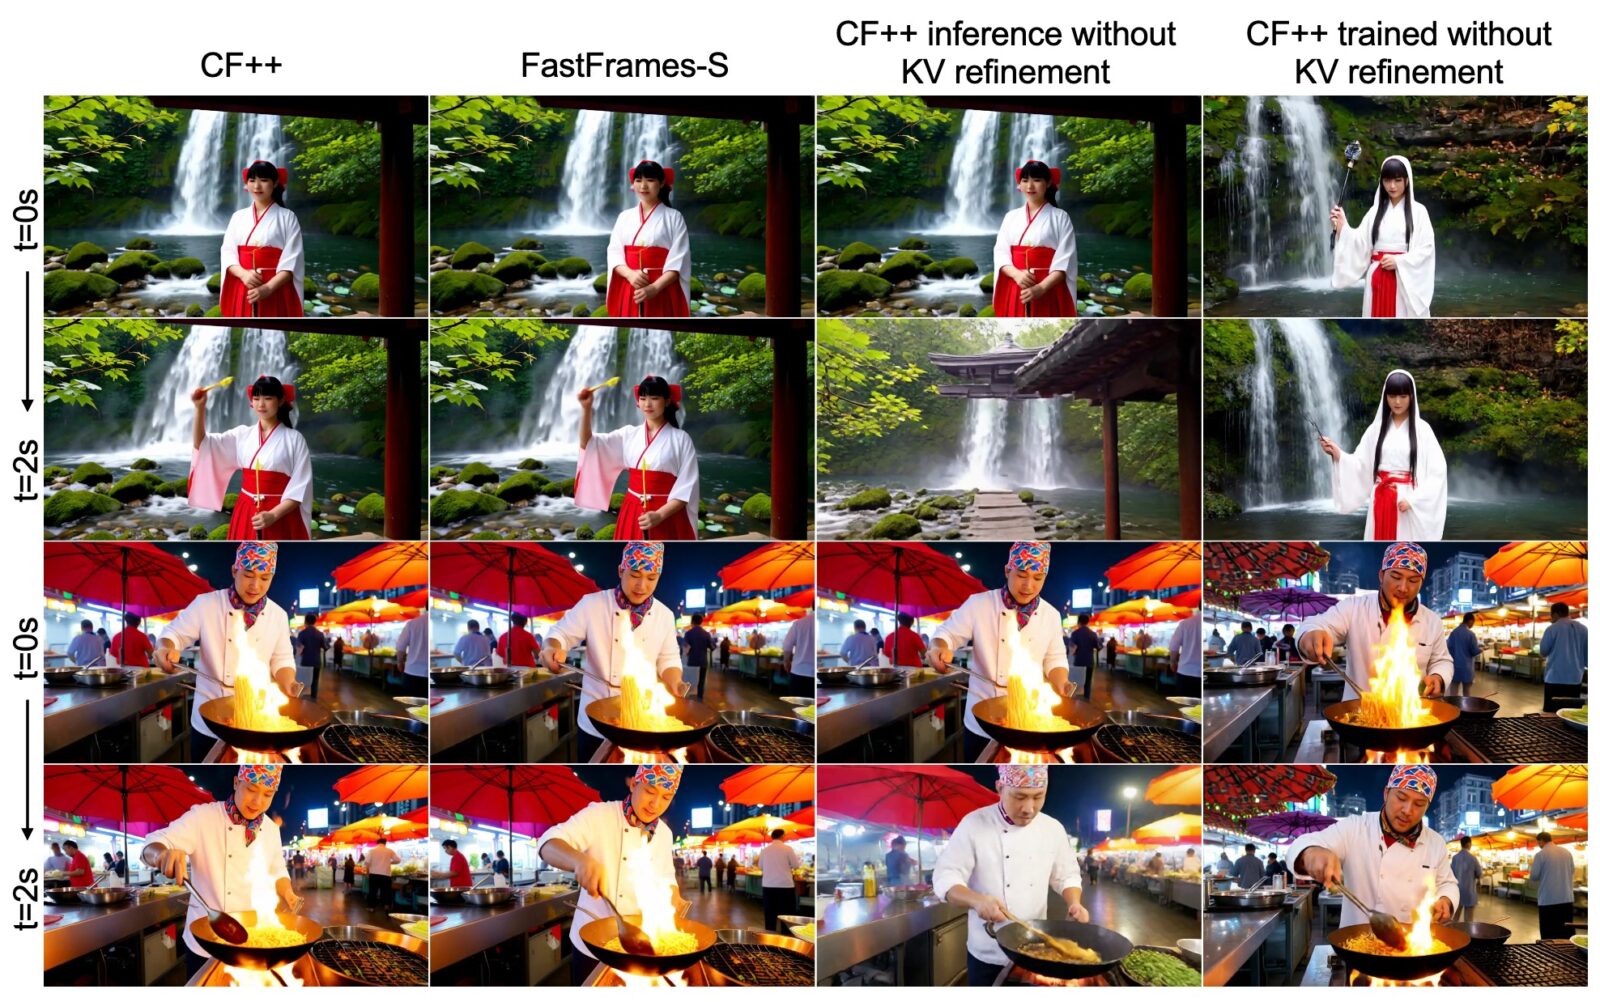
На последнем шаге расшумления DiT видит ещё зашумлённый кадр, поэтому ключи и значения, которые он пишет в кэш, посчитаны по шуму. Чтобы это исправить, прошлые модели прогоняли DiT ещё раз на чистом кадре только ради кэша, а результат прохода выбрасывали. Совсем убрать проход нельзя: без него объекты в сцене меняются через пару секунд, а обучение на зашумлённом кэше даёт артефакты.
FastFrames заменяет проход маленькой сетью. Её четыре трансформерных блока читают чистый кадр, а головы для каждого слоя DiT предсказывают поправки к ключам и значениям. Обновление кэша занимает 2 мс вместо 41.6 мс у модели на 1.3 млрд параметров и 6 мс у модели на 14 млрд, без потери качества.
Оптимизации под GPU
Теперь основное время занимает DiT. Его ускорили инженерными приёмами вроде CUDA graphs, слияния проекций Q, K и V и параллельного расчёта внимания по отдельным частям кэша. Проход DiT ускорился с 41.6 до 16.4 мс. На восьми B200 видеокарты делят токены между собой (context parallelism): проход занимает 5.8 мс у младшей модели и 20.3 мс у старшей.
Видео в реальном времени без потери качества
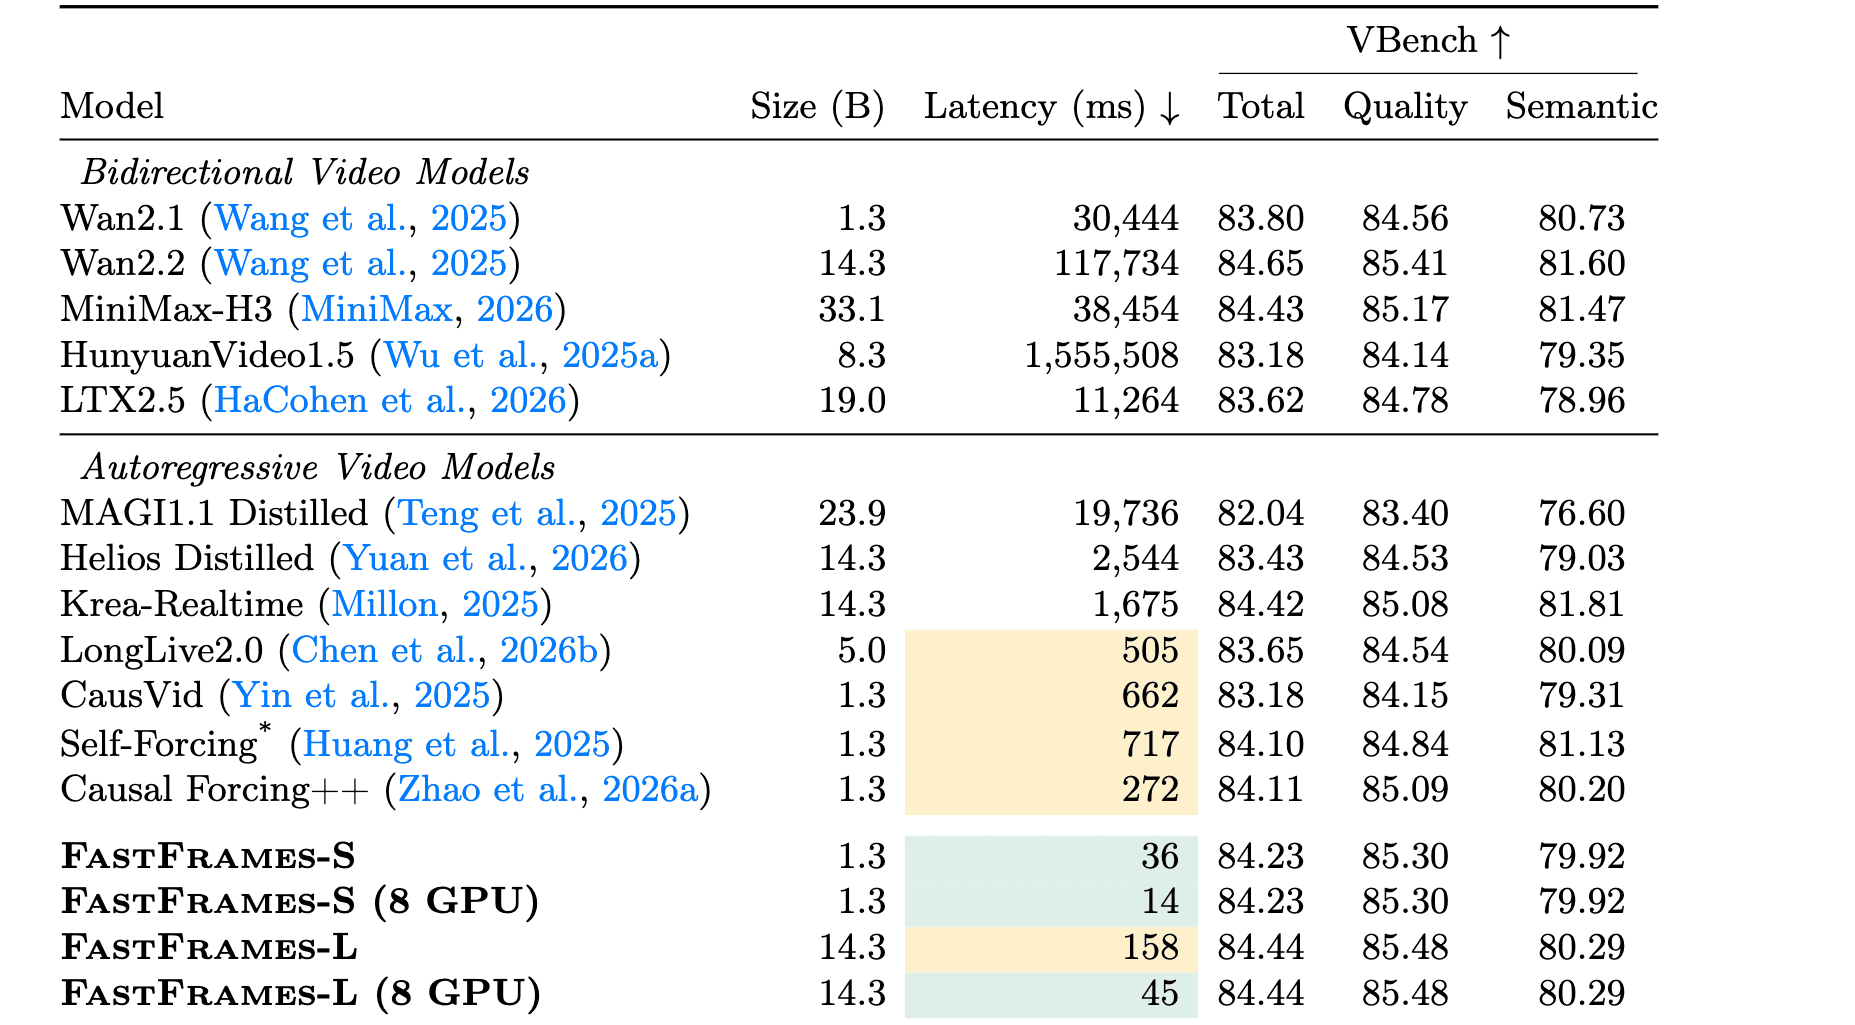
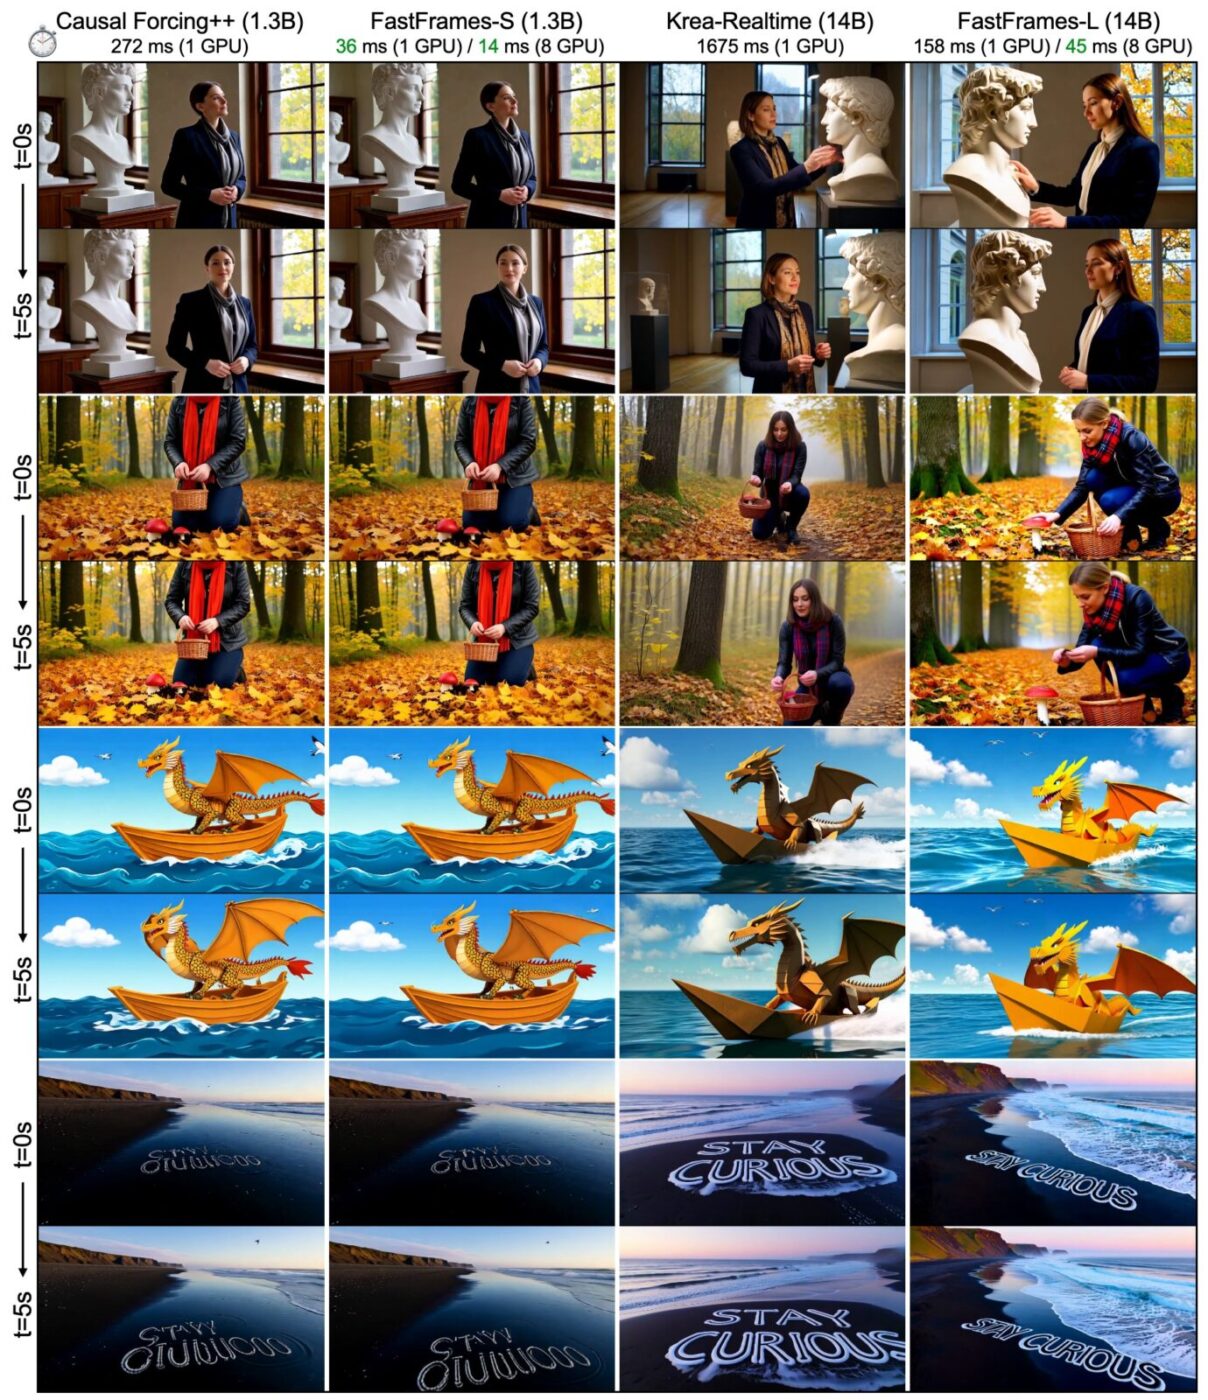
Все модели запускали с одинаковыми промптами и сидами при разрешении около 480p. Задержку авторегрессионных моделей мерили при заполненном KV-кэше. FastFrames-S набирает в VBench 84.23 балла против 84.11 у Causal Forcing++ с теми же весами DiT. Прибавку авторы объясняют состязательным обучением декодера. FastFrames-L набирает 84.44 против 84.42 у Krea-Realtime и на одной видеокарте работает в 10.6 раза быстрее: 158 мс против 1 675 мс. По семантической части VBench обе модели FastFrames немного уступают бейзлайнам: 79.92 против 80.20 и 80.29 против 81.81.
Видео в реальном времени с управляемой камерой и физикой
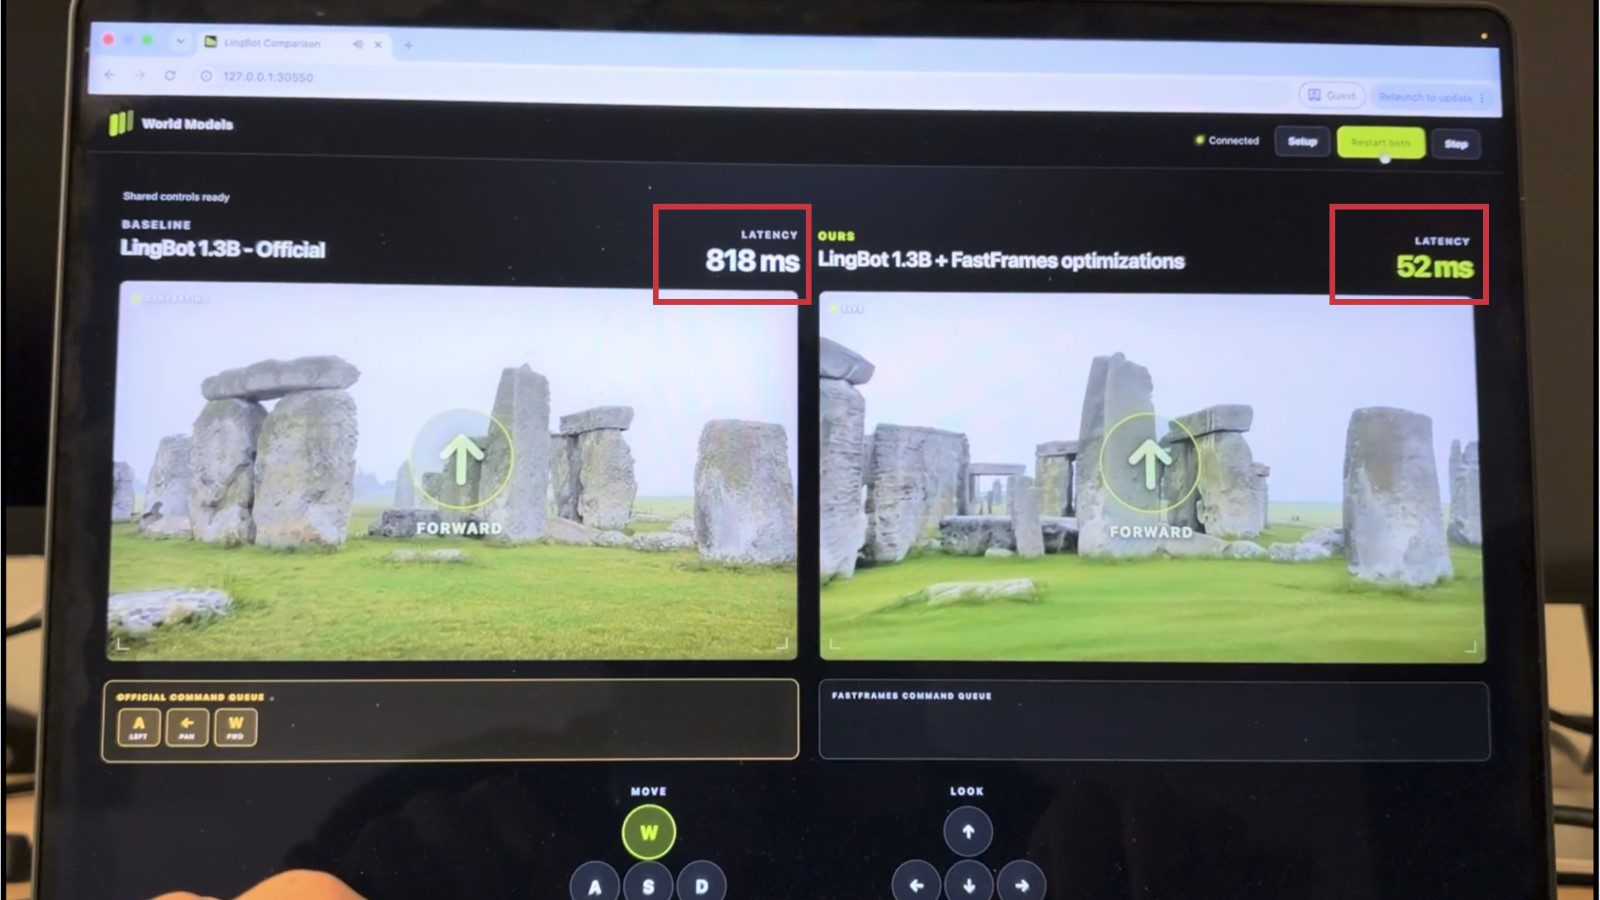
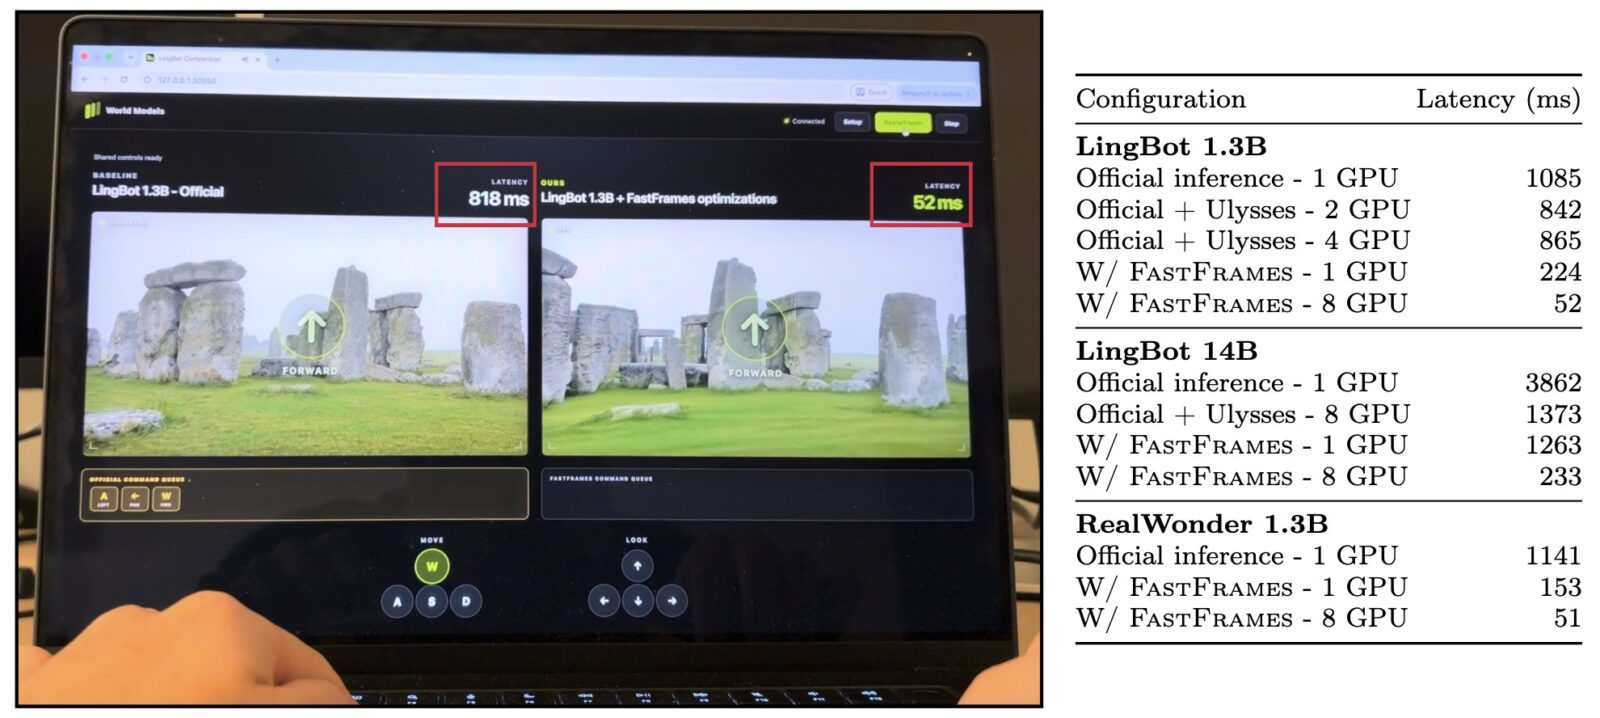
Приёмы FastFrames переносятся на готовые модели без большого датасета: целевые кадры и чистый кэш получают, прогоняя саму модель. Авторы ускорили модели мира LingBot на 1.3 и 14 млрд параметров с управлением камерой. Ещё ускорили RealWonder на 1.3 млрд, которая учитывает физику сцены. Задержка LingBot 1.3B упала с 842 мс в лучшей официальной конфигурации до 52 мс на восьми B200 (в 16 раз), RealWonder с 1141 до 51 мс (в 22 раза), LingBot 14B с 1373 до 233 мс. Догнать FastFrames им мешает устройство: LingBot делает четыре шага диффузии и генерирует сразу четыре латентных кадра, а RealWonder по три. Демо LingBot 1.3B с управлением клавишами WASD есть в репозитории.
Ограничения
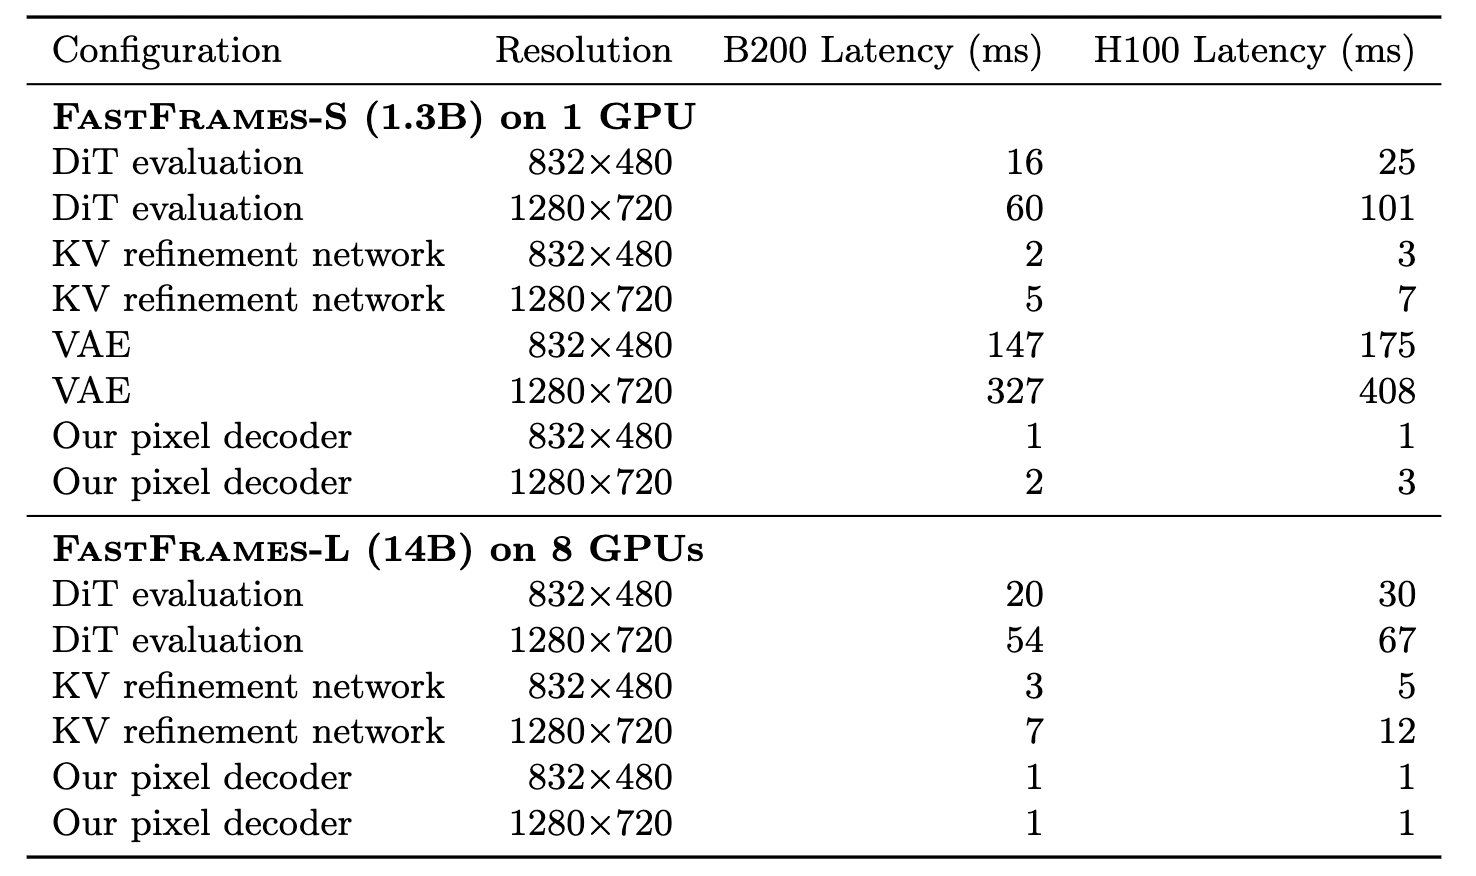
Основные замеры сделаны при 480p на дорогих серверных B200. При 720p FastFrames-S выдаёт кадр за 127 мс на одной B200, а FastFrames-L за 116 мс на восьми, так что видео в реальном времени при 720p пока не получается. На H100 те же операции идут на 25-50% медленнее.
Модели с управлением пока медленнее генерации по тексту. Авторы советуют обучать базовые модели с расчётом на низкую задержку, например подавать позу камеры через каналы, а не через последовательность токенов. Долгосрочную согласованность сцены и физическую правдоподобность ещё предстоит улучшать.