Исследователи из University of Melbourne представили VeriSpoof — открытую аудиоязыковую модель (audio LLM) для выявления голосовых дипфейков (speech forensics). Она решает сразу пять задач, для которых обычно обучают отдельные модели. VeriSpoof распознаёт голосовые дипфейки, даже если подделана только часть записи, и показывает, какая именно. Ещё она определяет модель генератора, а для пары записей проверяет, созданы они одним генератором или разными. Также модель описывает шум, эхо и сжатие записи: это не признаки подделки, но они мешают анализу. Свой вывод модель подробно объясняет, каждое утверждение можно проверить: измерить на самой записи или сверить с разметкой датасета.
Модель пригодится нескольким группам исследователей. Разработчики приложений, которые распознают голосовые дипфейки, получили сильную открытую модель для сравнения и бенчмарк с её ответами на каждый вопрос. Разработчикам своих аудио-LLM пригодятся абляционные эксперименты, где авторы меняли по одному компоненту: по ним видно, что качество детекции определяет энкодер, а качество сравнения записей определяет языковая модель. Ещё VeriSpoof полезна экспертам, которые проверяют голосовые записи, например приложенные к делу как улика. Им мало вердикта «подделка или нет»: нужно понять, каким генератором сделана запись, совпадает ли источник у двух сообщений и на чём основан вывод. По оценке авторов, для запуска хватит видеокарты на 8 ГБ вроде RTX 4060. Для коммерческих продуктов VeriSpoof не подходит: лицензия CC BY-NC 4.0 запрещает коммерческое использование.
Две версии модели
Авторы выпустили две версии модели. Обе устроены одинаково: энкодер речи Qwen3-ASR и языковая модель MiniCPM5-2B, всего 2.85 млрд параметров. Отличаются они данными для обучения.
- VeriSpoof-Base обучена на официальных обучающих выборках 11 датасетов, это около 0.38 млн записей, и на ней авторы проводят все контролируемые эксперименты.
- VeriSpoof-Plus обучена по тому же рецепту, плюс ещё на 12 датасетах, всего около 4.4 млн записей.
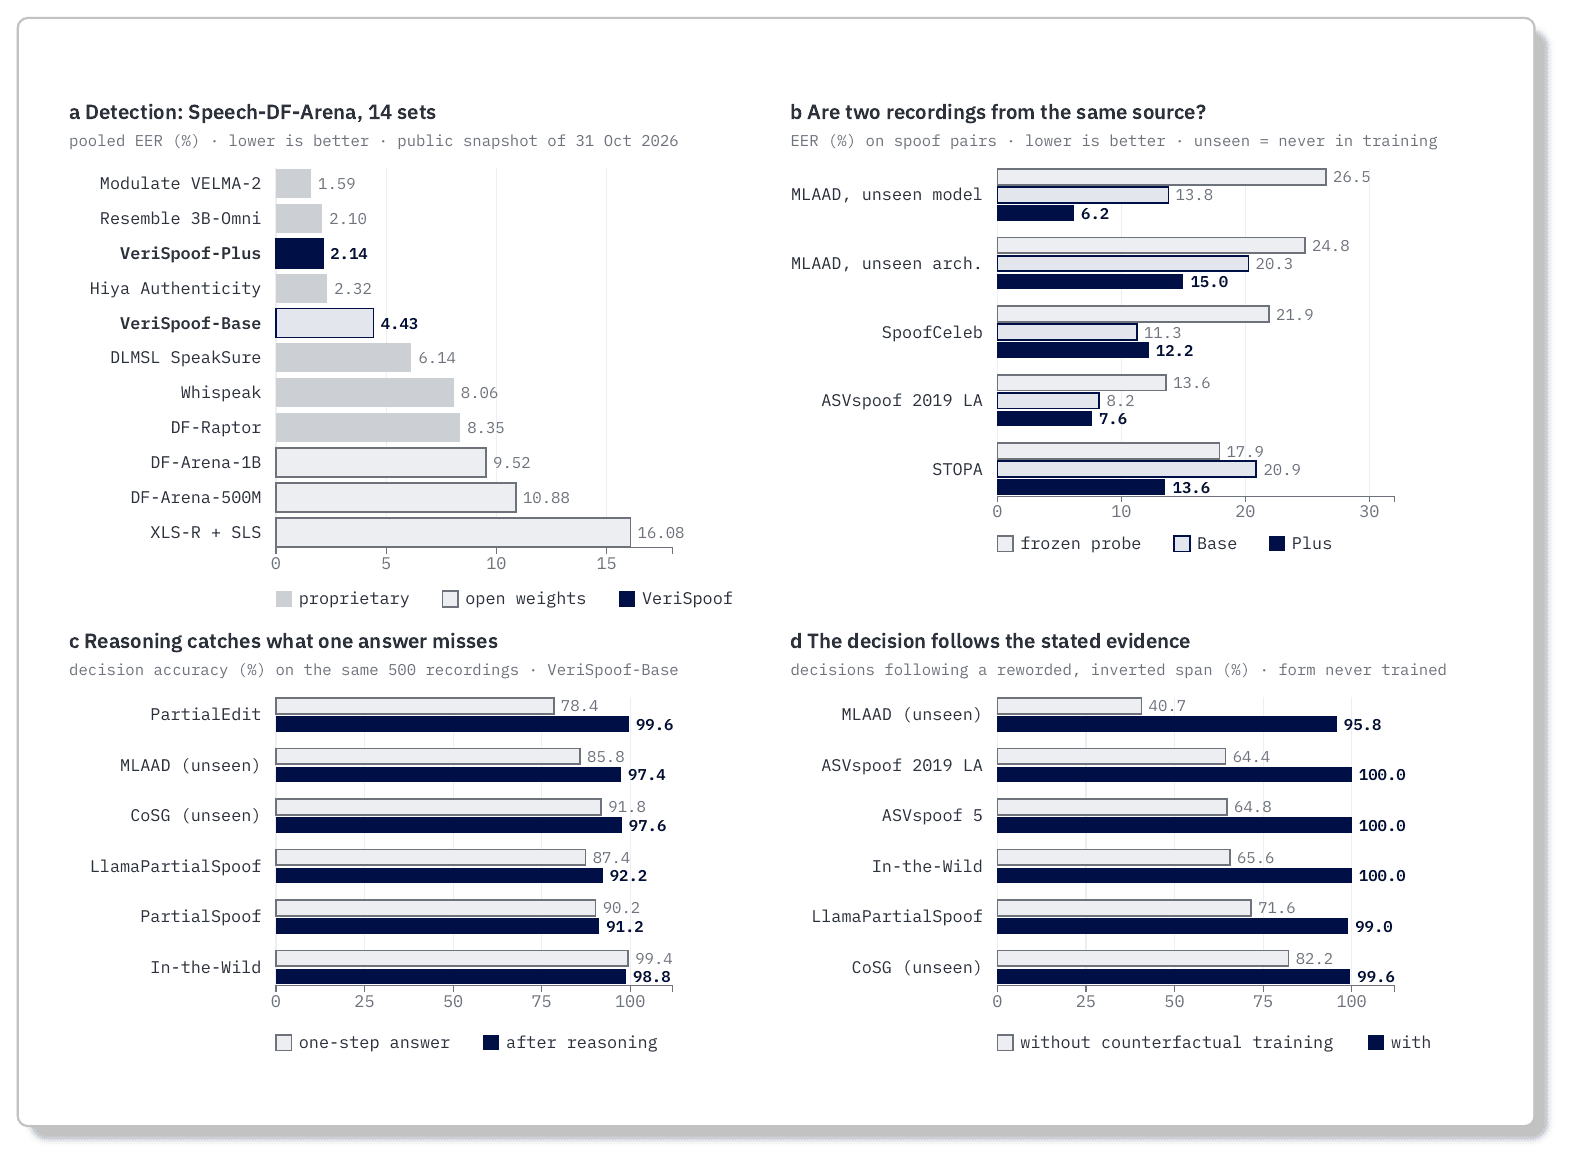
На 14 наборах бенчмарка Speech-DF-Arena Plus ошибается лишь в 2.14% случаев — это 3 место из 28 среди всех моделей и первое среди моделей с открытыми весами. Генератор, которым сделана подделка, Plus определяет в 96.8% случаев, если этот генератор встречался в обучении. VeriSpoof-Base находит 99.6% частичных подделок из PartialEdit, когда сначала пишет обоснование вывода, против 78.4% при прямом ответе. При этом обучение обходится дёшево: энкодер и языковая модель заморожены, поэтому обновляются только 29.7 млн параметров, с включенным gradient checkpointing хватает одной видеокарты на 24 ГБ. Веса VeriSpoof-Plus и VeriSpoof-Base и код инференса открыты под некоммерческой лицензией CC BY-NC 4.0, также доступны демо и бенчмарк VeriSpoof-Bench на 177 852 вопроса, а код обучения обещают выложить позже.
Как модель проверяет голосовые дипфейки
На запросы модель отвечает как на тест с вариантами ответа. Варианты записаны обычными предложениями, например «Это настоящая речь» и «Это подделка». Она оценивает, насколько вероятен каждый вариант для этой записи, и выбирает более вероятный. В вопросе «настоящая или подделка» перевес одного варианта над другим (разность логарифмов их правдоподобия) служит оценкой: чем сильнее перевес в сторону «подделки», тем вероятнее, что запись синтезирована. Поэтому под каждую задачу не нужен отдельный классификатор: на все вопросы отвечает одна языковая модель.
Оценку сравнивают с порогом, чтобы перейти к ответу «да» или «нет». По умолчанию порог равен нулю: запись считается поддельной, если вариант «подделка» для неё выше 50%. Порог можно сдвинуть ориентируясь на задачу. Для сравнения VeriSpoof с другими моделями поиска дипфейков порог не выбирают вручную, а используют EER (equal error rate). Порог сдвигают до точки, где доля пропущенных подделок среди всех подделок равна доле забракованных записей среди всех настоящих. Эту долю и называют EER. Например, EER 2.14% значит, что модель пропускает 2.14% подделок и по ошибке бракует 2.14% настоящих записей. Чем EER ниже, тем лучше: у модели, которая отвечает наугад, он равен 50%. В рейтингах вроде Speech-DF-Arena считают pooled EER: один общий порог на все наборы данных сразу, как будто модель работает с одной настройкой на любых записях.
Архитектура модели
Чтобы распознавать голосовые дипфейки, VeriSpoof объединяет две открытые модели: энкодер распознавания речи Qwen3-ASR и языковую модель MiniCPM5-2B. Языковая модель звуки не слышит, поэтому их связывает аудиотокенизатор. Весь путь записи выглядит так:
- Энкодер. Qwen3-ASR обрабатывает 8-секундный фрагмент записи. Признаки со всех 25 его слоёв складываются во взвешенную сумму, и веса этой суммы модель подбирает сама во время обучения;
- Аудиотокенизатор. Он превращает признаки в два набора токенов. 16 токенов описывают запись целиком: по ним модель узнаёт генератор и сравнивает записи. 52 токена соответствуют отрезкам по 0.16 с и сохраняют время: по ним модель ищет синтезированный фрагмент. Между ними каждые 0.8 с вставлены текстовые метки времени, поэтому модель может назвать интервал в секундах;
- Языковая модель. MiniCPM5-2B получает аудиотокены и текст вопроса. Если нужно сравнить две записи, в запрос кладут токены обеих;
- Ответ. Модель либо сразу оценивает варианты ответа, как описано выше, либо сначала пишет обоснование, а затем решение. Кроме того, небольшой классификатор поверх скрытых состояний языковой модели помечает каждый 0.16-секундный отрезок как настоящий или синтезированный, и получается профиль синтеза по времени.
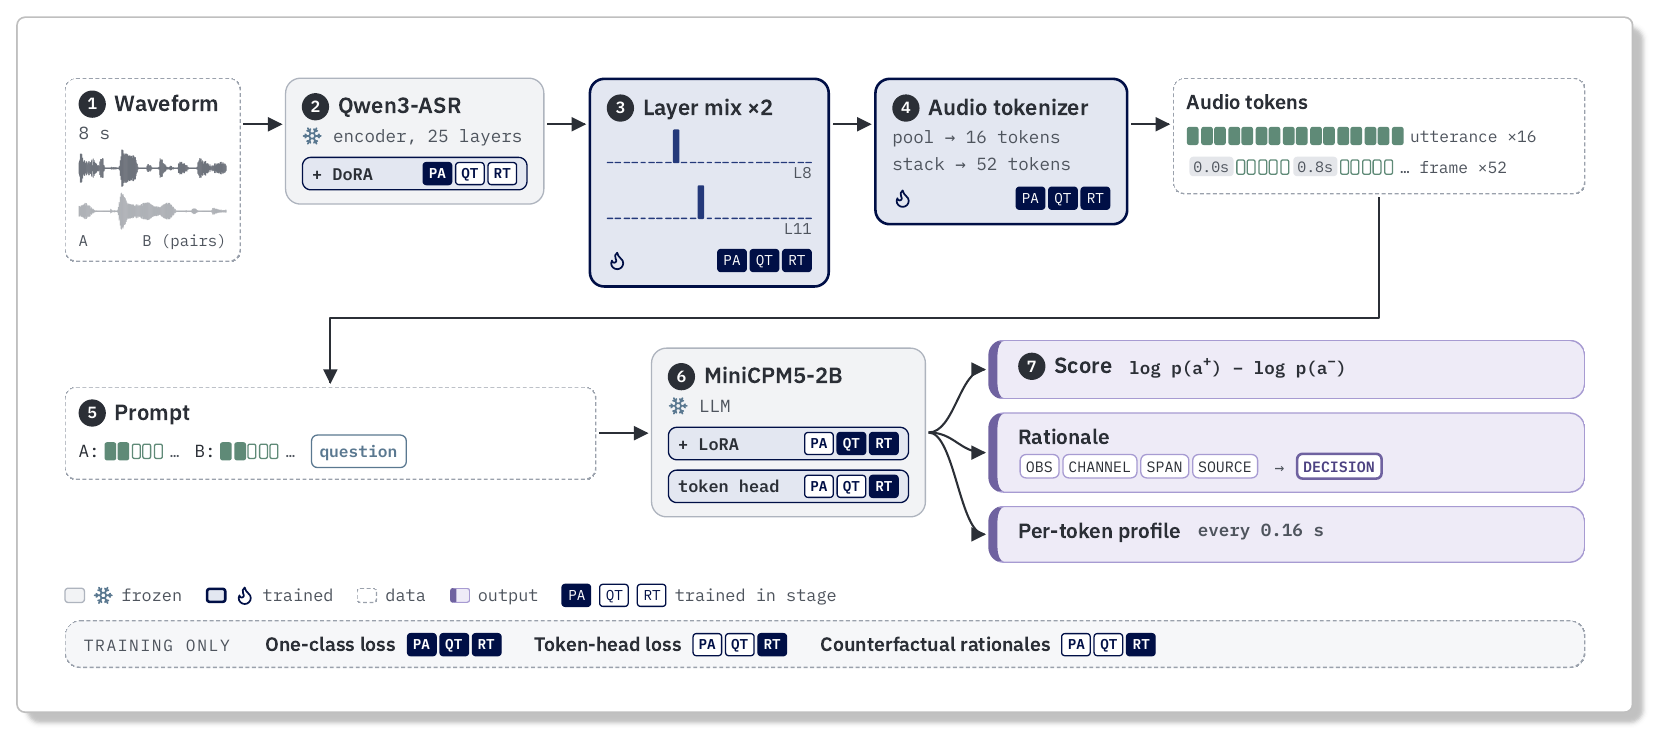
Из 2.85 млрд параметров обучаются только 29.7 млн: токенизатор, адаптеры DoRA в энкодере и LoRA в языковой модели. Обучение идёт в три этапа. Сначала при замороженной языковой модели настраивают токенизатор и энкодер на вопросах о подлинности, генераторе и условиях записи. Затем к языковой модели добавляют LoRA и учат её отвечать на все вопросы экспертизы. На последнем этапе модель учится писать обоснования, в том числе на контрфактических примерах. Обе версии проходят одни и те же этапы, но у Plus первый этап длиннее, а данные сбалансированы по 211 источникам подделок, чтобы крупные датасеты не перевешивали.
Решение, которое можно проверить
Обоснование состоит из фиксированных полей, и каждое проверяется без участия модели:
- OBSERVATIONS (полоса частот, SNR, громкость, клиппинг) по измерениям звуковой волны;
- CHANNEL_STATUS (шум, реверберация, кодек) по журналу аугментаций. На решение эти утверждения влиять не должны;
- LOCALIZATION (синтезированные интервалы в секундах) по разметке;
- SOURCE_PROFILE (метод генерации, акустическая модель, вокодер) по метаданным генератора.
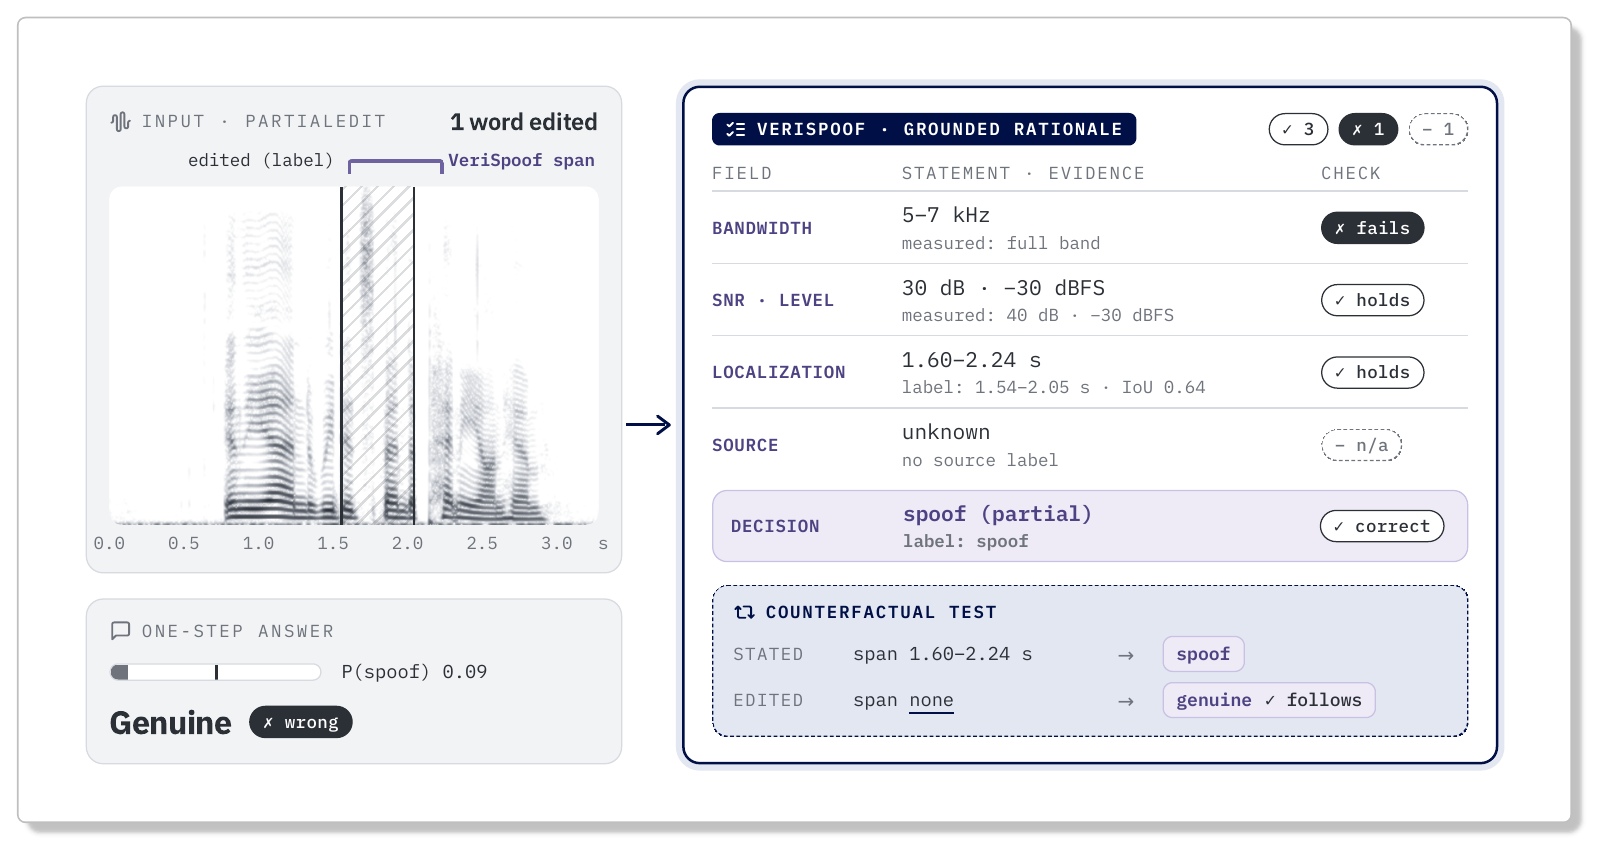
Последним идёт решение: запись определяется как поддельная, если указан хотя бы один сгенерированный интервал. Примеры обоснований для обучения не пишет другая нейросеть. Их собирает программа подготовки данных: она делает измерения прямо на том 8-секундном фрагменте, который слышит модель, а интервалы подделки и сведения о генераторе берёт из разметки датасета. Поэтому каждое утверждение в обучающих примерах заведомо верно.
Ещё нужно, чтобы решение действительно следовало из обоснования, а не принималось отдельно от него. Для этого в 20% обучающих примеров модели дают обоснование, где ответ о синтезированных фрагментах подменён на обратный: например, написано, что их нет, хотя они есть. Модель учат выдавать решение, которое следует из такого текста, то есть «настоящая речь». Писать ложные утверждения о записи её при этом не учат.
Голосовые дипфейки на лидербордах: лучший открытый результат
Официально на лидерборды авторы модели не отправляли. Они сами прогнали VeriSpoof на тех же тестовых наборах, что используют лидерборды: те же списки записей, те же метки и те же правила подсчёта метрик. Полученные цифры сравнили с опубликованными таблицами рейтингов, так что результаты VeriSpoof посчитаны самими авторами. На 2.34 млн записей Speech-DF-Arena впереди Plus только проприетарные Modulate VELMA-2 (1.59%) и Resemble 3B-Omni (2.10%), а Base с 4.43% обходит все остальные открытые модели. На 16 наборах SpoofRadar у Base и Plus 4.23% и 4.04% против 9.96% у лучшей открытой модели.
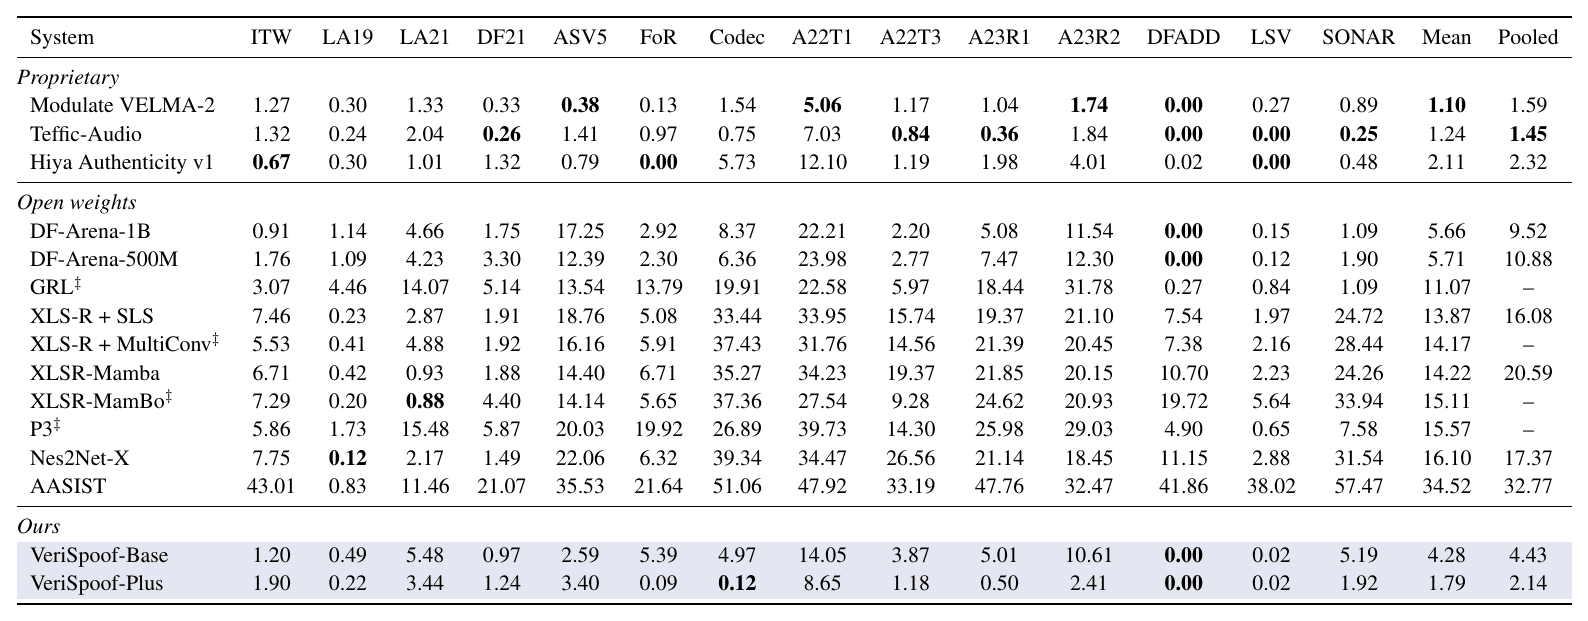
Важная оговорка для тех, кто хочет искать голосовые дипфейки в русской речи: при общем пороге SpoofRadar модель Plus признала поддельными 92.9% настоящих русских аудиокниг из XMAD-Bench, хотя внутри этого языка разделяет классы с EER не выше 1.95%. Base так ошибается не больше чем на 3.1% настоящих записей любого языка. Поэтому для нового языка или домена порог стоит подбирать на отдельно.
Источник записи и сравнение с аудио-LLM
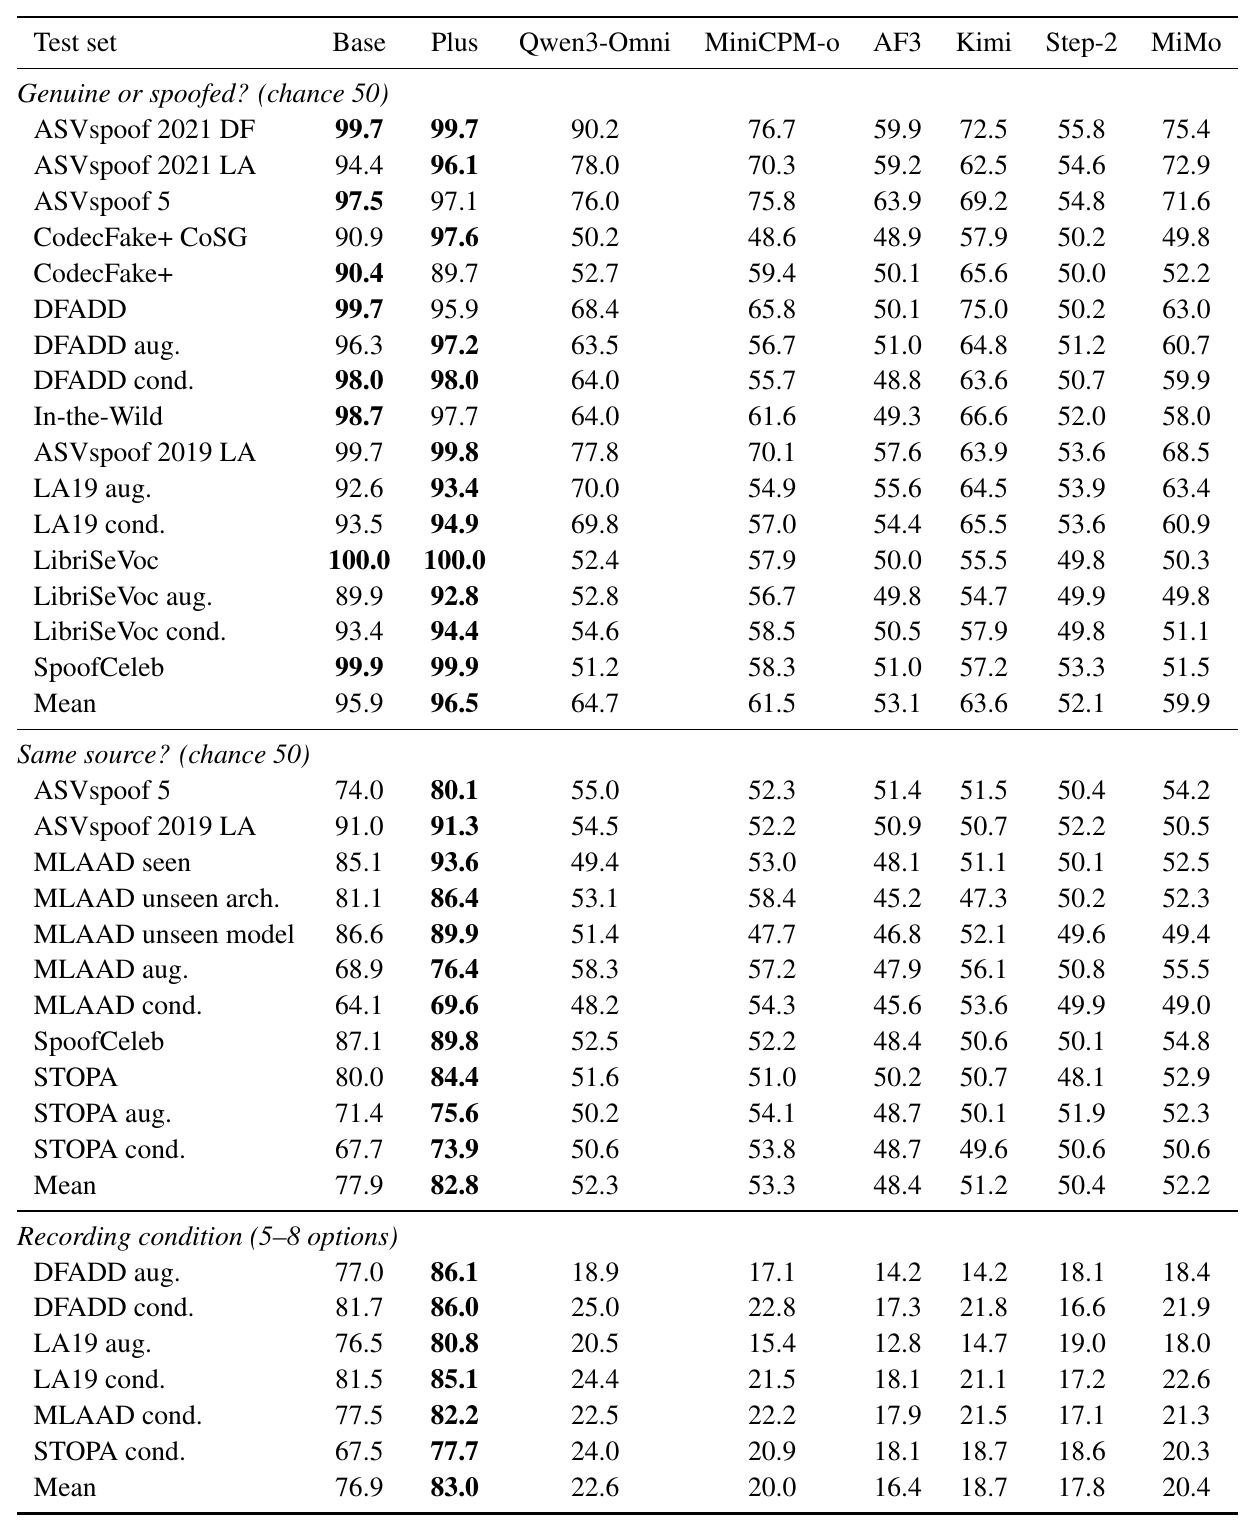
Для генераторов, которых не было в обучении, Plus определяет общий источник двух записей с EER 6.17%, если это новые модели известных архитектур, и 15.00% для новых архитектур. Для сравнения авторы обучили классификатор пар поверх замороженного энкодера DF-Arena-1B, и у него 26.5% и 24.8%. На копиях с шумом и кодеками EER растёт до 23-30%. Шесть универсальных аудио-LLM без дообучения, включая Qwen3-Omni и Audio Flamingo 3, отвечают на вопросы об источнике почти наугад: 48.4-53.3% сбалансированной точности при случайных 50%. Даже голосовые дипфейки они распознают заметно хуже VeriSpoof: в среднем 52.1-64.7% сбалансированной точности против 96.5% у Plus.
Рассуждение помогает точнее распознавать голосовые дипфейки
Прямой ответ оценивает запись целиком, а в рассуждении модель сначала ищет синтезированные интервалы кадр за кадром. На незнакомых генераторах MLAAD решение VeriSpoof-Base после рассуждения верно в 97.4% случаев против 85.8% у прямого ответа. Громкость в обоснованиях указана верно минимум для 95% записей, хуже всего с полосой частот (64-91%). Интервалы совпадают с разметкой с IoU 0.58-0.61, если фрагментов мало, и 0.25-0.31, если их много и они короткие.
Без контрфактического обучения модель, которой сказали, что синтеза нет, всё равно называла подделкой 42% незнакомых записей MLAAD. С ним решение следует перефразированной противоположной локализации, которой не было в обучении, в 99.5% случаев против 73.8%, а противоречия в утверждениях о канале и измерениях решение не меняют ни разу.
Что важнее: энкодер или LLM
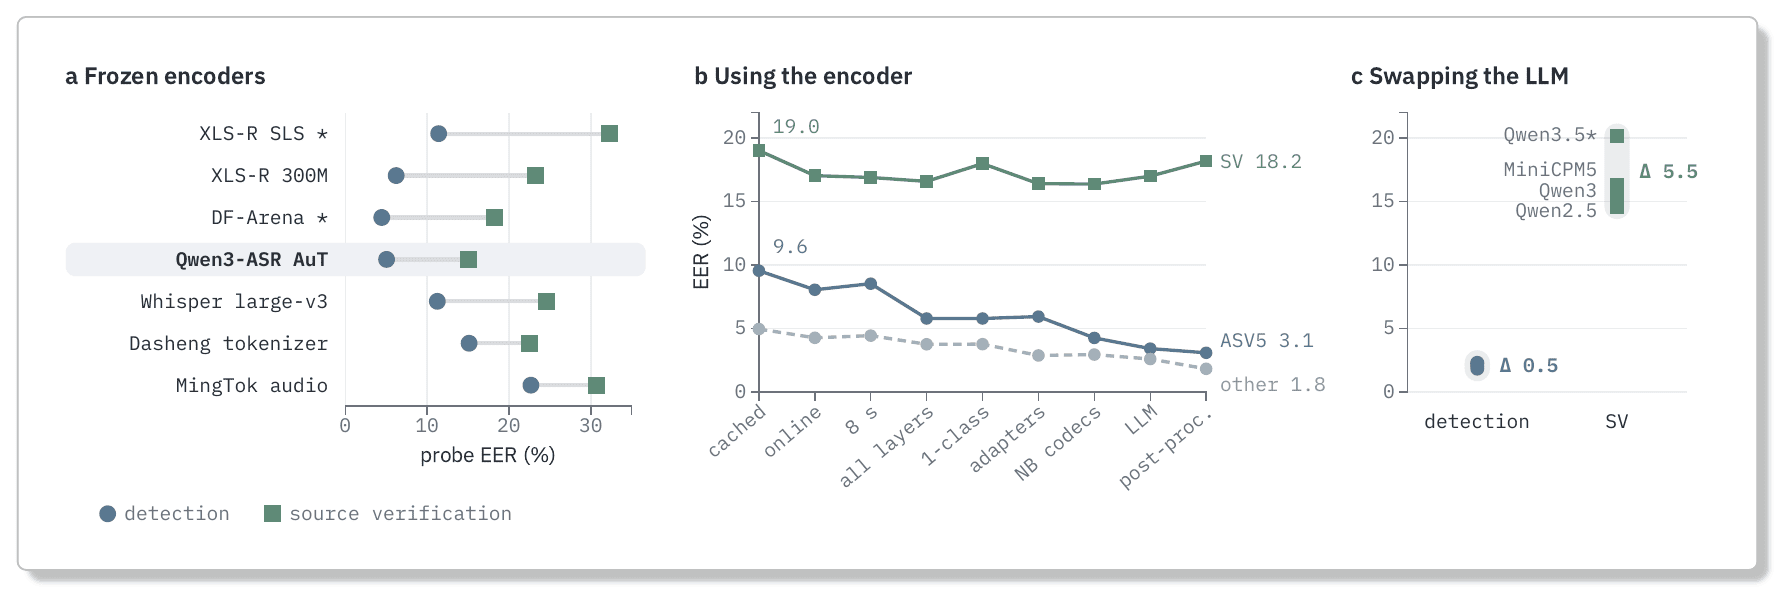
Среди семи замороженных энкодеров Qwen3-ASR лучше всех сохраняет признаки источника и почти не уступает лучшему антиспуфинг-энкодеру в детекции, так что артефакты синтеза он не выбрасывает. Если менять только то, как используются его признаки, EER на ASVspoof 5 падает с 9.56% до 3.10%, а EER проверки источника держится на 16-19%. Если менять только LLM, детекция сдвигается на 0.5 пункта, а проверка источника на 5.5. Для подделок, пересинтезированных нейрокодеками, вопросы об источнике обязательны: без них даже с впятеро большим числом меток подлинности EER на CodecFake+ 12.6% против 2.2%.
Ограничения и запуск
Для инференса на задачах с одной записью, по оценке авторов, хватит 6-7 ГБ видеопамяти, vLLM на A100 при батче из 64 записей пишет обоснование за 0.05 с на запись.
Есть и слабое место. На большинстве тестовых наборов вопросы об источнике записи помогают модели находить подделки или хотя бы не мешают. Исключение одно: ASVspoof 2021 LA, набор с соревнования ASVspoof 2021, где синтезированную речь пропускали через телефонные каналы. Если ту же модель учить только на вопросах «настоящая или подделка», её ошибка на этом наборе 1.77% EER, а с вопросами об источнике 3.40%. Ошибки приходятся на три типа атак, которых не было в обучении, а после обучения обоснованиям EER вырастает до 5.17%. Причину авторы пока не нашли: дело не в пороге и не в каком-то одном кодеке. Авторы предупреждают, что VeriSpoof не должна быть единственным основанием для решения.