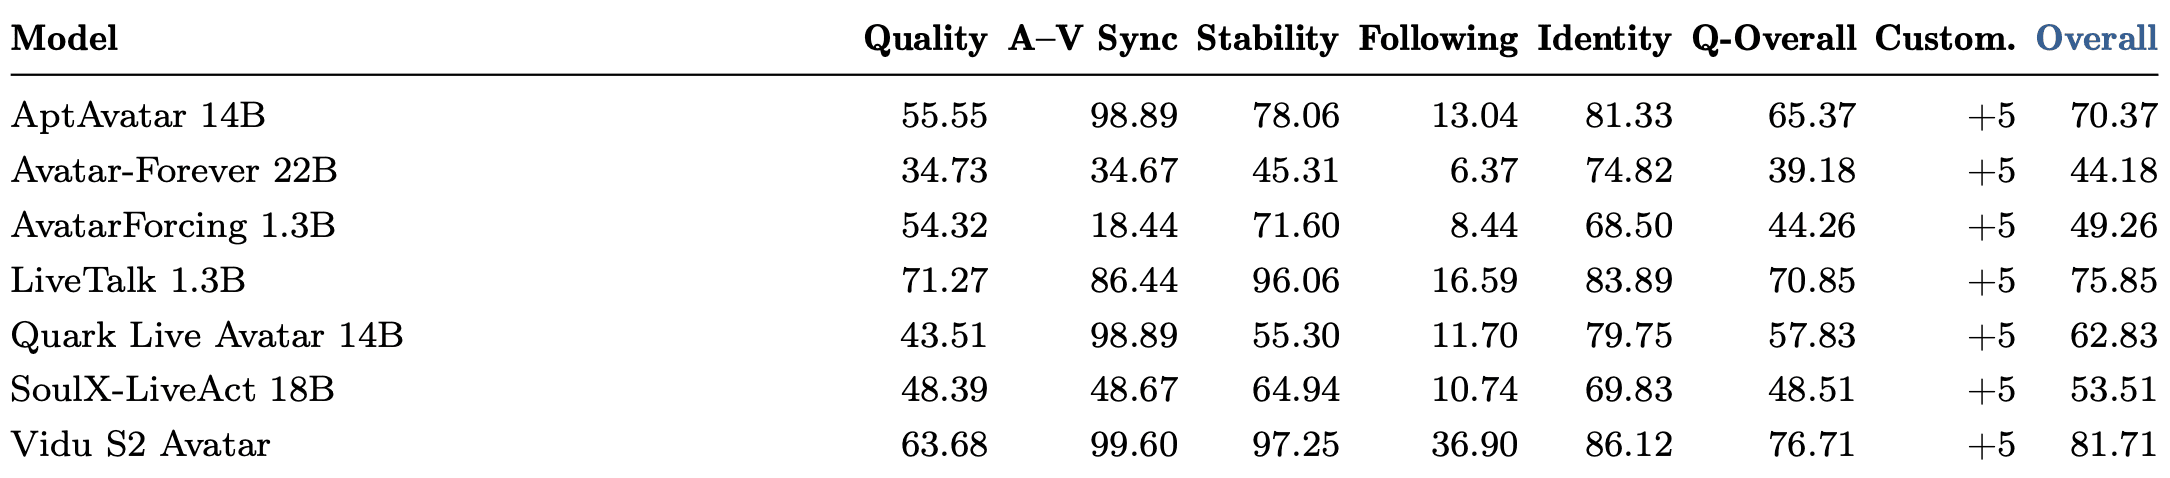
Исследователи из Tsinghua University, NVIDIA, CMU, UC Berkeley, Princeton, NUS и Reactor опубликовали StreamEval, бенчмарк, который проверяет, насколько хорошо нейросети для стримов генерируют видео в реальном времени: умеет ли модель выполнять запросы пользователя прямо во время стрима и при этом не ломать то, что уже есть в кадре. В бенчмарке 300 сценариев длиной от 15 до 300 секунд и пять типов задач, например, поговорить с цифровым аватаром, подменять расположение предмета или изменить форму объекта в кадре, переключить ракурс съемки. Авторы прогнали 37 моделей через StreamEval, и результаты пока далеки от идеала. Лучший результат выполнения команд у аватаров составил 36.90 из 100, у генерации мира по тексту 25.93, а полностью корректное редактирование по референсу удалось лучшей модели только в 15% случаев. При этом картинку те же модели держат хорошо. Так у Vidu S2 Avatar, лидера в задаче выполнения действий, стабильность видео составляет 97.25 из 100, а сходство аватара с исходным портретом 86.12 из 100 — модель уверенно сохраняет внешность персонажа и качество картинки. В то же время аватар правильно выполнял действие по запросу пользователя лишь в трети попыток. Проект открытый: код оценки опубликован на GitHub, тестовые сценарии с таймлайнами и медиафайлами выложены на Hugging Face, а результаты моделей собраны в лидерборде.
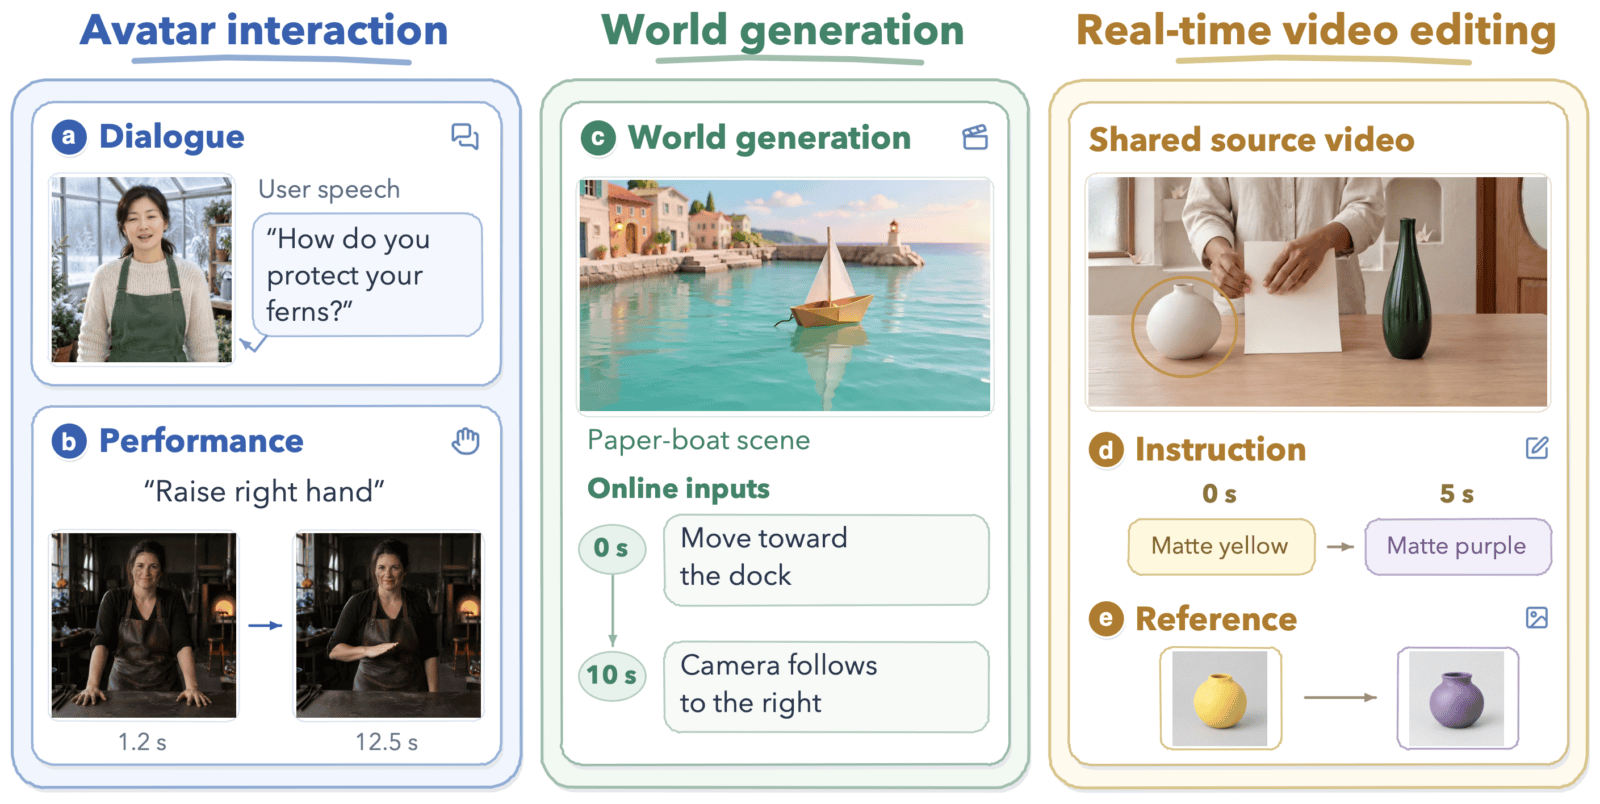
Чем нейросети для стримов отличаются от обычной генерации видео
Обычная text-to-video модель получает промпт один раз и выдаёт готовый ролик. Потоковые модели генерируют видео кадр за кадром (авторегрессионно), поэтому пользователь может вмешаться на середине: попросить аватара поднять руку, повернуть камеру в сгенерированном мире или перекрасить вазу в видео. Каждый такой запрос несёт три условия: когда изменение должно произойти, что именно поменять и что оставить нетронутым.
Существующие бенчмарки проверяют отдельные части этой задачи. VBench и EvalCrafter оценивают визуальное качество, WBench смотрит на многошаговое управление сгенерированным миром, LongV2VBench на редактирование длинных видео. StreamEval собирает аватаров, генерацию мира и редактирование в одном протоколе. Его 300-секундные сценарии редактирования в пять раз длиннее, чем в LongV2VBench, где максимум 60 секунд.
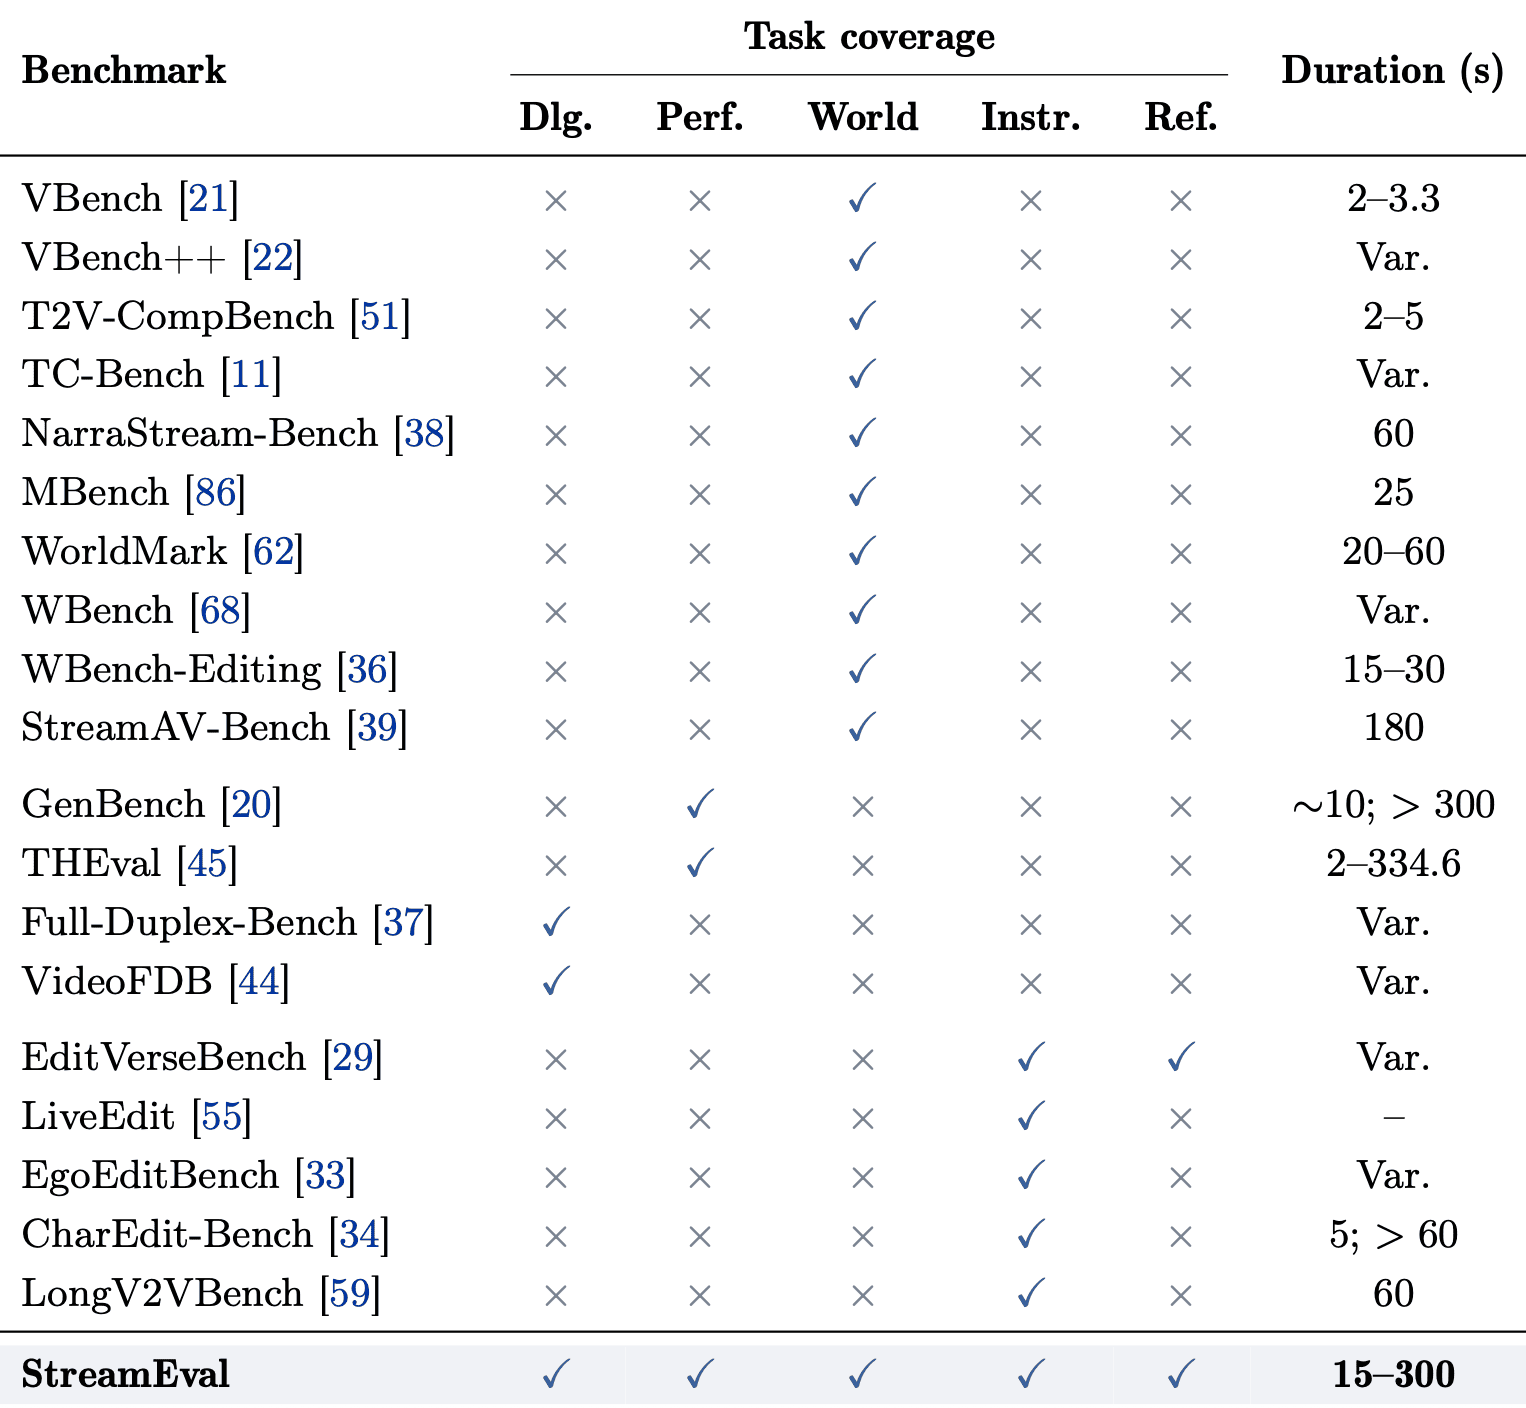
Как устроен бенчмарк StreamEval
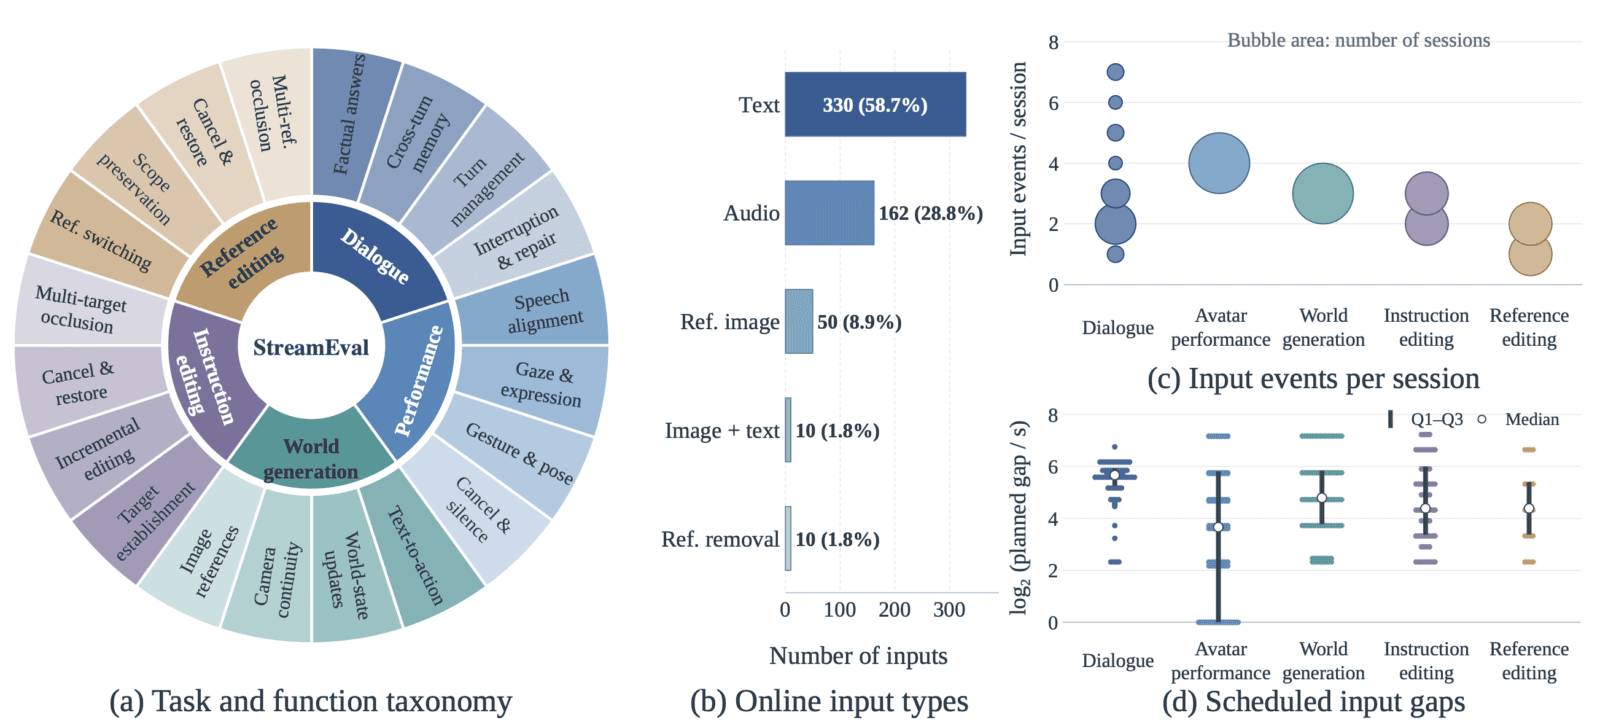
На каждую из пяти задач приходится по 60 сценариев:
- Диалог с цифровым человеком: аватар отвечает на речь пользователя по контексту, помнит историю разговора и корректно реагирует, если его перебили.
- Выполнение действий аватаром (avatar performance): аватар произносит заданный текст и одновременно выполняет команды вроде «посмотри влево» или «подними правую руку».
- Генерация мира (world generation): модель достраивает сцену в ответ на команды для объектов, действий и камеры.
- Редактирование по инструкции: модель меняет объект в идущем видео по текстовой команде.
- Редактирование по референсу: то же самое, но нужный внешний вид задаётся картинкой.
Сценарии распределены равномерно по длительности: по 12 штук на 15, 30, 60, 120 и 300 секунд. Всего в них 1347 запланированных онлайн-событий, а один полный прогон занимает 525 минут активной генерации. Планировщик выдаёт запросы по таймеру сессии постепенно, так что модель узнаёт о команде только в момент её поступления. Модель прогоняют по каждому сценарию три раза.
Сценарии видео и датасеты
Сценарии составляла Qwen3.8-Max: цели сессии, команды с таймингами, атрибуты, которые нельзя трогать, и ожидаемый результат. Портреты аватаров генерировали GPT-Image-2 и Qwen-Image (только синтетические взрослые или вымышленные персонажи), речь синтезировала Qwen3.5-Omni, в том числе с фоновым шумом и эхом. Для редактирования взяли лицензированные видео из Wikimedia Commons, NASA и Blender Studio без склеек, зацикливания и ускорения.
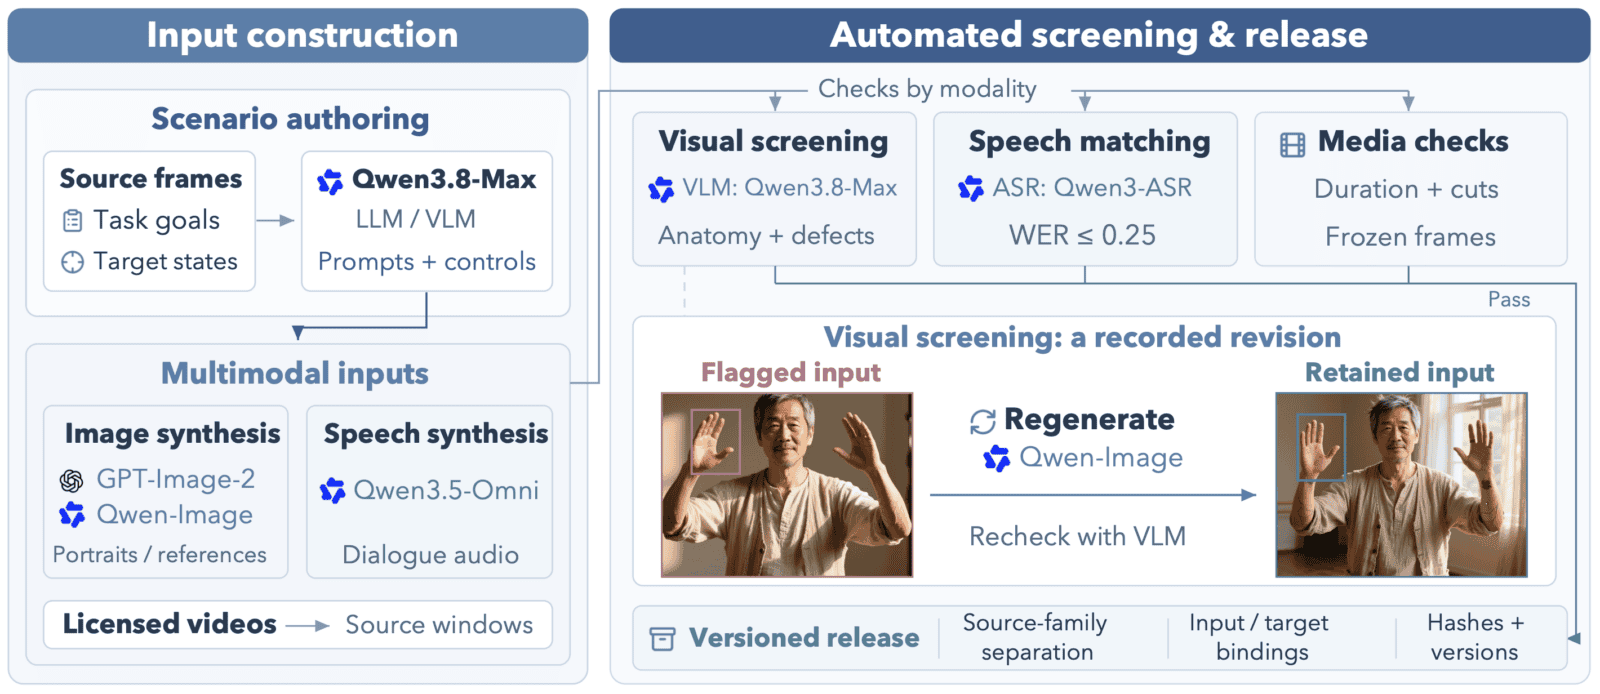
Как оценивают нейросети для стримов
Десять метрик по шкале от 0 до 100 распределены по четырем группам: качество выполнения задач (Dialogue, Following, Edit Success), согласованность состояния (Stability, Continuity, Preservation), визуальное качество (Quality, Identity, Reference) и аудиовизуальная синхронизация (A-V Sync). Например, Following считает, какую долю задач модель выполнила с правильным объектом. Edit Success строже: правка засчитывается, только если она появилась вовремя, затронула только нужную область, продержалась нужное время и не испортила остальной кадр. A-V Sync проверяет, совпадает ли движение губ с речью: насколько широко открыт рот в каждый момент сравнивают с тем, насколько громко в этот момент звучит голос.
Оценивают VLM-судьи (подход LLM-as-a-judge). Их заранее откалибровали на позитивных и негативных примерах: доля ложноположительных решений не выше 5%, ложноотрицательных и неопределённых не выше 10%. Для Identity берут меньшую оценку из двух судей (Qwen3.8-Max-0902 и Qwen3-VL-Plus), чтобы модель не выигрывала, подменив лицо похожим в том же стиле. Отсутствующий выход или неподдерживаемая операция дают 0 баллов. Итоговый балл Overall считается как среднее применимых метрик, а модели, которые позволяют загрузить собственный портрет аватара, получают бонус +5.
Результаты: картинка хорошая, послушание слабое
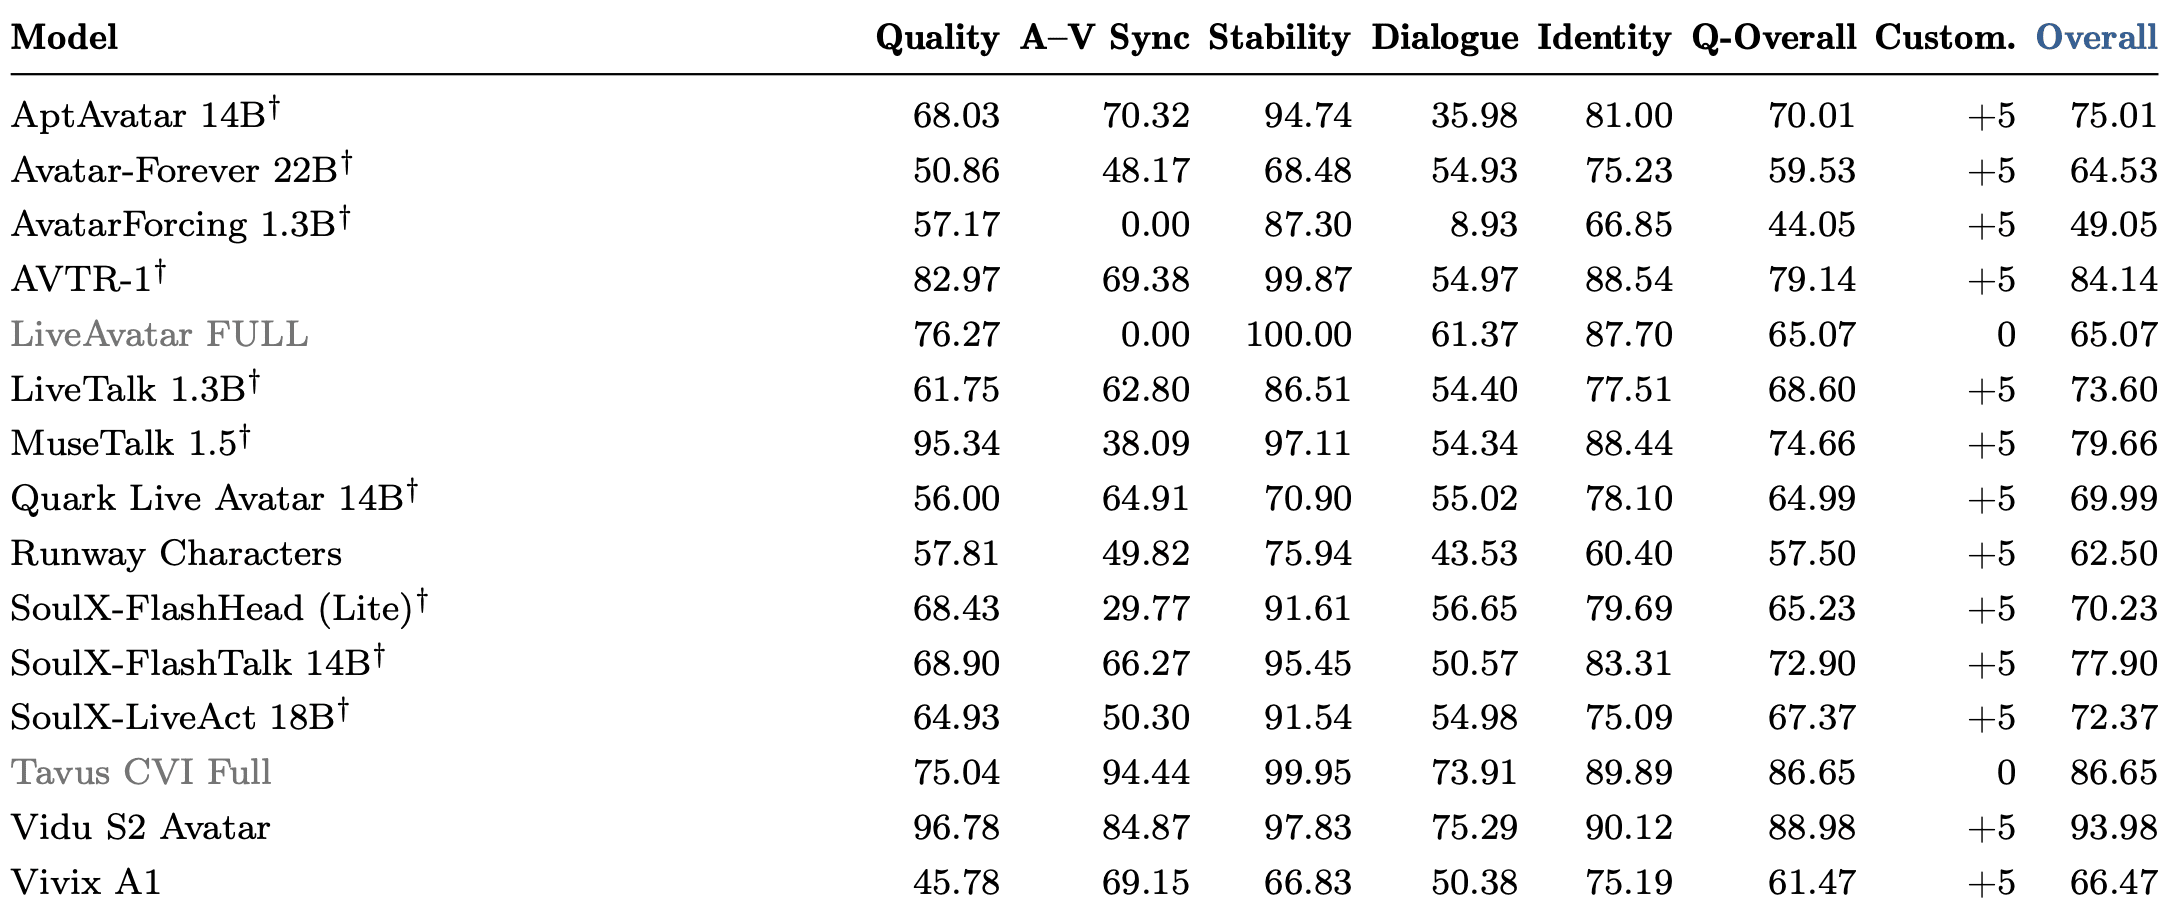
Аватары. В диалогах лидирует Vidu S2 Avatar: 93.98 Overall и лучший балл за сам диалог (75.29). Показательный случай MuseTalk 1.5: Quality 95.34 и Stability 97.11, но синхронизация губ всего 38.09.
В задаче выполнения действий разрыв ещё заметнее. У всех семи моделей Following находится в диапазоне от 6.37 до 36.90, хотя Identity у лидеров выше 80, а Stability выше 96.
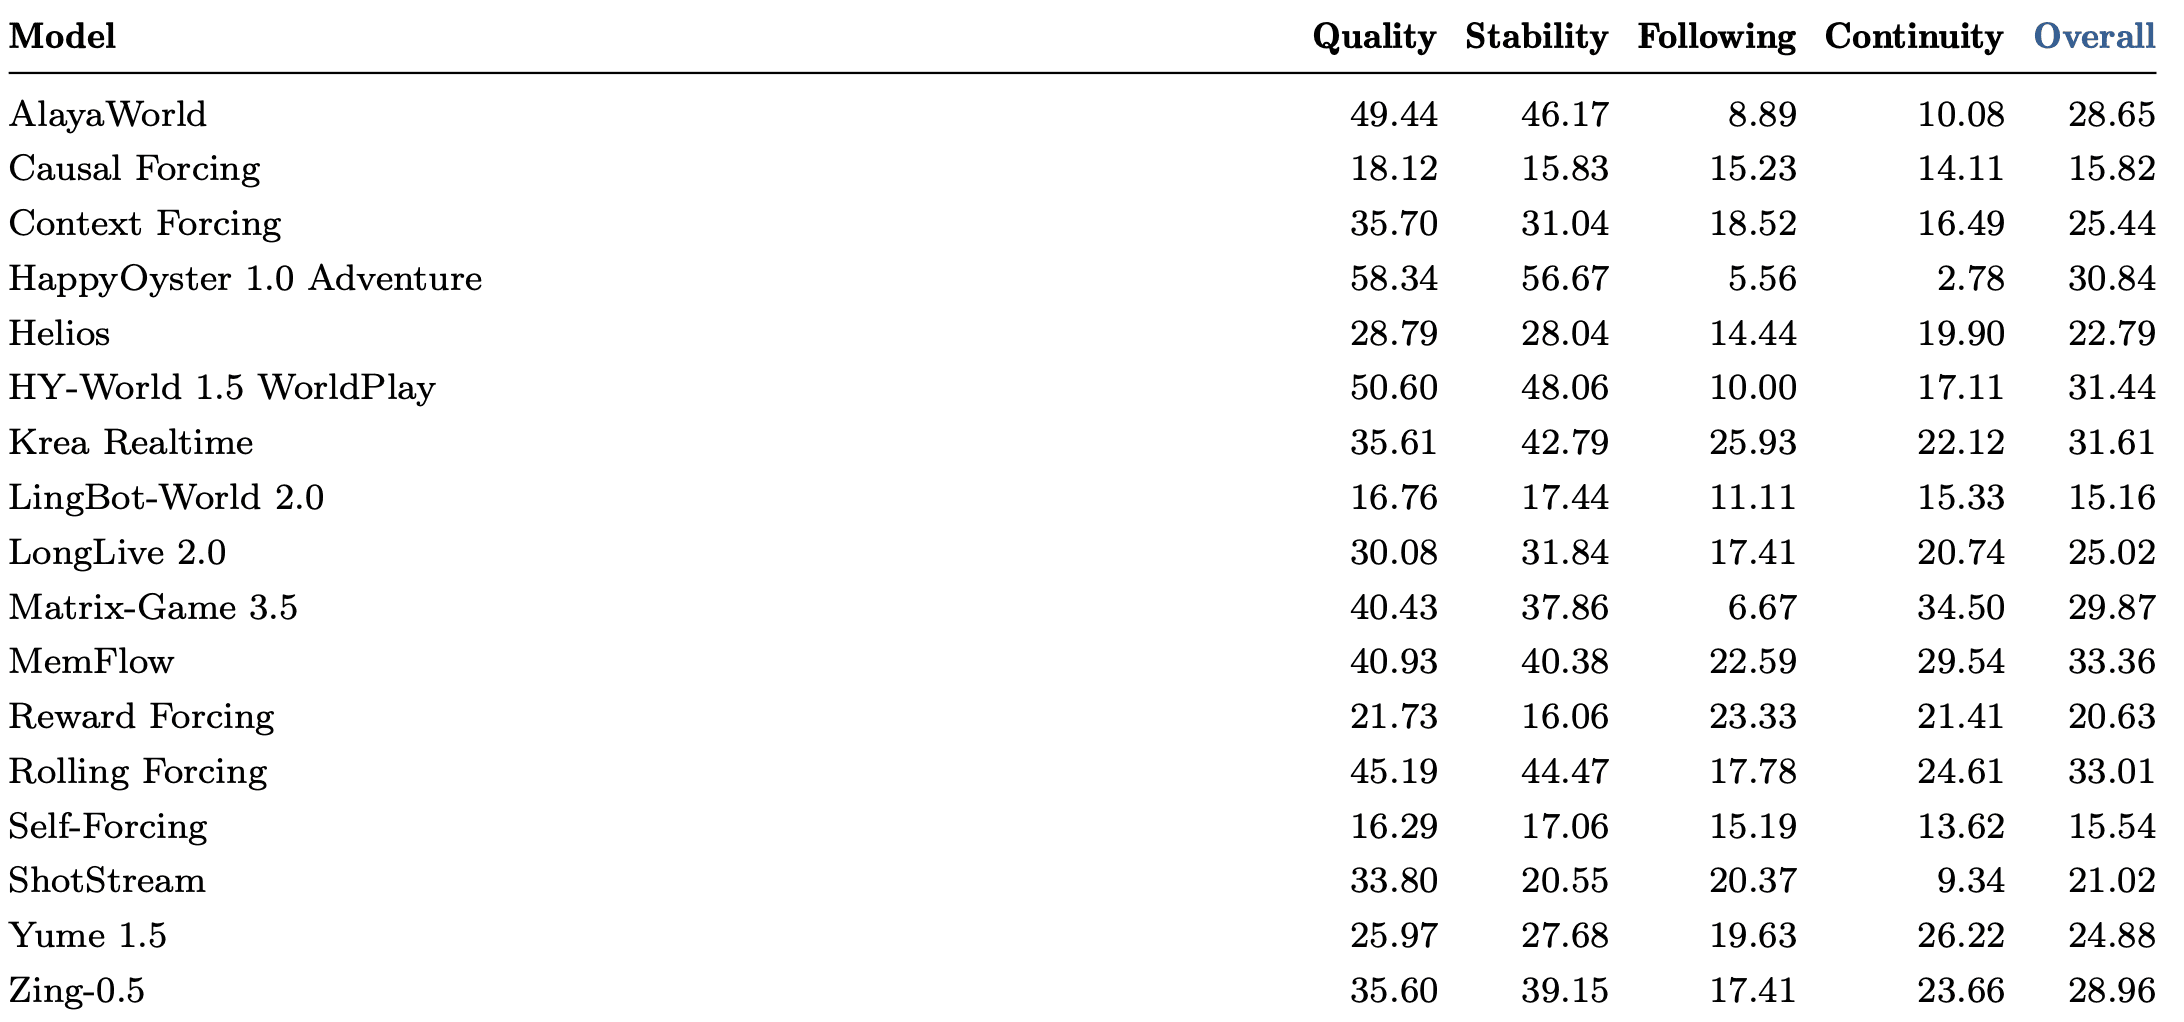
Генерация мира. Лучший Overall у MemFlow (33.36), следом идёт Rolling Forcing (33.01). HappyOyster 1.0 Adventure выдаёт самую качественную картинку (Quality 58.34), но выполняет только 5.56% команд, а её Continuity равна 2.78. Лучший Following среди 17 конфигураций у Krea Realtime: 25.93.
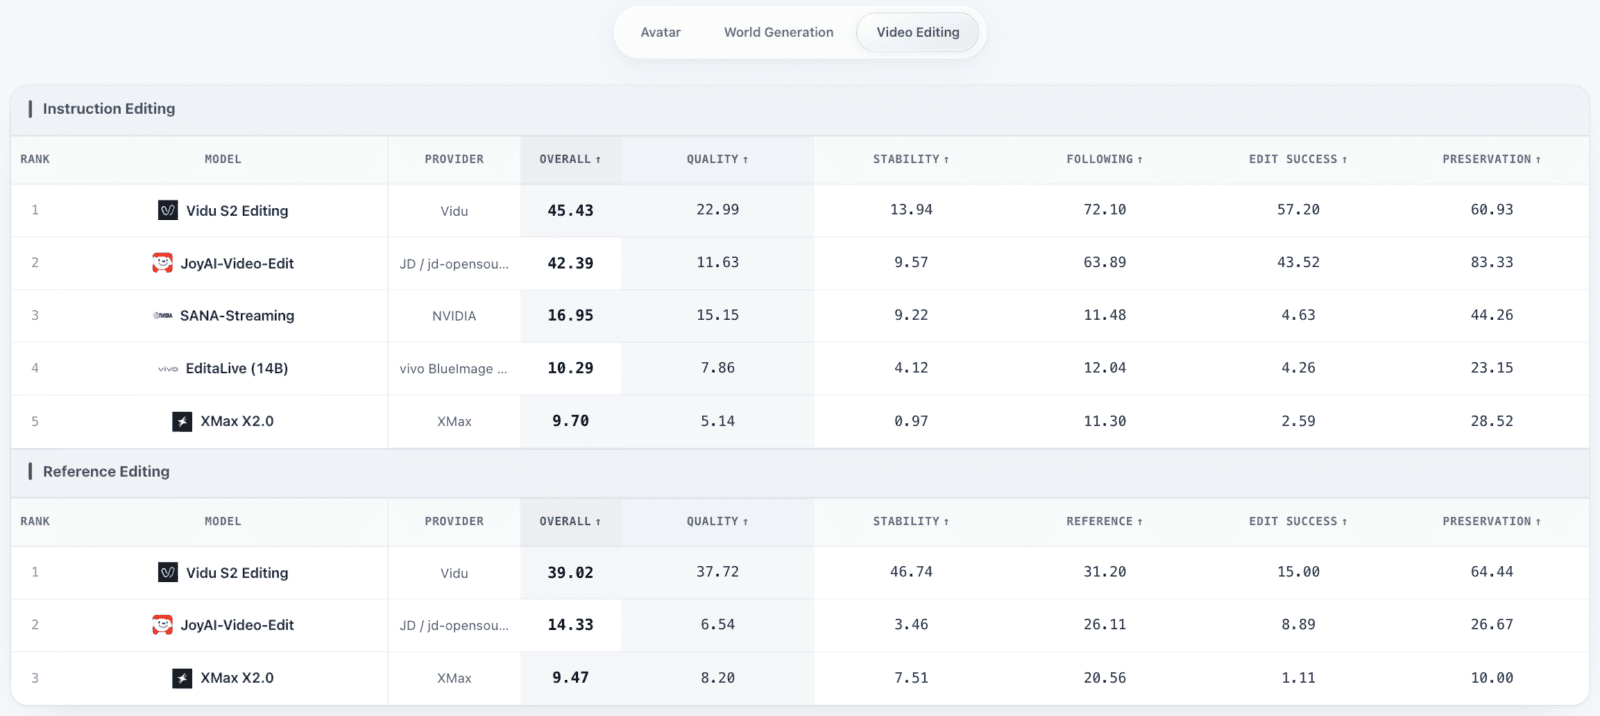
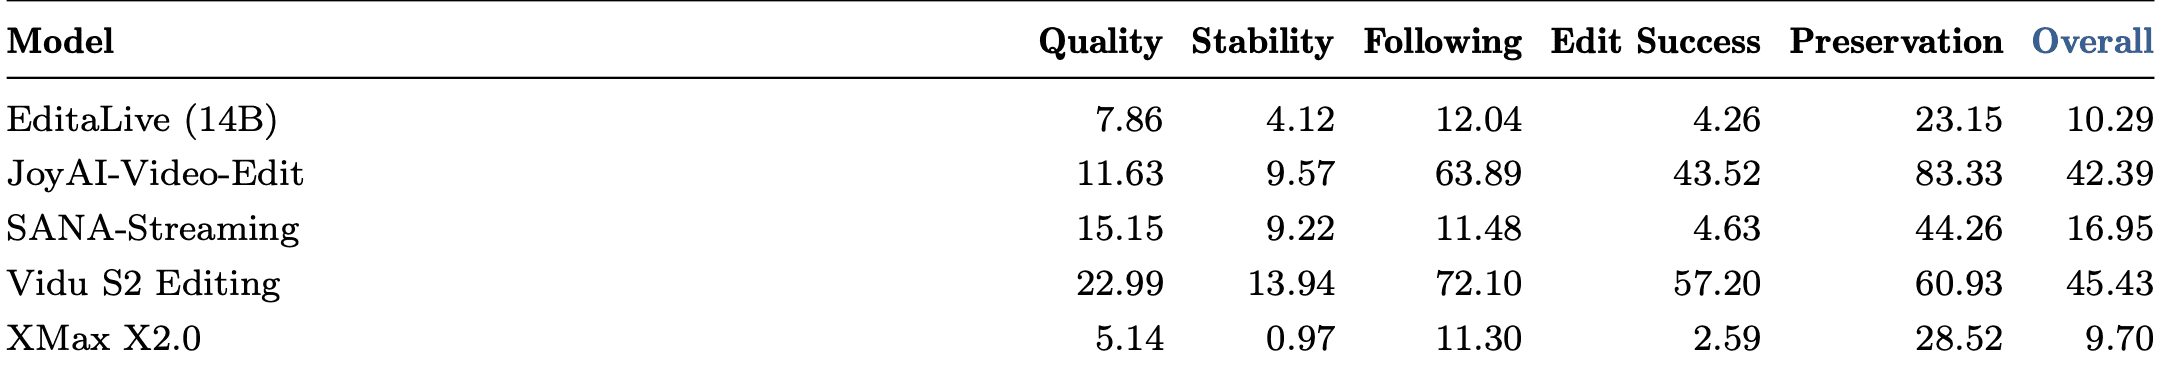
Редактирование. По инструкции лидирует Vidu S2 Editing с 45.43 Overall и Edit Success 57.20, а JoyAI-Video-Edit лучше всех сохраняет исходное видео (Preservation 83.33). При этом Quality даже у лучших моделей не поднимается выше 22.99.
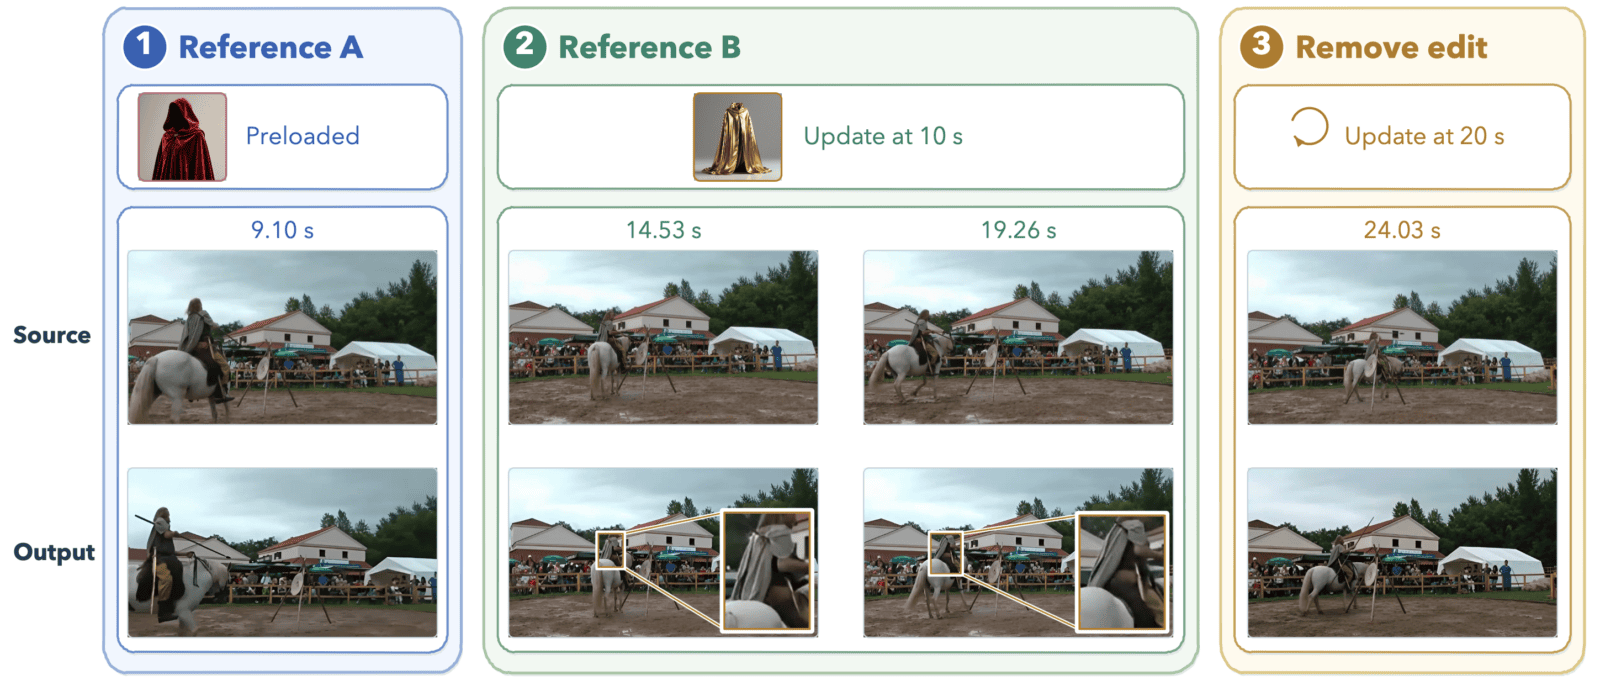
Редактирование по референсу оказалось самым трудным: максимальный Edit Success составил 15.00

Что именно идёт не так, видно на записанной сессии. Сначала модель должна одеть всадника в красный бархатный плащ, на 10-й секунде сменить его на золотой атласный, на 20-й убрать правку. Сцену модель сохраняет, но вместо золотого атласа оставляет исходный серый плащ.
Все оценки выставляют автоматические судьи, а сравнение с попарными оценками людей авторы называют следующим шагом. В таблицах редактирования показаны только конфигурации с Overall не ниже 5, и этот порог выбрали уже после оценки. Диалоговая задача не проверяет, видит ли модель пользователя через камеру. Ещё один нюанс: Jintao Zhang входит в команду StreamEval и одновременно указан первым автором статьи о Vidu S2, модели, которая лидирует в четырёх задачах из пяти.
Главный вывод авторов: нейросети для стримов упираются не в качество картинки, а в надёжное выполнение запросов с учётом тайминга и сохранения контекста. Модели уже умеют держать качество картинки и внешность персонажа на длинных сессиях, но пока плохо понимают, что, когда и где пользователь попросил изменить.