Открытые LLM

VeriSpoof: открытая аудио-LLM детектирует голосовые дипфейки с 98% точностью

Исследователи из University of Melbourne представили VeriSpoof — открытую аудиоязыковую модель (audio LLM) для выявления голосовых дипфейков (speech forensics). Она решает сразу пять задач, для которых обычно обучают отдельные модели.…
Hugging Face
Бенчмарки

Нейросети для стримов в бенчмарке StreamEval: лучшая модель справилась только с 15% правок по референсу

Исследователи из Tsinghua University, NVIDIA, CMU, UC Berkeley, Princeton, NUS и Reactor опубликовали StreamEval — бенчмарк, который проверяет, насколько хорошо нейросети для стримов генерируют видео в реальном времени: умеет ли…
Hugging Face
Открытые LLM

VideoJev: открытая модель отвечает на вопросы по видео с точностью режима Thinking, но в 100 раз быстрее

Исследователи из Nanjing University, JD.com и ещё шести китайских университетов представили VideoJev, семейство видеомоделей, которые отвечают на вопросы по видео в сотню раз быстрее моделей в режиме рассуждений (Thinking) и…
Hugging Face
Картинки и видео

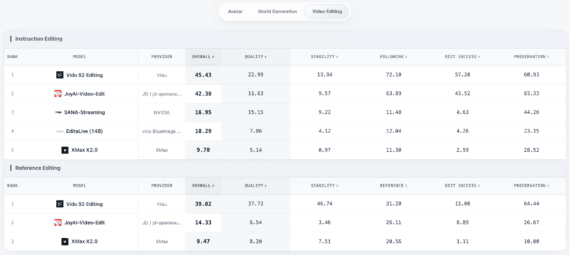
Vidu S2: модель генерирует видео-аватары в 720p при 25–42 FPS и редактирует часовые стримы на лету

Исследователи Tsinghua University и Shengshu Technology представили Vidu S2 — две видеомодели, с помощью которых можно создать цифровой аватар и провести с ним видеозвонок или запустить стрим, а видеопоток редактировать в реальном…
Hugging Face
Открытые LLM

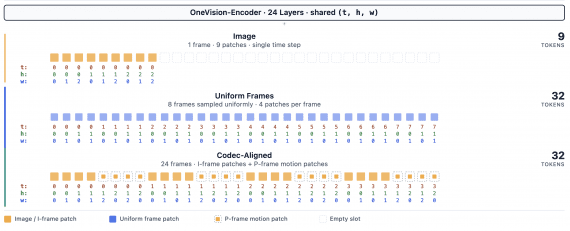
LLaVA-OneVision-2-8B: мультимодальная модель анализирует сжатый видеопоток через кодек вместо нарезки кадров

Исследователи из Glint Lab, AIM for Health Lab и MVP Lab опубликовали LLaVA-OneVision-2 (LLaVA-OV-2) — мультимодальную модель нового поколения, которая переосмысливает то, как нейросеть «смотрит» видео. Вместо того чтобы нарезать видео…
Hugging Face
Новости

Sound Effects: генерация звуков по описанию

Стартап ElevenLabs представил Sound Effects – платформу для генерации звуков и аудиосэмплов различного типа на основе текстового описания. Сервис позволяет создателям видео, игр и другого контента сократить время на самостоятельную…
State-of-the-art

Microsoft VASA-1: платформа для анимирования статичных изображений

Microsoft представила платформу VASA-1, преобразующую изображение человека и аудиозапись с речью в видео с синхронизированными движениями губ и головы. Алгоритм работает в реальном времени со скоростью 40 кадров в секунду.…
Новости

Sora: диффузионная text-to-image модель OpenAI

OpenAI представила Sora – диффузионную text-to-image модель, генерирующую видео длительностью 60 секунд. Ключевые преимущества модели OpenAI по сравнению с решениями конкурентов (включая Runway, Pika, Stability AI и Google) – высокое…
State-of-the-art

VideoPoet: языковая модель Google для генерации и редактирования видео

Google представила VideoPoet – языковую модель для мультимодальной работы с видеоконтентом, способную преобразовывать текст и изображение в ролики, стилизовать существующие видео и генерировать аудиодорожки к ним без подсказок. VideoPoet обучает…
Новости

Google MusicFX: создание музыки по текстовому запросу

Google запустил MusicFX – онлайн-сервис для генерации музыки по текстовому запросу. В продукте используется модель Google MusicLM, а каждый аудиофайл содержит незаметный для слушателя водяной знак, сгенерированный с помощью DeepMind…
Приложения

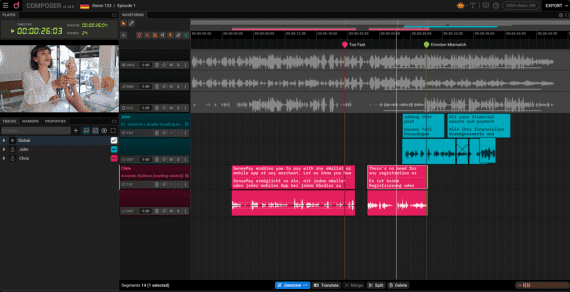
Deepdub Go и еще 5 нейросетей для дубляжа видео на 65 языков с копированием голоса диктора

Израильский стартап Deepdub анонсировал Deepdub Go – сервис автоматического дубляжа видео на 65 языков при помощи нейросети. Целевая аудитория платформы – студии разработки игр, рекламные агентства, платформы онлайн-обучения и другие…
State-of-the-art

AudioPaLM: мультимодальная модель от Google для голосового перевода

Google представила AudioPaLM — большую языковую модель для обработки и генерации речи, объединяющую две языковые модели от Google — PaLM-2 и AudioLM — в мультимодальную архитектуру. Модель умеет распознавать речь,…
State-of-the-art

AudioGPT: модель генерации звука из текста на основе трансформеров

AudioGPT — text-to-speech и text-to-audio модель от OpenAI, основанная на серии языковых моделей GPT. AudioGPT способна генерировать аудио-сэмплы с естественно звучащей речью, музыку и выполнять задачи классификации. Модель может оказать…
Новости

RunwayML: приложение для трансформации стиля видео

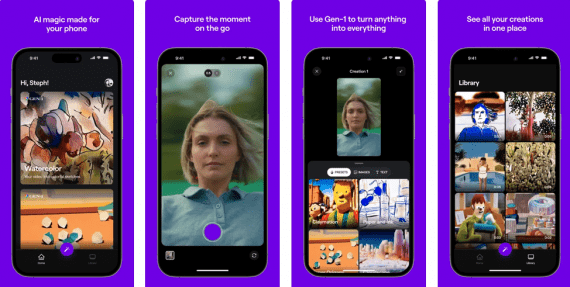
Стартап Runway выпустил мобильное приложение, позволяющее пользователем использовать свою image-to-image модель Gen-1. Приложение RunwayML трансформирует стиль видео на основе текстового запроса, изображения-референса или пресета. Список доступных пресетов включает такие текстуры,…
Приложения

Adobe добавила AI-инструменты в Premiere Pro и After Effects

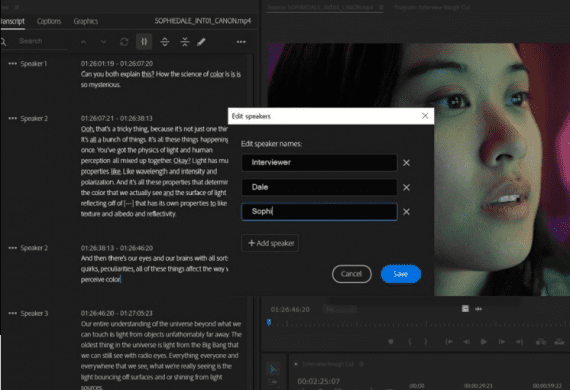
Adobe анонсировала новые версии Premiere Pro и After Effects, в которых добавлен AI-функционал, позволяющий ускорить редактирование видео. Среди новых инструментов – редактирование видео по автоматически сгенерированной транскрипции и автоподбор цветового…
Приложения

Cтартап MyInterview упрощает найм сотрудников с использованием обработки естественного языка

Myinterview – израильский стартап, разрабатывающий инструменты машинного обучения для ускорения и упрощения процессов найма для компаний. Алгоритмы расшифровывают видеоинтервью кандидатов, оценивает их навыки и выставляет оценку. Основатели утверждают, что Myinterview…
Приложения

Алгоритм UrbanDenoiser находит в 4 раза больше сигналов о землетрясениях

Исследователи Стэндфордского университета разработали алгоритм UrbanDenoiser для удаления фоновых шумов из данных, поступающих с датчиков сейсмической активности. UrbanDenoiser позволяет регистрировать в четыре раза больше сигналов землетрясений. Движение транспорта и работа…
Датасеты

Датасеты для генерации и анализа музыки

В статье приводится обзор датасетов с музыкальными произведениями. Датасеты разработаны для обучения моделей генерации, распознавания и анализа музыки. NSynth Крупнейший датасет, состоящий из 305 979 музыкальных нот, включая высоту звука,…
Новости

Deepdub: дубляж фильмов с помощью нейросети

Израильский стартап Deepdub разработал алгоритм дубляжа фильмов с использованием синтетических голосов генерируемых нейросетью. Инструменты компании позволяют скопировать оригинальный голос актера и сократить расходы на озвучивание. Update: Deepdub Go запустил ИИ…
Приложения

DeepBrain показала аватары для коммуникации с клиентами

На выставке CES 2022 компания DeepBrain представила фотореалистичных аватаров, которые предлагается использовать компаниям для коммуникации с клиентами. Аватары сгенерированы на основе нескольких сотен часов видео реальных людей. Аватары DeepBrain способны…
Новости

FaceHeart: измерение медицинских показателей по видеозаписи лица

Корпорация FaceHeart объявила о запуске технологии, способной определять 6 медицинских показателей, включая уровень кислорода в крови и индекс стресса, с помощью камеры смартфона. В FaceHeart утверждают, что точность их системы…