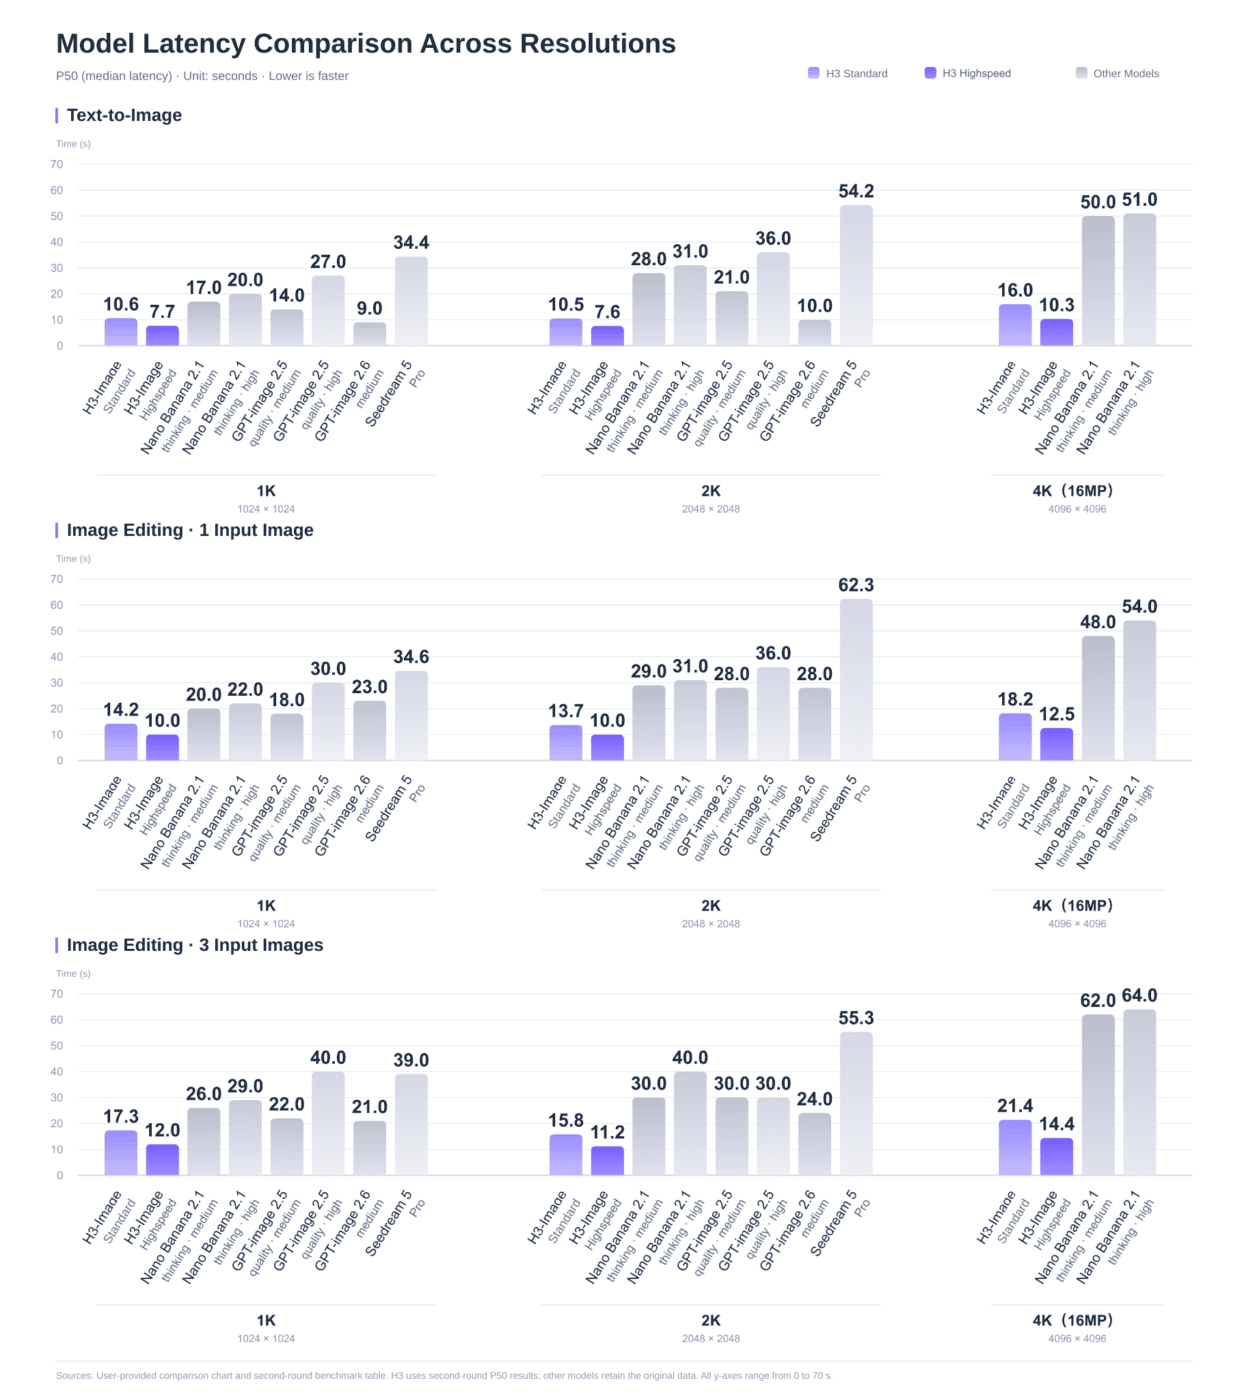
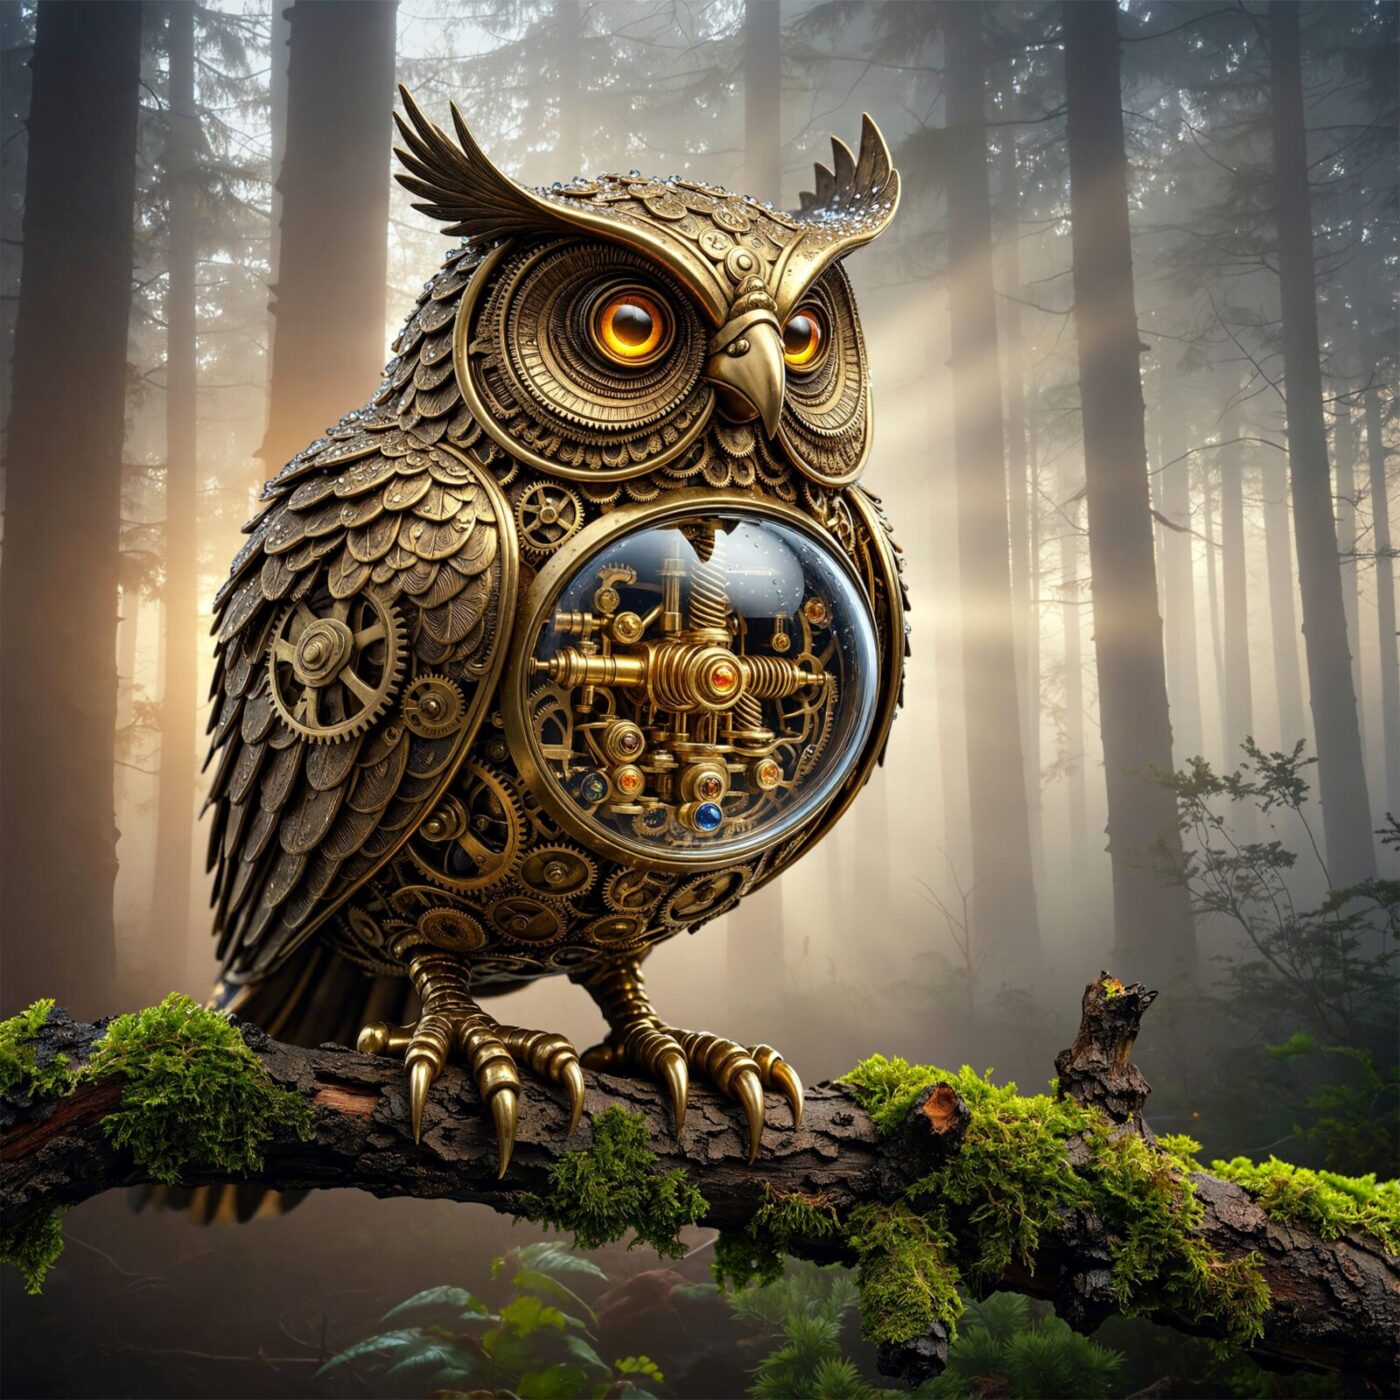
Компания MiniMax выпустила MiniMax H3-Image — модель с открытыми весами для генерации и редактирования изображений. Модель генерирует картинки по текстовому описанию и редактирует готовые изображения, принимая на вход до 16 референсов. Модель выдаёт картинки около 16 мегапикселей (4096×4096, а для формата 21:9 6272×2688) без отдельного апскейлера и тратит на это всего 6 шагов сэмплирования. На графике медианной задержки API, который приводит MiniMax, 4K-картинка по тексту генерируется за 16 секунд в стандартном режиме и за 10.3 с в режиме Highspeed, а у Nano Banana 2.1 на то же разрешение уходит 50-51 с. Одна 4K-картинка через API стоит $0.069, а в неделю запуска вдвое дешевле.
Открыты веса диффузионного трансформера на 33.1 млрд параметров, вариационного автоэнкодера (VAE) и расширителя промптов, плюс инструкции для запуска в SGLang, vLLM-Omni, diffusers и ComfyUI. Технического отчёта, метрик качества и обучающих датасетов MiniMax не публиковала, а лицензия не действует в ЕС, Великобритании, Южной Корее и США. Веса модели и расширителя промптов лежат на Hugging Face, код и примеры на GitHub, попробовать модель можно в демо и через API.
Что внутри MiniMax H3-Image
MiniMax H3-Image построена на H3, видеомодели компании, которая вышла летом и генерирует ролики со звуком. Из неё убрали аудиоветку и дообучили оставшуюся часть на изображениях. Текстовым энкодером служит Qwen3-VL из H3 без изменений: трансформер берёт скрытые состояния его 50-го слоя, а не выход последнего.
Картинку сжимает VAE со свёрточным энкодером и декодером на основе 2D ViT из 24 слоёв. Он уменьшает изображение в 16 раз по каждой стороне и хранит 24 канала латентного представления. Дальше латенты режутся на патчи 2×2, поэтому один токен соответствует квадрату 32×32 пикселя, и картинка 4096×4096 превращается в 16 384 токена. Генерирует латенты плотный (dense) однопоточный диффузионный трансформер (DiT) на 33.1 млрд параметров: 50 слоёв, размер скрытого слоя 5376, 56 голов внимания, позиционное кодирование 3D MM-RoPE. Токены текста и всех референсных изображений собираются в одну последовательность, и трансформер по ней предсказывает латент итоговой картинки. Поэтому генерация по тексту и редактирование работают в одной модели без отдельных адаптеров.
О дообучении MiniMax пишет только в общих словах: изменения затронули данные, обучение с подкреплением (RL) и сокращение числа шагов. Модель дистиллирована до 6 шагов (6 NFE) без classifier-free guidance. Число шагов и guidance scale поменять нельзя, а negative prompt не поддерживается.
Скорость: 4K за 10-16 секунд
В блоге MiniMax обещает 4K-картинку меньше чем за 10 секунд и скорость до 5 раз выше, чем у популярных аналогов. На графике медианной задержки (P50) через API цифры скромнее: 4K по тексту занимает 16.0 с в режиме Standard и 10.3 с в Highspeed, с одним референсом 18.2 и 12.5 с, с тремя 21.4 и 14.4 с. Из конкурентов на 4K на графике есть только Nano Banana 2.1, и ей нужно 48-64 с.
На маленьких разрешениях преимущество не такое однозначное. Для 1K стандартный режим MiniMax H3-Image (10.6 с) медленнее GPT-image 2.6 в режиме medium (9.0 с), и обгоняет его только Highspeed (7.7 с). Ещё одна оговорка из сноски к графику: H3-Image измеряли повторно, во втором раунде тестов, а для остальных моделей оставили цифры из исходного сравнения.
Что умеет модель
Модель рассчитана на большие картинки: MiniMax советует размеры от 4 МП (2048×2048) до 20 МП, а лучший результат она даёт около 16 МП, то есть 4096×4096. Маленькие изображения модель по умолчанию всё равно генерирует не меньше 2048×2048. Промпт обрезается до 4096 токенов, и модель ждёт подробное описание на английском. Короткий запрос можно развернуть расширителем промптов H3-Image-PE: это Qwen3.8-27B в формате NVFP4 весом 17.9 ГБ, он переписывает короткий запрос в детальное описание и сам выбирает соотношение сторон.
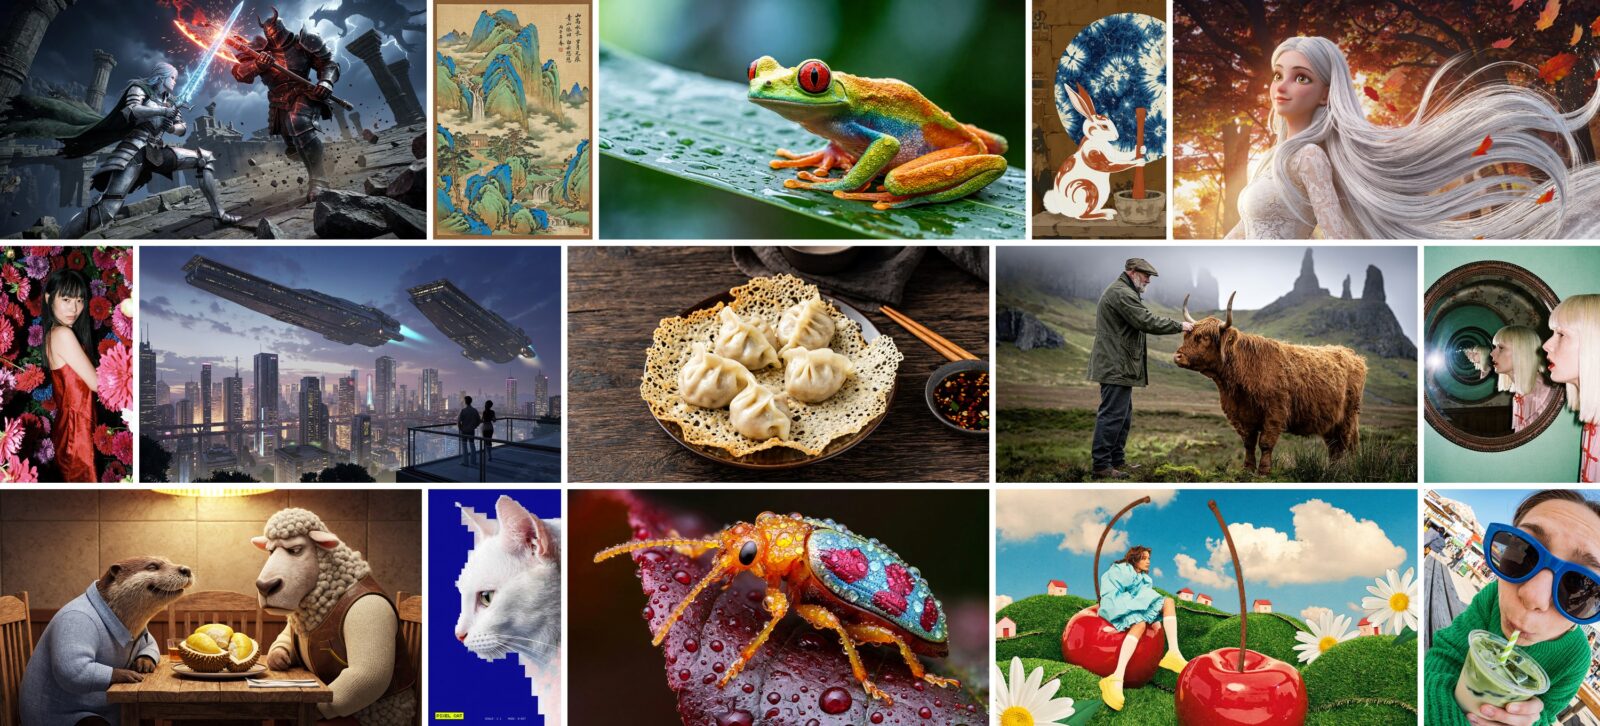
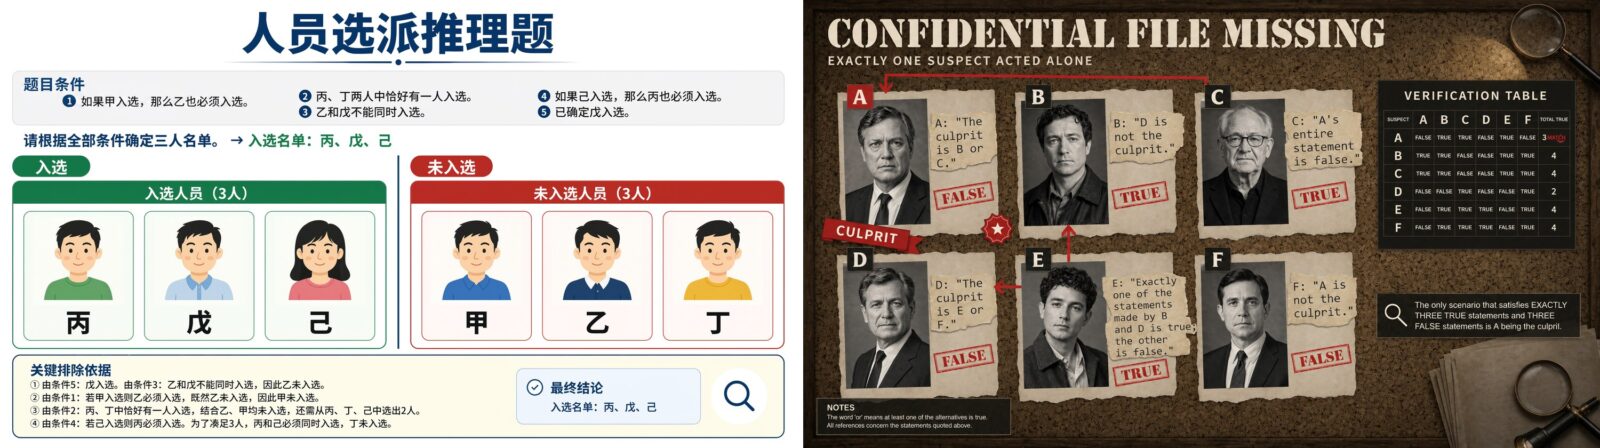
Главная заявленная особенность MiniMax: лучшее следование инструкциям (prompt adherence) среди открытых моделей. В README это показывают на примерах, например на досках с логическими задачами на китайском и английском, где модель должна не только аккуратно отрисовать текст, но и правильно решить задачу.
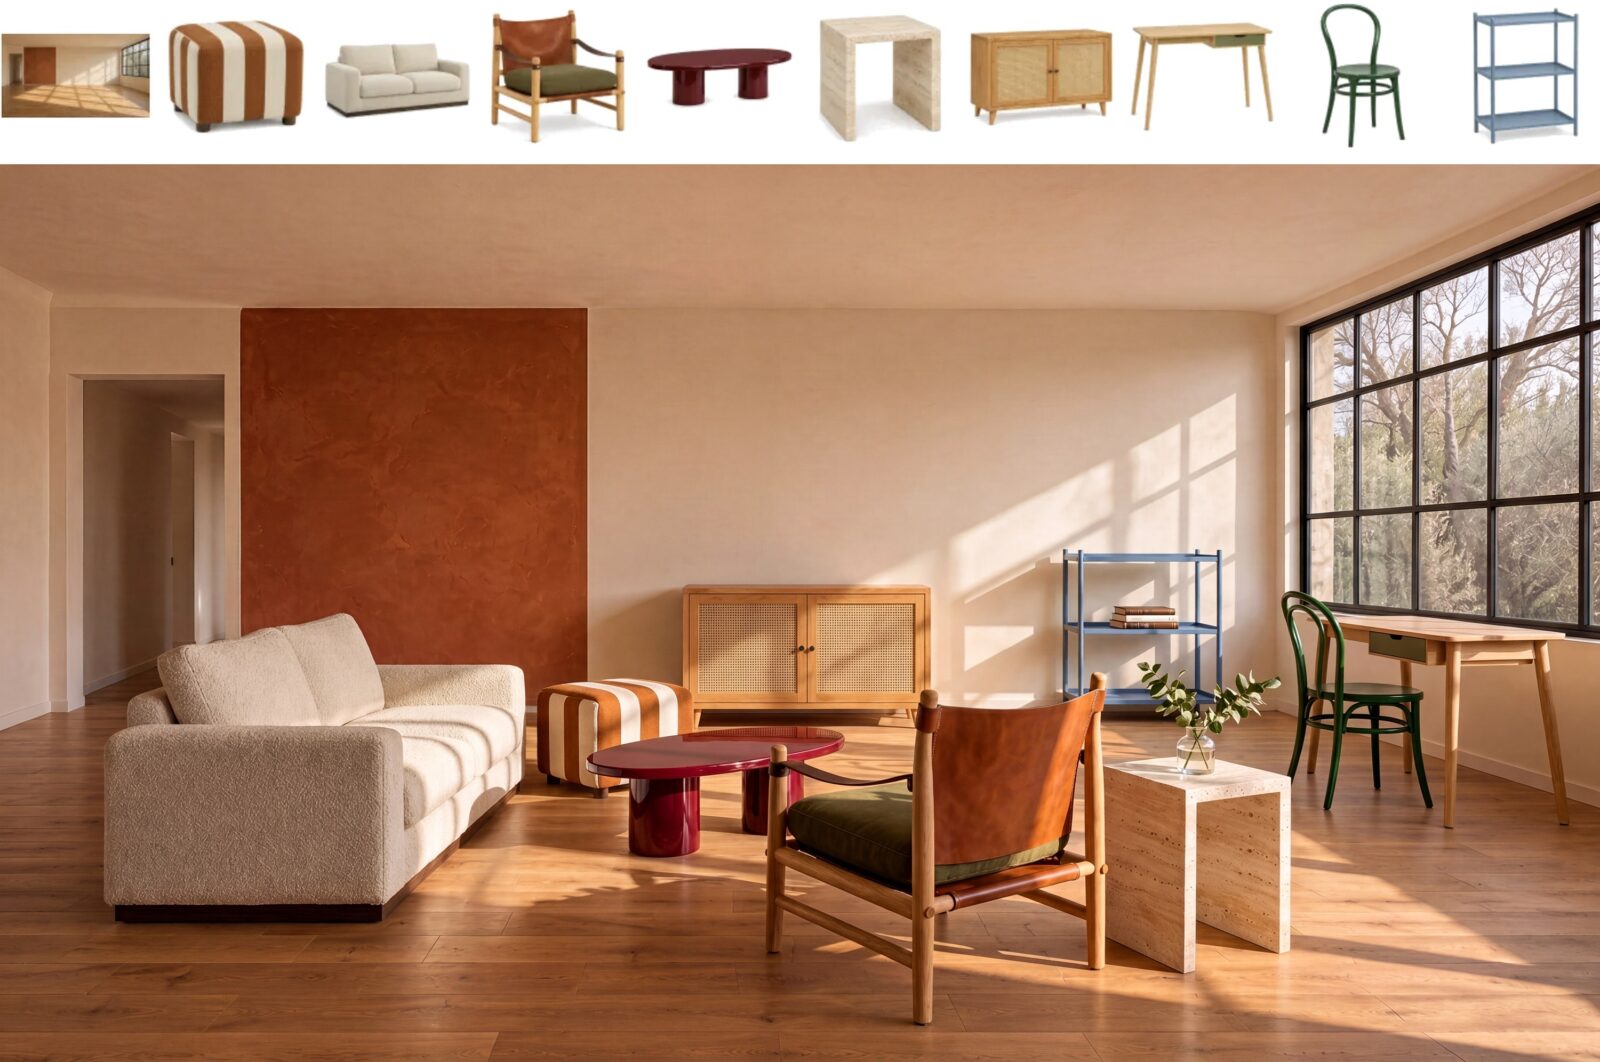
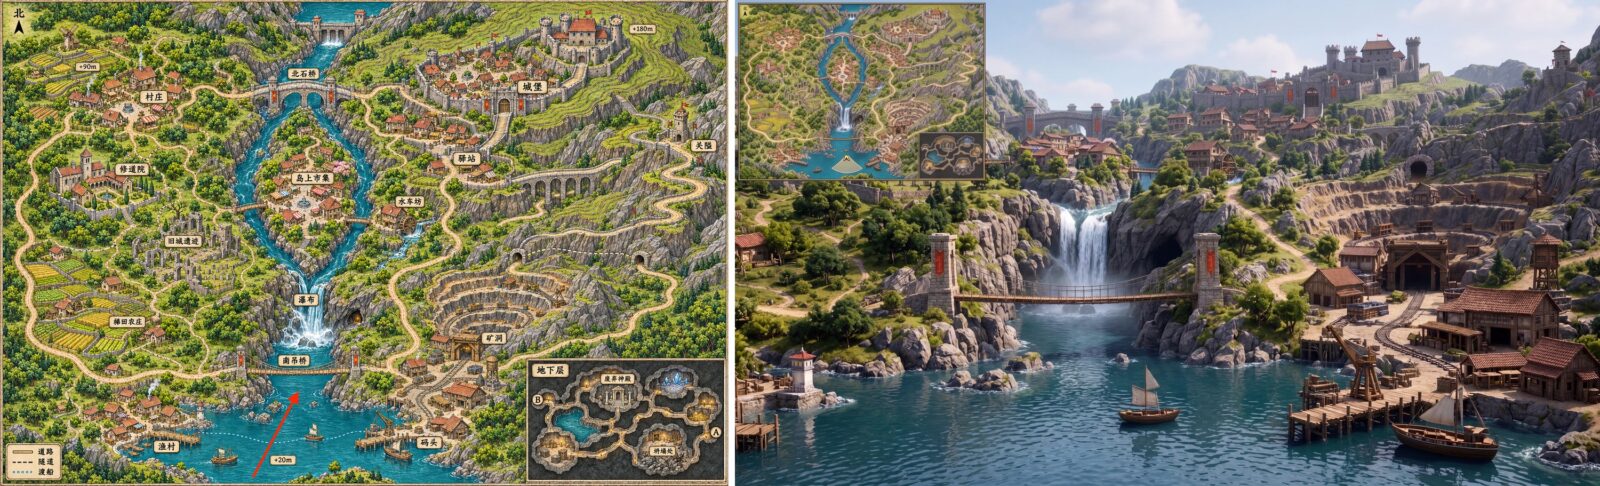
При редактировании референсы нумеруются в порядке загрузки, и в промпте на них ссылаются как на <Picture 1>, <Picture 2> и так далее. Самый наглядный пример: пустая комната и девять предметов мебели на отдельных фото, из которых модель собирает обставленную гостиную. В другом примере по нарисованной карте игрового мира со стрелкой модель строит вид от первого лица из отмеченной точки.
Сколько стоит и на чём запускать
Через API генерация по тексту стоит $0.022 за 1K, $0.023 за 2K и $0.069 за 4K. Режим Highspeed быстрее, но почти вдвое дороже: $0.130 за 4K. До 17 ноября 2026 года на 4K действует скидка 50%. По словам MiniMax, это 50-70% от цены сопоставимых сервисов.
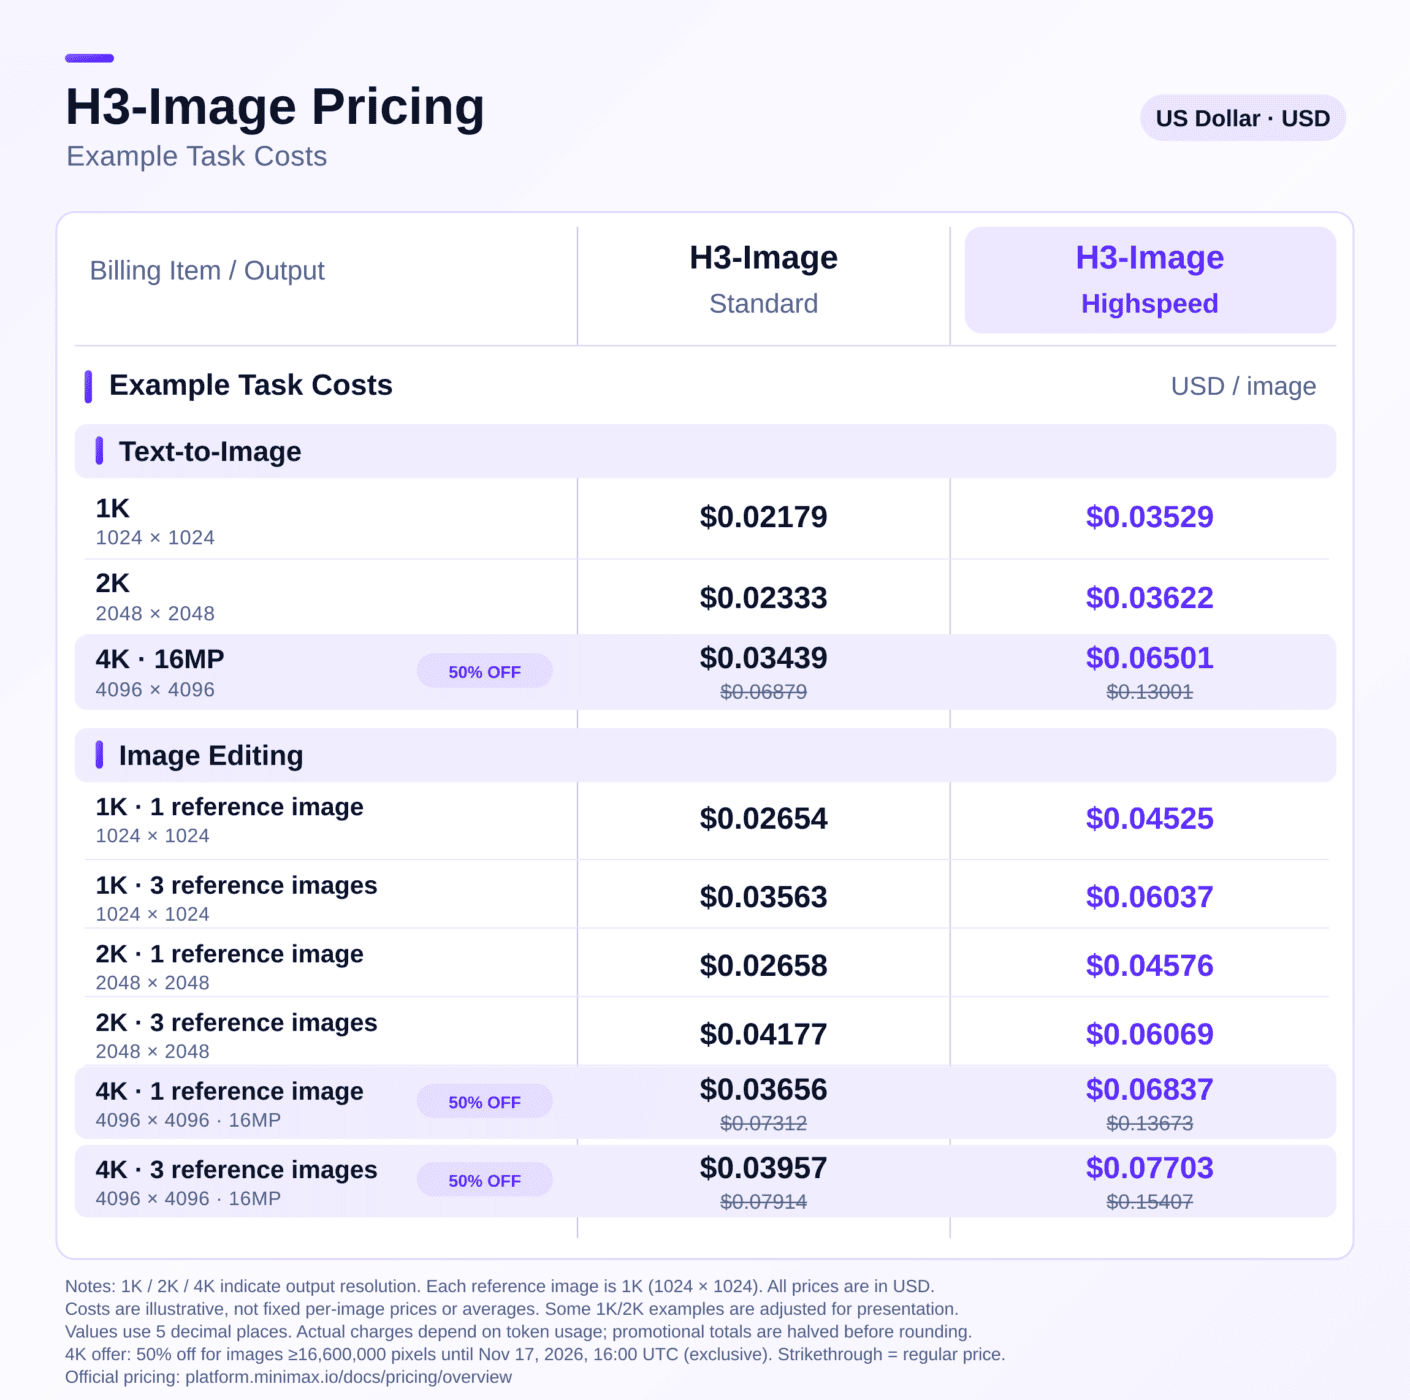
Для локального запуска придётся скачать трансформер весом 66.28 ГБ, VAE — 2.34 ГБ, а текстовый энкодер на 66.7 ГБ подтягивается из репозитория MiniMax-H3. В SGLang модель запускается на одной видеокарте, а для меньшей задержки можно разнести последовательность на 4 GPU через sequence parallelism (Ulysses).
Первые отзывы пользователей
Часть отзывов написали участники раннего доступа, а пост Mankyu помечен как оплаченное партнёрство с MiniMax, поэтому опираться стоит прежде всего на замеры.
Локальный запуск возможен, но небыстрый. AJ на RTX 3090 с весами INT8 и лимитом мощности 250 Вт получил 4K-картинку за 55.79 с, и качество, по первым впечатлениям, выше, чем у Qwen-Image-2.1. Pratik Gandhi на Mac mini M5 Pro с 64 ГБ памяти потратил на 4K 547 с при пиковом потреблении 45 ГиБ. Из них около 40 с уходит на кодирование промпта.
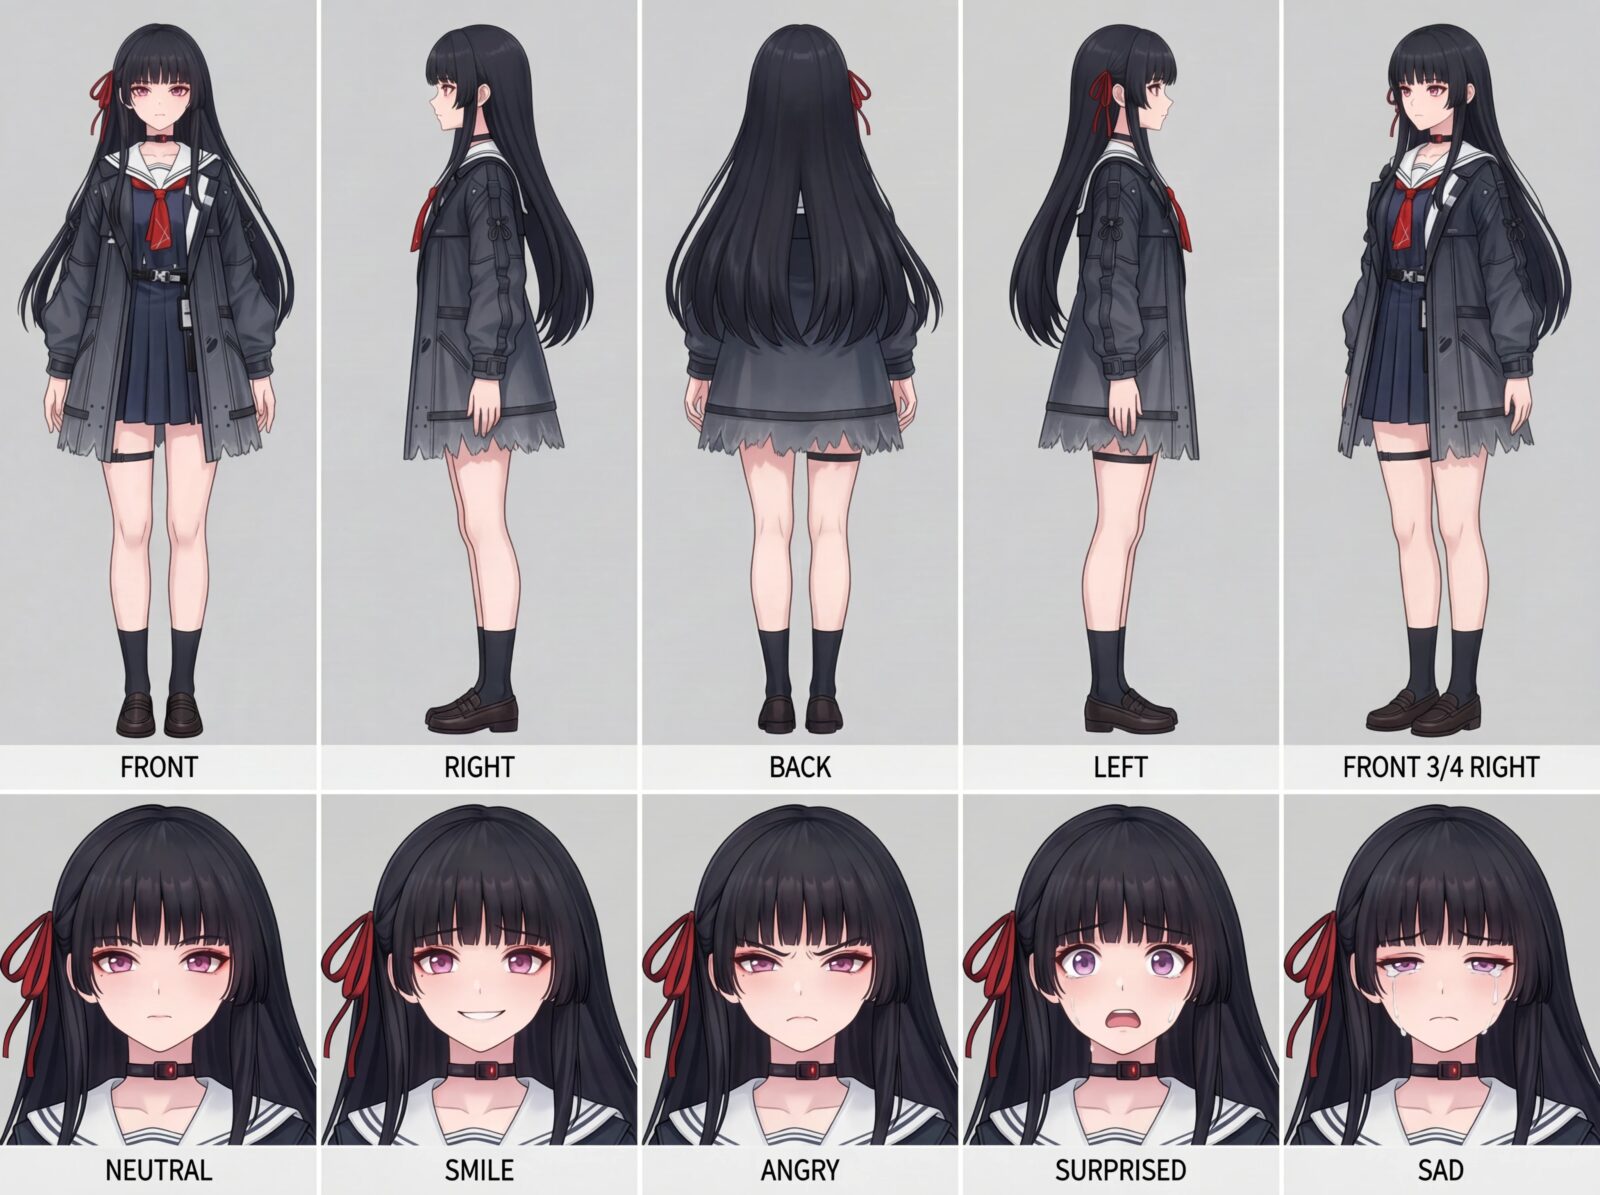
Блогер Yakamochi сравнивает редактирование с локальной GPT Image: по одному референсу модель собирает лист персонажа с пятью ракурсами и пятью эмоциями, и такими листами удобно расширять датасет для обучения LoRA. Mankyu тоже хвалит смену одежды и причёски без потери персонажа, но замечает, что при новом ракурсе или позе иллюстрация теряет исходный стиль.
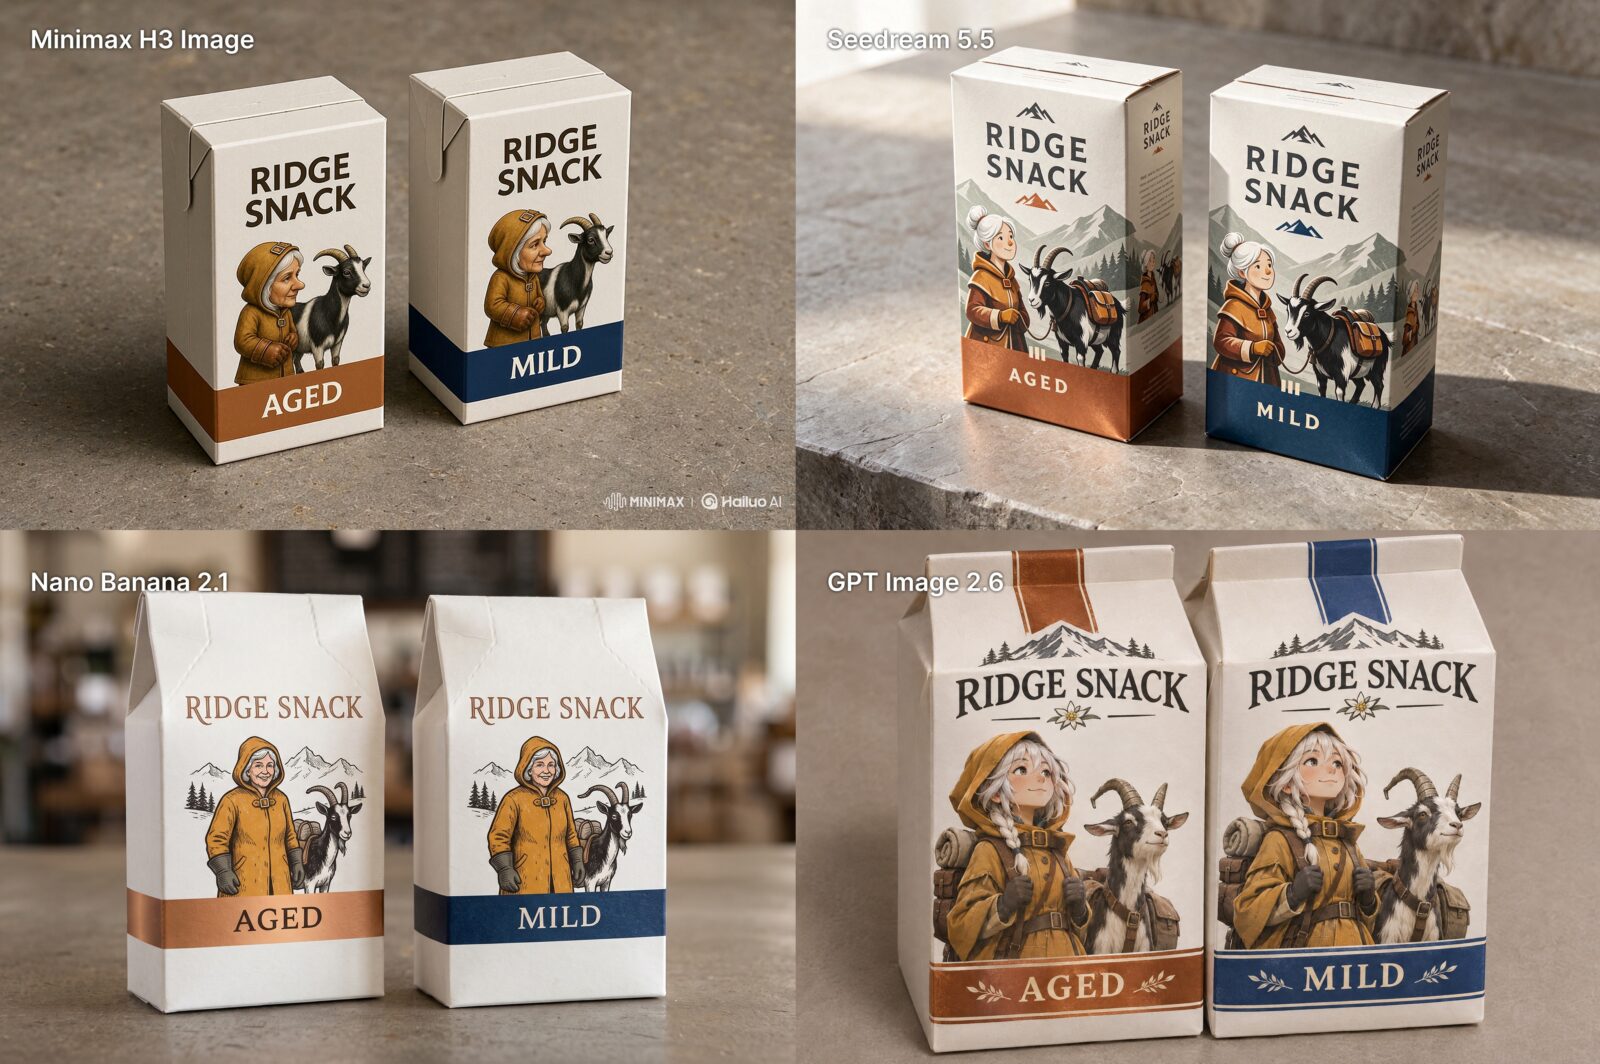
Alex Patrascu сравнил четыре модели на сложном промпте продуктового мокапа. H3-Image верно передала ракурс, цвета полос и надписи на упаковке, но потеряла перчатки маскота, поклажу на козе и загнутый рог. Победителем он назвал Seedream 5.5.
В тесте Pixel Dojo на 8 промптах H3-Image выдала более естественные портреты и точнее следовала указаниям про ракурс, чем GPT Image 2.6. С мелким текстом модель справляется хуже: в меню на доске появилась опечатка, а подписи к инфографике состояли из несуществующих слов.
Ограничения MiniMax H3-Image
Главная проблема релиза: заявление о лучшем следовании инструкциям ничем не подкреплено. MiniMax не опубликовала метрик качества, в рейтингах Artificial Analysis модели на 11 ноября нет, а независимые проверки сводятся к нескольким промптам.
Лицензия MiniMax-H3-Image Community License тоже далека от открытых в привычном смысле. Если годовая выручка компании больше $1 млн или она запускает сервис для третьих лиц, нужно отдельное письменное разрешение MiniMax. Коммерческие продукты обязаны показывать название MiniMax-H3-Image в интерфейсе, а модель и её генерации нельзя использовать для улучшения других ИИ-моделей, в том числе через дистилляцию и синтетические данные. Наконец, лицензия не распространяется на ЕС, Великобританию, Южную Корею и США, так что формально пользоваться весами там нельзя.