Новое в теме

Картинки и видео

JoyAI-Video-Edit: 16B-модель редактирует видео в реальном времени, выдавая 30 FPS в 720p на одной B200

Команда Joy Future Academy опубликовала JoyAI-Video-Edit — открытую авторегрессионную диффузионную модель на 16 млрд параметров, которая редактирует видеопоток по текстовой…

Модели мира

DreamX-World 1.0: открытая модель генерации мира с контролем камеры, текстовым управлением и запоминанием локаций

Команда AMAP-ML опубликовала DreamX-World 1.0 — интерактивную генеративную модель мира, которая превращает текст или изображение в управляемое видео с точным контролем камеры…

Картинки и видео

LongLive-2.0: NVIDIA научила модель генерировать длинное видео в реальном времени с квантованием NVFP4

Исследователи из NVIDIA опубликовали LongLive-2.0 — инфраструктуру для обучения и запуска моделей генерации длинного видео с использованием квантования до 4-битной точности…

Картинки и видео

ChatGPT Images 2.0: OpenAI запустила обновление модели генерации изображений с рассуждениям, 2K-разрешением и мультиязычным текстом

21 апреля 2026 года OpenAI выпустила ChatGPT Images 2.0 на базе модели gpt-image-2. По данным LM Arena, новая модель сразу заняла первое место во всех категориях генерации…

Картинки и видео

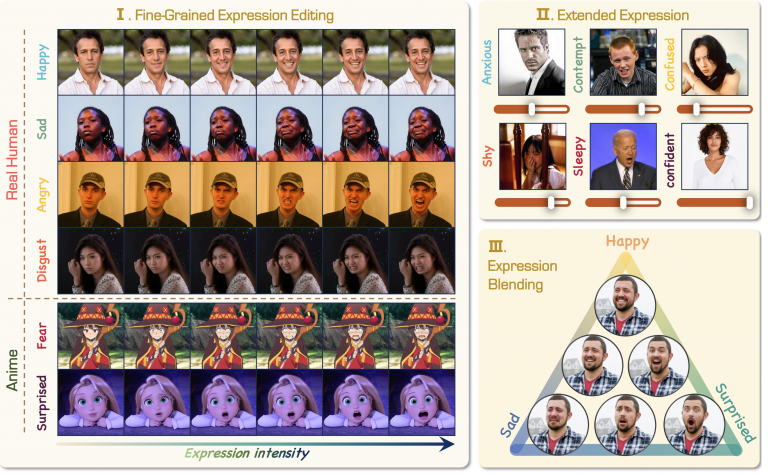
PixelSmile: открытая модель для редактирования эмоций на изображениях с плавным контролем интенсивности эмоций

Исследователи из Fudan University и StepFun опубликовали PixelSmile — диффузионную модель для точного редактирования мимики на портретах и аниме-изображениях. Вместо обучения на…

Картинки и видео

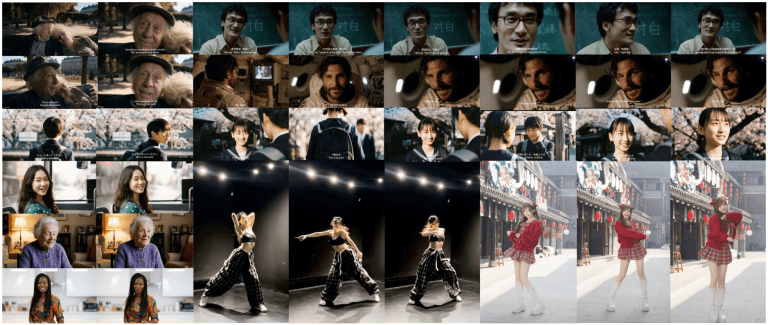
daVinci-MagiHuman: открытая 15B-модель генерирует 5-секундное видео с липсинком за 2 секунды на одном H100

Команды SII-GAIR и Sand.ai опубликовали daVinci-MagiHuman — открытую мультимодальную 15B-модель на основе однопоточного трансформера, которая одновременно генерирует видео с…

Новинки нейросетей в Telegram

Другие темы