Исследователи Tsinghua University и Shengshu Technology представили Vidu S2 — две видеомодели, с помощью которых можно создать цифровой аватар и провести с ним видеозвонок или запустить стрим, а видеопоток редактировать в реальном времени.
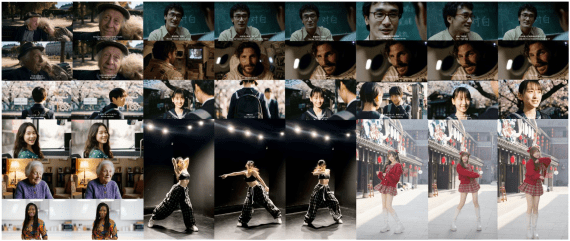
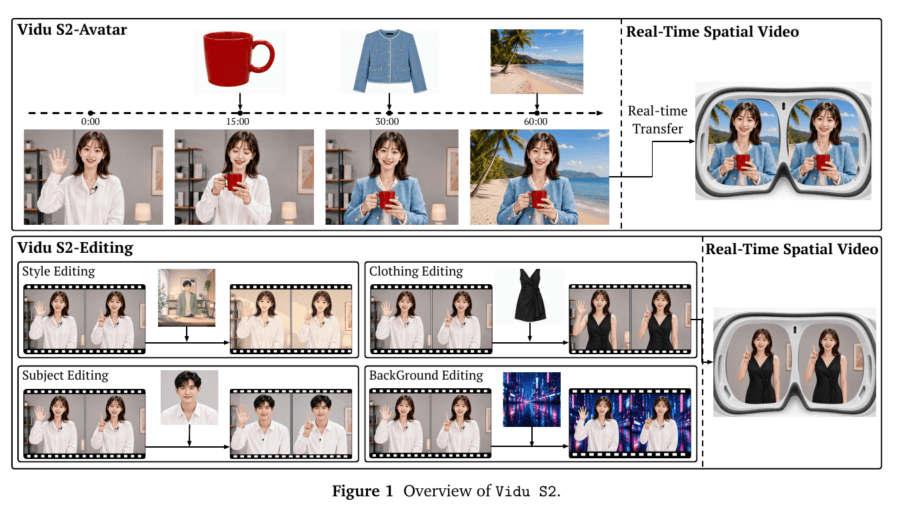
Vidu S2-Avatar делает из одной фотографии говорящего цифрового персонажа: он произносит поданную аудиодорожку с попаданием в губы, меняет выражение лица, переводит взгляд, жестикулирует и выполняет текстовые или голосовые команды, вплоть до танца. Поток не ограничен по длине. Новую опорную картинку можно подать в любой момент прямо посреди трансляции: показали кружку – персонаж берёт её в руку, показали пиджак – надевает его, показали пляж – уходит из комнаты и оказывается на пляже.
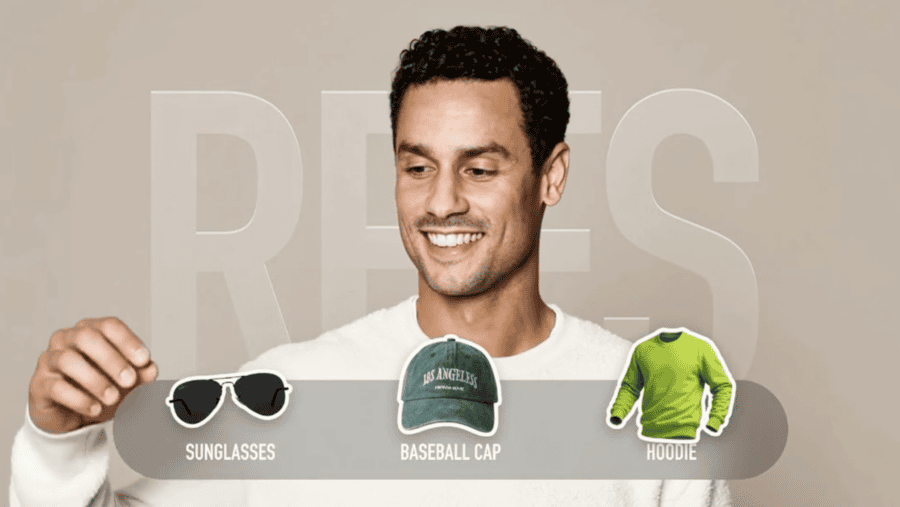
Vidu S2-Editing работает с видеопотоком в реальном времени и перекраивает его на лету по текстовой инструкции и опорной картинке: перекрашивает ролик в другой стиль (акварель, аниме, киберпанк и еще 50 вариантов), переодевает человека в кадре, заменяет его другим персонажем или подменяет фон. Движение и тайминг исходника сохраняются кадр в кадр. Редактировать можно и то, что человек видит через камеру шлема, а результат обе модели отдают в том числе стереопарой для VR.
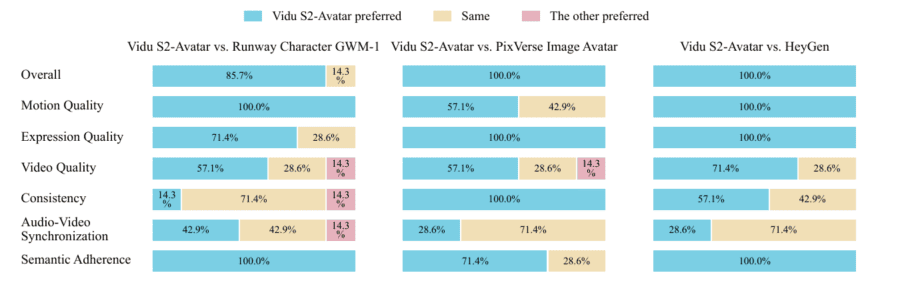
Разрешение выросло с 540p у предыдущей версии S1 до 720p при 25–42 FPS. На StreamAV-Bench модель забрала первое место во всех девяти метриках сразу, на тесте виртуальной примерки ViViD метрика VFID упала до 9.95 против 19.51 у прежнего лидера, а в слепых парных сравнениях оценщики предпочли Vidu S2-Avatar конкурентам в 85.7–100% случаев. Проект закрытый: ни код, ни веса, ни датасеты не опубликованы, модель доступны в веб-приложении и по API.
Генерация Vidu S2-Avatar в реальном времени стоит 1.5 кредита в секунду, кредит стоит $0.005. Выходит $0.0075 за секунду, или около 45 центов за минуту и $27 за час непрерывной трансляции. Клонирование голоса: первые 10 голосов бесплатно, дальше около $4.5 за голос. Новым пользователям при регистрации начисляются пробные кредиты.
Почему это сложная задача
Sora, Veo и подобные генераторы работают офлайн: пользователь отправляет промпт и через несколько минут ожидания получает готовый ролик целиком. Диффузионная модель расшумляет всё видео синхронно за много шагов, поэтому промежуточного результата не существует в принципе. Для живого общения, стримов и игр это не годится, картинка должна отвечать на действия человека сразу.
Vidu S1 уже генерировала бесконечный поток, но упиралась в потолок: 540p, опорное изображение фиксируется до старта трансляции, крупные движения вроде танца воспроизводятся плохо, а редактирования входящего потока нет вовсе.
Self-Replay Forcing: градиент сквозь весь роллаут
Поток генерируется сегментами, и каждый следующий опирается на то, что модель сгенерировала сама. Мелкие ошибки переходят дальше и постепенно превращаются в дрейф лица или полный развал картинки. Self-Forcing решает половину проблемы: модель учат на её собственных сегментах, а не на чистых кадрах датасета. Остаются две дыры. История подаётся чистой, хотя на инференсе она зашумлена. И она отсоединена от графа вычислений, поэтому градиент через неё не идёт.
Self-Replay Forcing закрывает обе проблемы. Модель делает длинный авторегрессионный роллаут, затем вся траектория независимо зашумляется и обновляется целиком за один проход с включёнными градиентами. Внутри повтора сегменты остаются в одном графе, поэтому ошибка позднего сегмента докатывается градиентом до ранних. Supervision идёт через DMD, плюс перцептивный лосс против схлопывания в однообразие. На этапе стриминга поверх накатывают Streaming NFT — обучение с подкреплением по человеческим предпочтениям на собственных траекториях модели.
Как удалось достичь 720p
Backbone продолжает считать в низком разрешении, а поднимает его отдельный одношаговый Refiner, работающий прямо в латентном пространстве. Дело в асимметричных уровнях шума: backbone держит кэш с высоким шумом и отвечает за длинное движение, Refiner держит кэш с низким шумом и отвечает за мелкие детали и идентичность. Временная согласованность и пространственная детализация перестают конкурировать за одну и ту же ёмкость.
Данные: чёткость важнее разрешения
Обучающие ролики отбирали не по номинальному разрешению, а по измеренной чёткости, потому что сильно сжатое видео даже в 1080p выглядит размытой. Оценка собирается из разрешения, частоты кадров, кодека, битрейта, резкости краёв и выраженности артефактов сжатия. Точки монтажа ищет VLM, доля ложных отбраковок держится ниже 2%. Оператор стабилизации фона геометрически компенсирует движение камеры, чтобы не выбрасывать динамичные танцевальные ролики целиком. Подписи переделали в хронологические: события описываются по порядку с границами во времени, вместо структурного описания сцены.
Для редактора собрали 800 000 отфильтрованных видео и нарезали четыре непересекающихся подмножества по 200 000 роликов: перенос стиля, замена персонажа, замена фона и виртуальная примерка.
Как устроено редактирование потока
Ключевая деталь называется frame-aligned attention. Каждый целевой кадр смотрит только на исходный кадр с тем же временным индексом, поэтому движение и тайминг исходника сохраняются. Опорное изображение при этом видно всем кадрам, так что новая внешность проносится через весь ролик. Исходные кадры не остаются в кэше, их потребляют вместе с кадром, который они породили.
Инференс на недорогих GPU
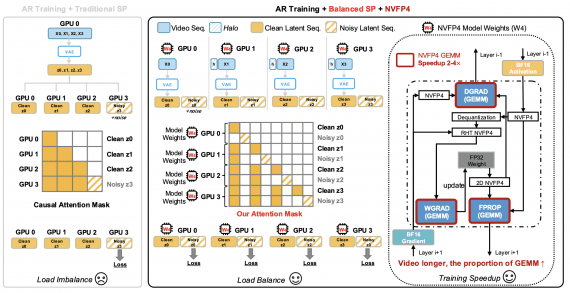
Для поддержания реалтайма на недорогих GPU, авторы собрали свой стек. Для каждого слоя отдельно выбирается SageAttention, SpargeAttention или Sparse-Linear Attention. Линейные слои считаются в поблочном W8A8 GEMM. Соседние операции сливаются в кастомные ядра Triton/CUDA, а устойчивые последовательности запусков заворачиваются в CUDA Graphs. Контекстный параллелизм в стиле Ulysses пересылает между картами квантованные тензоры. VAE-энкодер, backbone, Refiner и VAE-декодер делят одни и те же GPU по общему расписанию вместо того, чтобы простаивать каждый на своей.
Пространственное видео для VR
Отдельная часть работы это пространственное видео. Готовый поток превращают в стереопару, два слегка разных изображения одной сцены, снятых как бы с позиций левого и правого глаза. Так устроены VR-шлемы: каждому глазу показывают свой кадр, мозг складывает их в объём и человек считывает расстояние до предметов. Ради этого ощущения присутствия всё и затевалось, на плоском экране цифровой персонаж остаётся картинкой.
Конвертация работает поверх уже сгенерированного потока. По каждому кадру оценивается глубина и переводится в горизонтальный сдвиг, кадр раздвигается на два вида. На границах объектов при сдвиге открываются участки, которых в исходном кадре не было, их дорисовывает лёгкая постобработка, а оценки глубины сглаживаются по времени, чтобы картинка не дрожала.
Результаты
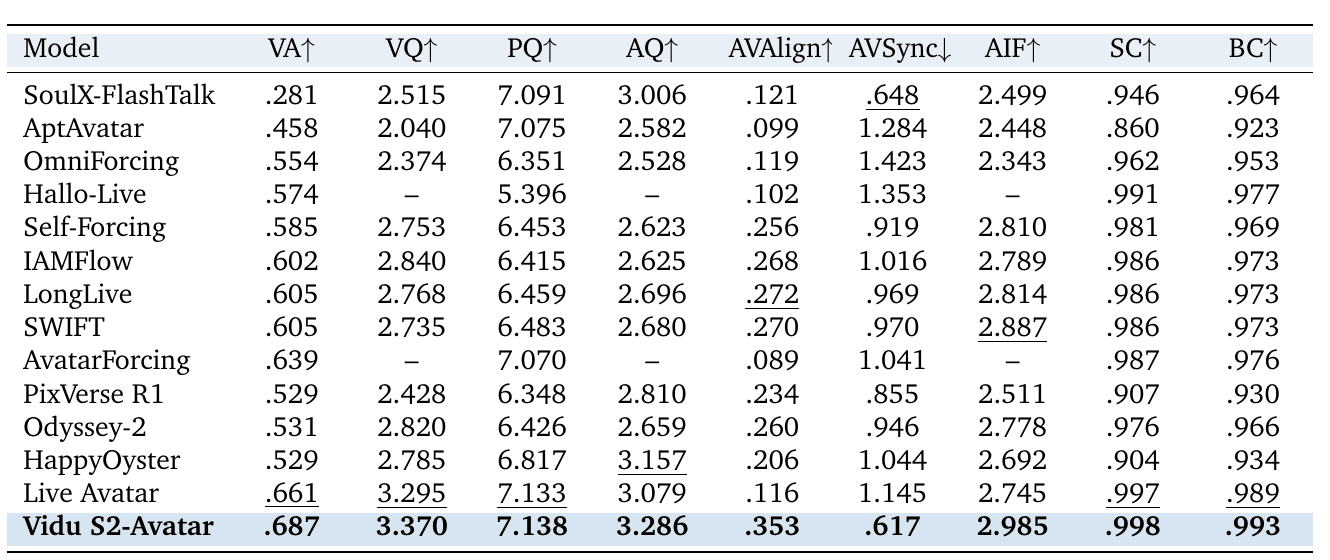
На StreamAV-Bench Vidu S2-Avatar показывает лучшее значение в каждом столбце: визуальная эстетика 0.687 против 0.661 у Live Avatar, ошибка аудио-видео синхронизации 0.617 против 0.648, стабильность персонажа 0.998.
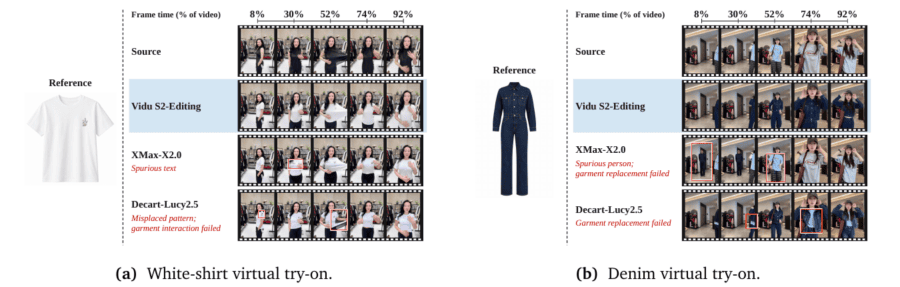
Редактор на Sparkle-Bench набирает 3.74 и первое место по всем шести критериям. В совместной оценке OpenVE и RefVIE итог 4.26 против 3.92 у сильнейшей офлайн-модели Bernini-R 14B, то есть потоковая модель обходит офлайновые, а не просто догоняет их. Во внутреннем бенчмарке из 150 парных случаев редактор выигрывает у Decart-Lucy2.5 в 72.7% сравнений и у XMax-X2.0 в 86.7%.
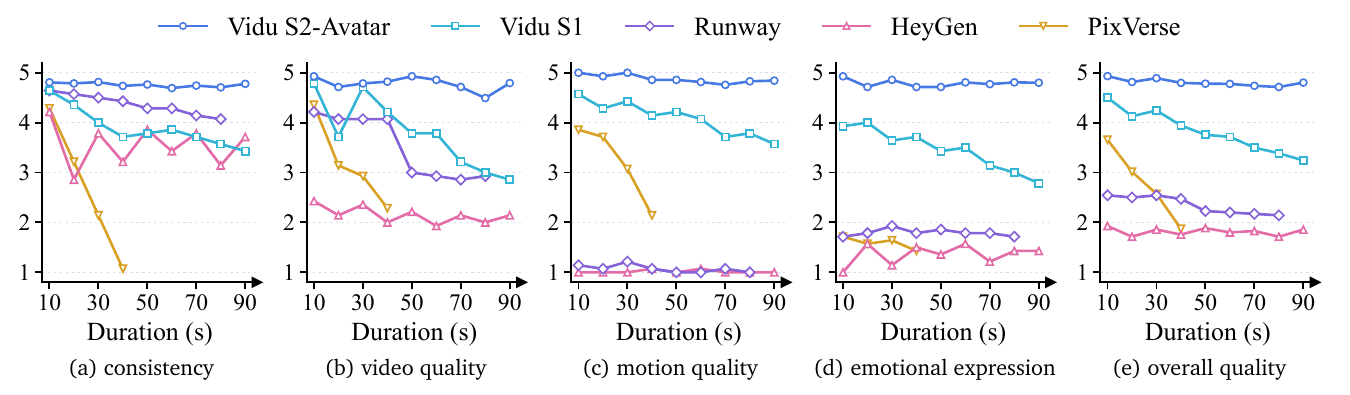
Отдельно интересен график деградации по времени. На роликах от 10 до 90 секунд у конкурентов оценки падают: Vidu S1 уходит с 4.5 до 3.2 по общему качеству, PixVerse обрывается уже на 40 секундах. Vidu S2-Avatar держит линию почти горизонтально на уровне 4.7–4.9 по всем пяти критериям.
В слепых парных сравнениях оценщики выбирали Vidu S2-Avatar единогласно по качеству движения против Runway и HeyGen и по качеству выражения лица против PixVerse и HeyGen. Слабее всего отрыв в аудио-видео синхронизации, где большинство пар признали равными.
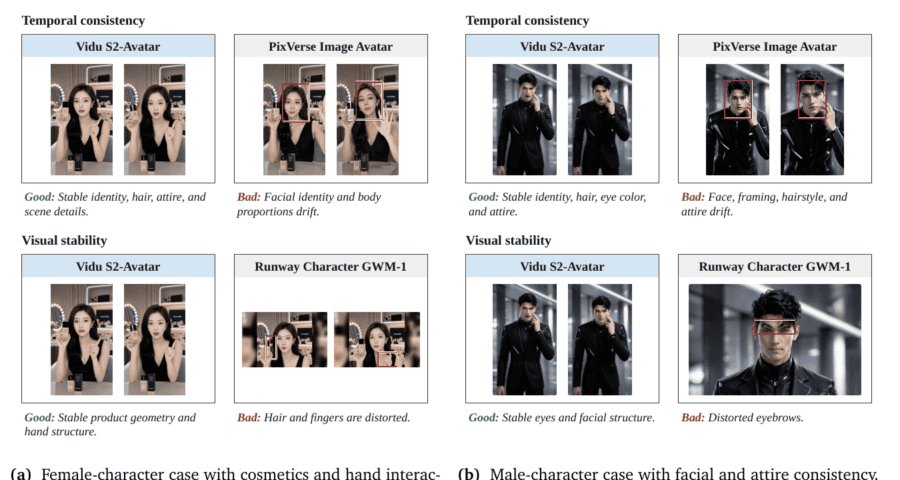
Качественные примеры показывают типичные провалы конкурентов: у PixVerse плывут черты лица и пропорции тела, Runway искажает волосы, пальцы и брови.
Ограничения
Слабые места видны и в самом пейпере. Внутренние бенчмарки и парные сравнения проводили сами авторы силами двадцати оценщиков, а публичные бенчмарки покрывают не все заявленные сценарии. Главной нерешённой задачей команда называет пространственное видео: оно занимает большую часть поля зрения и требует одновременно более высокого разрешения и меньшей задержки, иначе при повороте головы картинка отстаёт от движения. Следующей целью авторы называют панорамное пространственное видео, где пользователь сможет свободно осматриваться в сцене, сгенерированной на лету. Но главное ограничение практическое: проверить любую из этих цифр самостоятельно нельзя, весов и кода нет, остаются демо и платный API.