Исследователи из Google Cloud AI Research представили метод RRSI (Regularized Recursive Self-Improvement), который автоматически улучшает обвязку ИИ-агентов (agent harness) так, чтобы прирост сохранялся и на новых задачах. Обвязкой называют всё, что окружает замороженную LLM: промпты, логику управления, инструменты, память и работу с контекстом. Метод полезен командам, которые строят агентов на закрытых моделях через API: веса таких моделей недоступны, поэтому качество агента поднимают через обвязку. Ещё он нужен тем, кто уже оптимизирует промпты и инструменты автоматически и видит, что прирост не переносится на новые задачи.
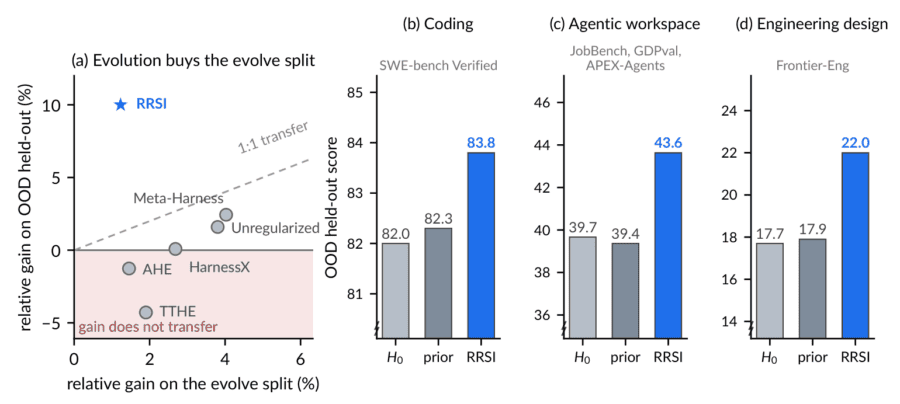
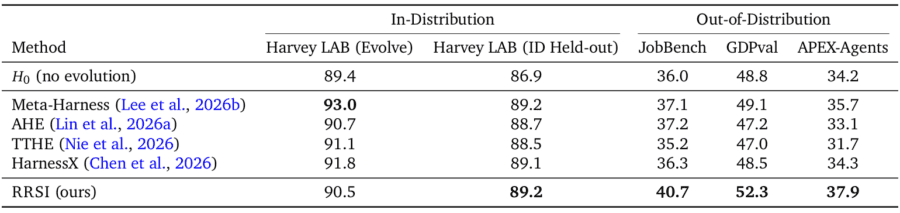
Прошлые методы эволюции обвязки почти не переносили прирост на другие бенчмарки: в офисных задачах лучший из них прибавил вне распределения в среднем 0.9 пункта, а другие оказались хуже исходной обвязки. RRSI в тех же условиях прибавил 3.9 пункта, на пяти незнакомых бенчмарках результат улучшился на 4.7 пункта, а на задачах, на которых шла эволюция, до 14.1. При этом обвязка RRSI экономнее: с ней агент тратит на одну задачу в среднем 2.42 млн токенов, а с обвязкой, которую нашла эволюция без регуляризации, 3.80 млн. Код открыт под лицензией Apache 2.0, а на странице проекта выложены четыре реальных запуска с решениями критика и diff. Весов и датасетов нет: RRSI не обучает модель и тестируется на существующих бенчмарках. Код на GitHub, статья на Hugging Face, журналы экспериментов на странице проекта.
Что такое обвязка ИИ-агентов и почему её эволюция переобучается
Обвязка ИИ-агента решает, какой файл прочитать перед правкой, как восстановиться после упавшей команды и что оставить в контексте. Известные примеры обвязок: Claude Code от Anthropic и Codex от OpenAI. Методы вроде Meta-Harness, AHE, TTHE и HarnessX настраивают обвязку автоматически: агент решает фиксированный набор задач (evolve set), LLM читает траектории и предлагает правки, а лучший по оценке кандидат становится новой обвязкой. По сути это рекурсивное самоулучшение (RSI) на уровне агента.
Проблема в том, что набор для эволюции конечен и переиспользуется в каждом раунде. Получается как со студентом, который зазубрил билеты прошлых лет и теряется на новых вопросах. Авторы выделяют три механизма переобучения: подгонку под бенчмарк (в промпт попадают названия задач или ответы), погоню за шумом оценки и накопление сложности, которая поднимает счёт, но не улучшает агента.
Чтобы запустить RRSI на своей обвязке ИИ-агента, нужны задачи с автоматической проверкой (тесты, симулятор или LLM-судья), разбитые на набор для эволюции и отложенный. В репозитории есть готовые конфигурации для терминального, офисного и инженерного агентов, а свой домен подключается модулем adapter.py. Агент, генератор правок и критик по умолчанию работают на Claude Opus 4.8, но подойдёт любая модель из LiteLLM. Запуск недешёвый: в каждом из 20-40 раундов два кандидата по несколько раз проходят все задачи. Принципы метода можно перенять и без кода: мерить шум повторными прогонами, менять за раз одну-две вещи и отклонять правки, которые увеличивают расход токенов без прироста качества.
Как RRSI регуляризирует эволюцию обвязки
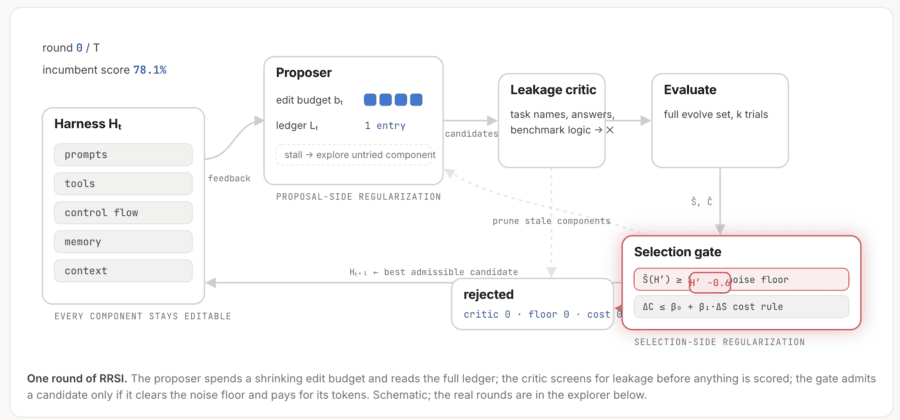
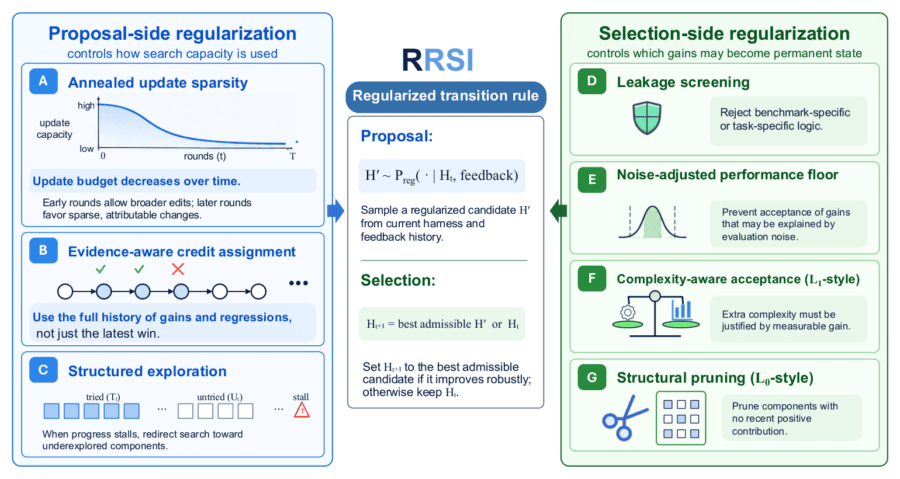
Регуляризацией в ML называют приёмы, которые мешают модели зазубрить обучающие данные, например штраф за слишком большие веса. RRSI применяет ту же идею к обвязке: менять можно всё, от промптов до субагентов, но поиск ограничен правилами против подгонки под бенчмарк. Вот что происходит на этапе предложения правок:
- Всё меньше правок за раз. В первых раундах кандидат может менять до трёх-четырёх вещей сразу, к последним только одну. Лимит снижается плавно, как learning rate при обучении нейросети. Когда правка одна, сразу видно, что дало прирост. Это аналог L0-регуляризации: там ограничено число ненулевых весов, здесь число правок;
- Учёт всей истории. Для каждой правки хранятся компонент, гипотеза, diff и изменения качества и стоимости, поэтому поиск не возвращается к опровергнутым идеям;
- Структурированное исследование. Если прогресс застрял в пределах шума, часть бюджета уходит на ещё не тронутые компоненты. Это похоже на энтропийную регуляризацию.
На этапе отбора:
- Проверка на утечку. До оценки LLM-критик отклоняет правки с названиями задач, ответами и другой логикой под конкретный бенчмарк;
- Порог шума. Разброс δ оценивают по повторным прогонам исходной обвязки, и кандидат не может опуститься ниже лучшего результата минус δ, чтобы поиск не сползал вниз через мелкие ухудшения;
- Стоимость должна окупаться. Рост расхода токенов допустим, только если его оправдывает прирост качества: ΔC ≤ β0 + β1ΔS. Это аналог L2-регуляризации (Ridge);
- Прунинг. Компоненты без положительного вклада в последних раундах идут на удаление. Это аналог L1-регуляризации (Lasso).
На схеме ниже подписи L1 и L0 у блоков F и G расходятся с текстом статьи, аналогии здесь даны по тексту.
Результаты
Эволюция шла на Terminal-Bench 2.1 (программирование), Harvey LAB (юридические офисные задачи) и EngDesign (инженерное проектирование). Потом готовую обвязку без изменений запускали на пяти бенчмарках вне распределения (out-of-distribution, OOD): SWE-bench Verified, JobBench, GDPval, APEX-Agents и Frontier-Eng.
На наборах для эволюции RRSI прибавил 6.0 пункта на Terminal-Bench 2.1, 4.9 на EngDesign и 1.1 на Harvey LAB. Важнее, что ни один отложенный набор не просел: результат на SWE-bench Verified вырос с 82.0 до 83.8, отложенная часть Harvey LAB прибавила 2.3 пункта, три офисных OOD-бенчмарка от 3.5 до 4.7 пункта, а результат на Frontier-Eng вырос с 17.7 до 22.0, то есть на 24.3%.

Абляция, стоимость и другие модели
Абляция показывает, что нужны обе группы регуляризаторов. Эволюция без регуляризации даёт лучший результат на наборе для эволюции (92.8), но OOD-среднее у неё 40.3, почти как у исходной обвязки. Без ограничений на этапе отбора OOD-среднее падает с 43.6 до 41.0, а стоимость растёт в полтора раза.
Среди обвязок после эволюции у RRSI стоимость самая дешёвая: 26.3 шага на попытку, у других методов от 27.3 до 34.6. Исходная обвязка ещё дешевле (1.56 млн токенов против 2.42 млн), так что часть прироста всё же оплачена вычислениями.

С Gemini 3.5 Flash в роли агента метод тоже работает: результат на Terminal-Bench 2.1 вырос с 64.6 до 78.7 (те самые +14.1 пункта), а на SWE-bench Verified с 76.8 до 79.0. Найденная обвязка помогла и более слабой Gemini 3.1 Flash Lite, которая в поиске не участвовала: с 11.2 до 14.6 на Terminal-Bench 2.1.
Ограничения
RRSI не обновляет веса и работает только с замороженной LLM. Кроме того, метод зависит от конечного набора задач и нескольких гиперпараметров. Главный вывод авторов: при рекурсивном самоулучшении обвязки ИИ-агентов нужно контролировать не только то, что можно менять, но и то, как обратная связь превращается в постоянные изменения.