ИИ-агенты

DynaFlow: фреймворк обучает ИИ-модели эффективно использовать команды субагентов

Сейчас сложные задачи всё чаще решает не одна нейросеть, а команда ИИ-агентов, где один ищет информацию, второй выполняет задачу, а третий проверяет результат. Исследователи из National University of Singapore показали:…
Hugging Face
ИИ-агенты

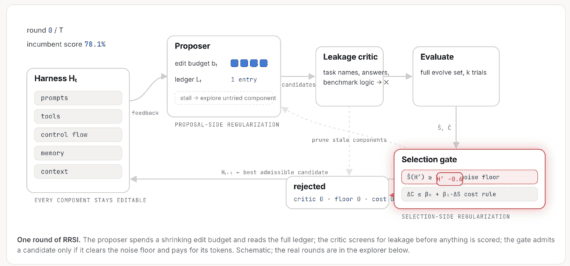
RRSI: метод рекурсивного самоулучшения обвязки ИИ-агентов от Google дает прирост и на незнакомых задачах

Исследователи из Google Cloud AI Research представили метод RRSI (Regularized Recursive Self-Improvement), который автоматически улучшает обвязку ИИ-агентов (agent harness) так, чтобы прирост сохранялся и на новых задачах. Обвязкой называют всё,…
Hugging Face
ИИ-агенты

Microsoft выпустила Agent Lightning v1.0 для обучения агентов внутри их собственной обвязки

Исследователи Microsoft вместе с коллегами из Fudan University, Zhejiang University и University of Edinburgh опубликовали Agent Lightning v1.0 — фреймворк для обучения LLM-агентов с подкреплением, который целиком умещается примерно в 3,500…

Bonsai 27B: модель с 27 миллиардами параметров впервые запустили на смартфоне благодаря 1-битным весам

Стартап PrismML, основанный исследователями из Caltech, представил Bonsai 27B — это бинарная и тернарная версии модели Qwen3.6-27B, которые сохраняют 90–95% качества исходной модели при сжатии весов в 9.4–14.2 раза. Тернарная…
Hugging Face
State-of-the-art

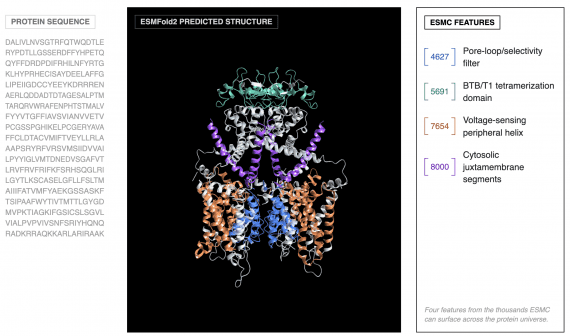
ESM Cambrian: модель для предсказания и дизайна белков превзошла AlphaFold3 от Google и построила крупнейший атлас белкового мира

Команда исследователей из Biohub опубликовала ESM Cambrian (ESMC) — языковую модель для предсказания и дизайна белков, которая обошла AlphaFold3 от Google по точности предсказания структур, спроектировала  молекулы, которые крепко связываются…
Hugging Face
Архитектуры

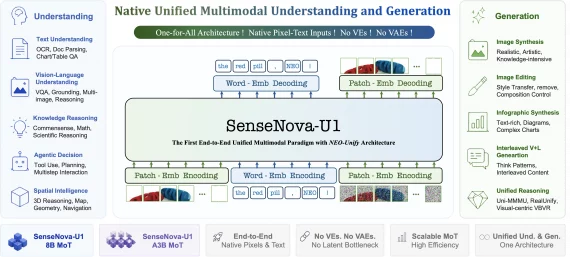
SenseNova-U1: мультимодальная архитектура NEO-unify работает напрямую с пикселями без VAE

Команда SenseNova представила новую мультимодальную архитектуру SenseNova-U1, которая объединяет понимание изображений, генерацию и редактирование внутри единого трансформера без отдельного визуального энкодера и вариационного автокодировщика. Такой подход убирает необходимость постоянно переводить…
ИИ-агенты

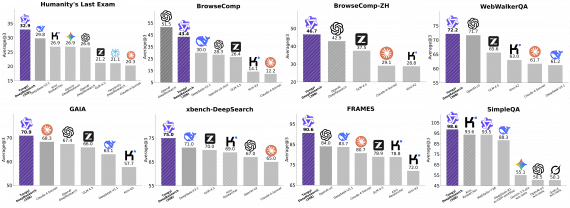
OpenSeeker-v2: лучший в своем классе Deep Research агент, созданный академической командой всего на 10600 примерах

Исследователи из Шанхайского университета Цзяо Тун доказали, что для создания лучшего в своём классе deep research агента не нужны сотни миллиардов токенов предобучения и дорогостоящее обучение с подкреплением. Достаточно 10…
ИИ-агенты

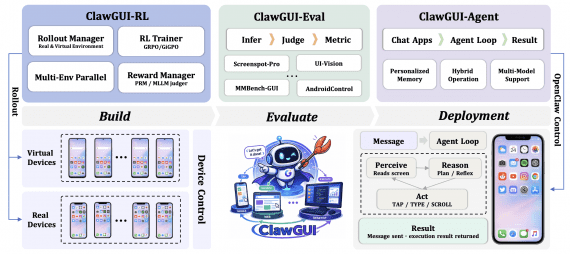
ClawGUI: первый открытый фреймворк полного цикла для GUI-агентов от обучения до реального устройства

Исследователи из Чжэцзянского университета опубликовали ClawGUI — полностью открытый фреймворк для разработки GUI-агентов, которые управляют приложениями через визуальный интерфейс, как это делает человек: касаниями, свайпами и вводом текста. На практике…
Картинки и видео

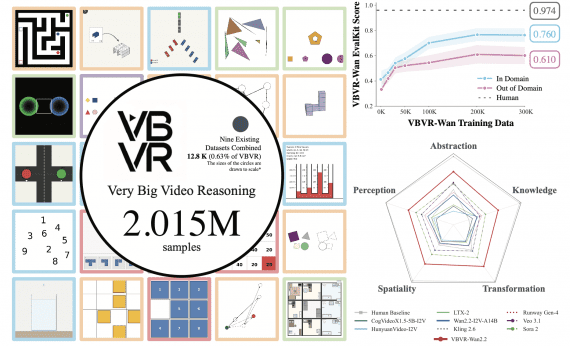
VBVR: открытый датасет на 2 миллиона видео для обучения видеомоделей рассуждению

Команда из более чем 50 исследователей со всего мира — из CMU, Oxford и других университетов — опубликовала Very Big Video Reasoning (VBVR) — огромный набор данных для обучения видеомоделей…
Открытые LLM

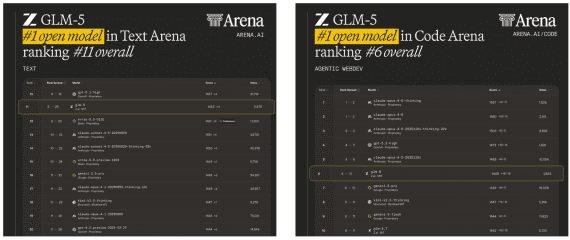
GLM-5: топ-1 открытая модель для генерации кода и текста, конкурирующая с Claude и GPT на агентных задачах

Zhipu AI и Tsinghua University опубликовали техрепорт GLM-5 — на сегодня лучшей открытой языковой модели по бенчмаркам: первое место среди open-weight моделей на Artificial Analysis и топ-1 в кодинге и…
Открытые LLM

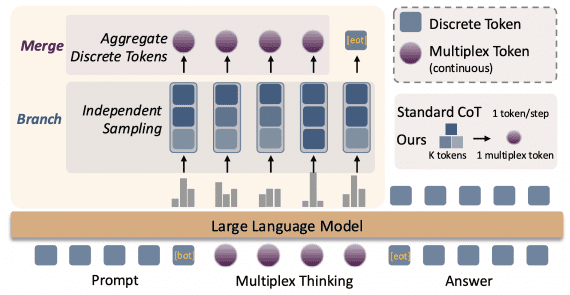
Multiplex Thinking: семплинг 3 токенов вместо 1 повышает точность решения олимпиадных задач с 40% до 55%

Исследователи из Университета Пенсильвании и Microsoft Research представили Multiplex Thinking — новый метод рассуждения для больших языковых моделей. Идея в том, чтобы на каждом шаге генерировать не один токен, а…
Открытые LLM

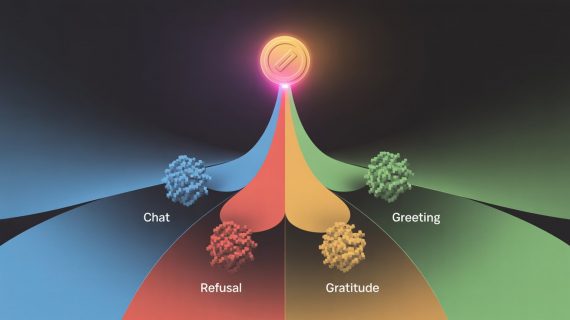
От миллионов долларов на «спасибо» к эффективному инференсу: детекция шаблонных ответов за один токен

Исследователи JFrog опубликовали работу, демонстрирующую метод раннего обнаружения шаблонных ответов (boilerplate responses) больших языковых моделей после генерации всего одного токена. Метод позволяет оптимизировать вычислительные затраты через досрочное прерывание генерации или…
Локальные модели

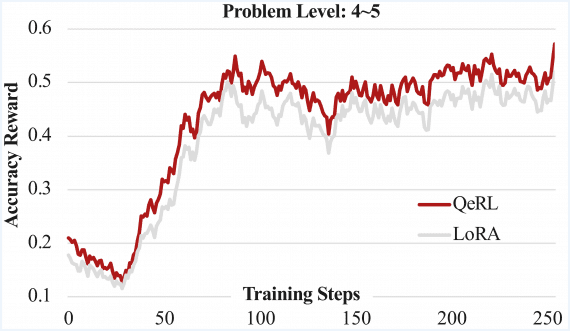
QeRL: 32B модель обучается с подкреплением на одном GPU H100 вместо трех, превосходя LoRA в точности

QeRL — фреймворк для обучения языковых моделей методом обучения с подкреплением, который одновременно снижает требования к GPU и превосходит в точности традиционные методы LoRA и QLoRA. На модели Qwen2.5-7B-Instruct QeRL…
Открытые LLM

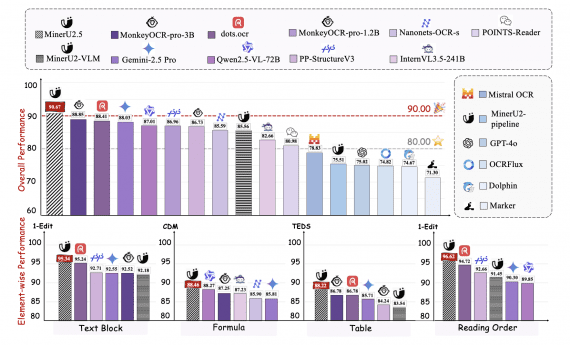
MinerU2.5 — открытая 1.2B-модель для парсинга PDF документов превосходит Gemini 2.5 Pro на бенчмарках

MinerU2.5 — компактная vision-language модель с 1.2 миллиардами параметров для парсинга PDF документов, представленная командой Shanghai Artificial Intelligence Laboratory. Модель достигает state-of-the-art результатов в парсинге PDF при минимальных вычислительных затратах…
Картинки и видео

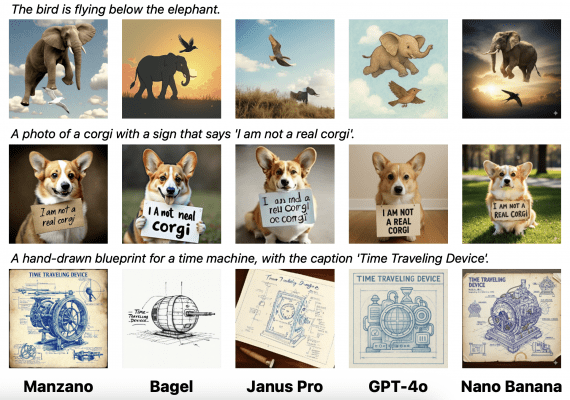
Гибридный токенизатор изображений: новый подход Apple к созданию мультимодальных моделей

Команда исследователей Apple представила Manzano — унифицированную мультимодальную большую языковую модель, которая объединяет возможности понимания и генерации визуального контента через гибридный токенизатор изображений и тщательно подобранную стратегию обучения. Авторегрессивная модель…
Открытые LLM

WebWeaver — открытый фреймворк для глубоких исследований преводсходит OpenAI DeepResearch, Gemini Deep Research на бенчмарках

Исследователи из Tongyi Lab (Alibaba Group) представили WebWeaver — открытый двухагентный фреймворк для глубоких исследований, который симулирует человеческий исследовательский процесс. Фреймворк состоит из планировщика, который итеративно чередует веб-поиск источников и…
Открытые LLM

MiniCPM4: открытая локальная модель достигает производительности Qwen3-8B при 7-кратном ускорении инференса

Команда исследователей OpenBMB представила MiniCPM4 — высокоэффективную языковую модель, разработанную специально для локальных устройств. MiniCPM4-8B достигает сопоставимой с Qwen3-8B производительности (81.13 против 80.55), при этом для обучения требуется в 4.5…
Открытые LLM

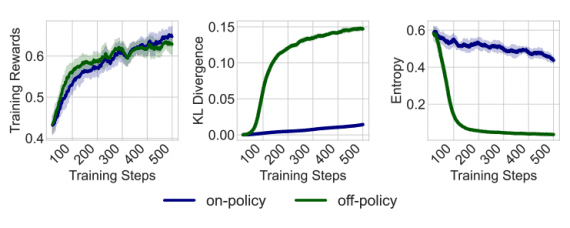
Строгое on-policy обучение с оптимальным бейзлайном: Microsoft представила упрощенный алгоритм для RLHF

Исследовательская команда Microsoft Research представила On-Policy RL with Optimal reward baseline (OPO) — упрощенный алгоритм обучения с подкреплением для выравнивания больших языковых моделей. Новый метод решает ключевые проблемы современных RLHF…
ИИ-агенты

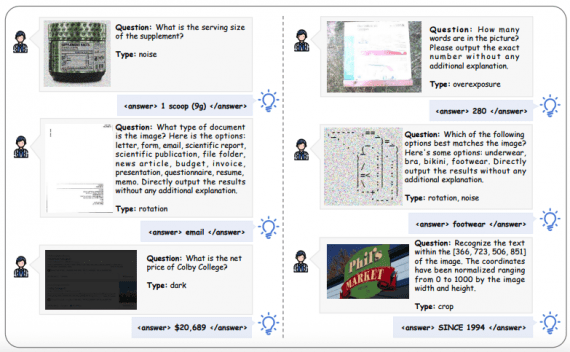
Visual-ARFT: новый метод обучения AI-агентов обходит GPT-4o в мультимодальных задачах

Исследовательская группа из Шанхайского университета Цзяо Тонг и Шанхайской лаборатории искусственного интеллекта представила Visual Agentic Reinforcement Fine-Tuning (Visual-ARFT) — новый подход к обучению крупных мультимодальных моделей агентным возможностям. Методика демонстрирует…
Открытые LLM

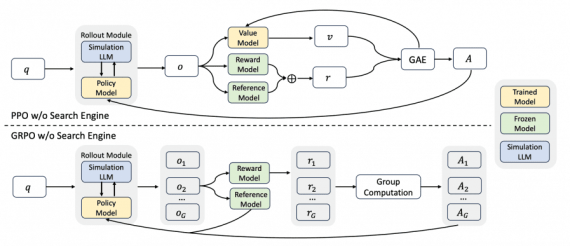
ZEROSEARCH: открытый фреймворк, снижающий затраты на обучение LLM поиску на 88%

Исследовательская команда NLP Alibaba официально открыла исходный код ZEROSEARCH, полноценного фреймворка для обучения LLM способности к поиску в интернете без использования реальных поисковых систем. ZEROSEARCH основан на ключевом наблюдении: LLM…
Открытые LLM

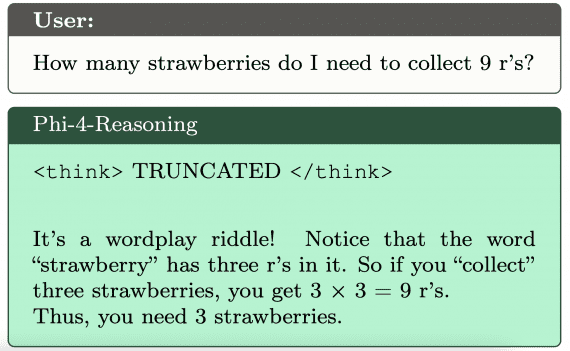
Phi-4-reasoning: 14B модель от Microsoft превосходит масштабные модели в задачах сложного рассуждения

Microsoft представила модель Phi-4-reasoning с 14 миллиардами параметров, которая демонстрирует исключительную производительность на сложных задачах рассуждения, превосходя модели, превышающие её по размеру в 5-47 раз, и требуя значительно меньше вычислительных…