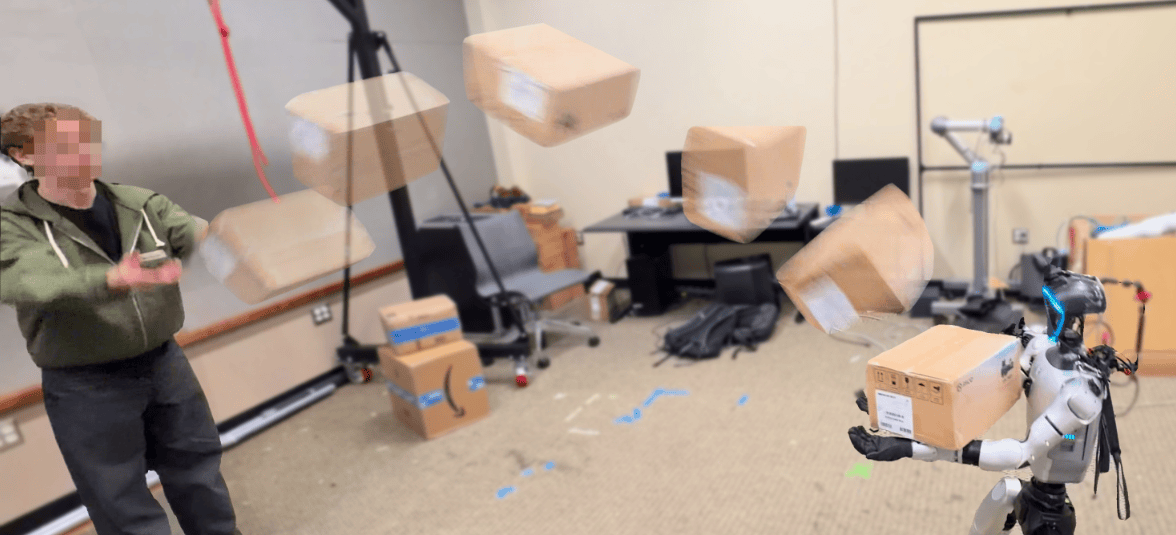
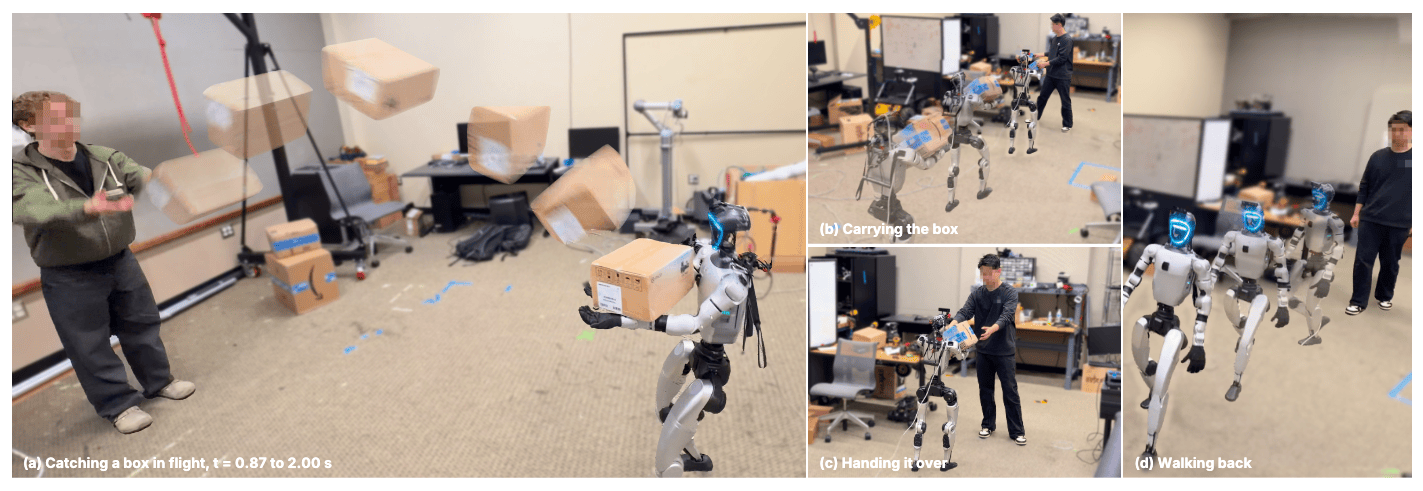
Исследователи из University of Washington, USC, National University of Singapore, UNC Chapel Hill и Allen Institute for AI научили гуманоидного робота Unitree G1 ловить брошенные ему коробки весом до 2 кг на расстоянии до 7 метров на основе метода Reflex. Коробку робот видит только через RGB-D камеру на своём торсе. Пока коробка летит (около секунды), робот выходит на её траекторию, принимает на предплечья, прижимает к груди и гасит удар, не теряя равновесия.
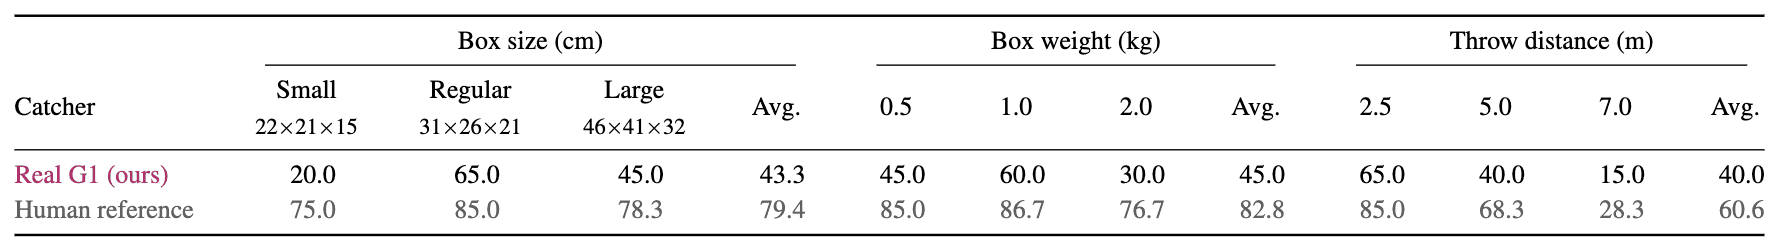
Гуманоидные роботы и раньше ловили баскетбольный мяч и отбивали удары в роли вратаря, но мяч для них отслеживали камеры захвата движения (motion capture) по светоотражающим меткам. Reflex обходится без них, и всё равно реальный гуманоидный робот G1 поймал 65% бросков с 2.5 м и 40% с 5 м. Это 76% и 59% от результата людей на тех же дистанциях. Проект открыт частично: статья, видео и интерактивное 3D-демо уже доступны, а код обучения и оценки, чекпоинты и код для запуска на роботе авторы обещают выложить позже. Лицензии пока нет, весов и датасетов на Hugging Face тоже. Авторы планируют выложить код в репозиторий на GitHub. Видео и демо доступны на странице проекта.
Что должен уметь гуманоидный робот, чтобы поймать коробку
Задача сочетает три проблемы. Первая: управление всем телом. Мяч можно поймать кистями, а коробку нужно принять на предплечья, прижать к торсу и погасить её импульс, переставляя ноги и удерживая равновесие. Вторая: задержка. Коробка долетает примерно за секунду, а медианная задержка от съёмки кадра до команды контроллера равна 69 мс. Реагировать на последний кадр поздно, поэтому гуманоидный робот должен предсказать, куда летит коробка, и заранее выбрать точку, где ее поймать. Третья: эгоцентрическое зрение. Камера двигается вместе с роботом, движение коробки в кадре смешивается с движением самой камеры, а перед контактом коробку закрывают руки робота.
Как устроен Reflex
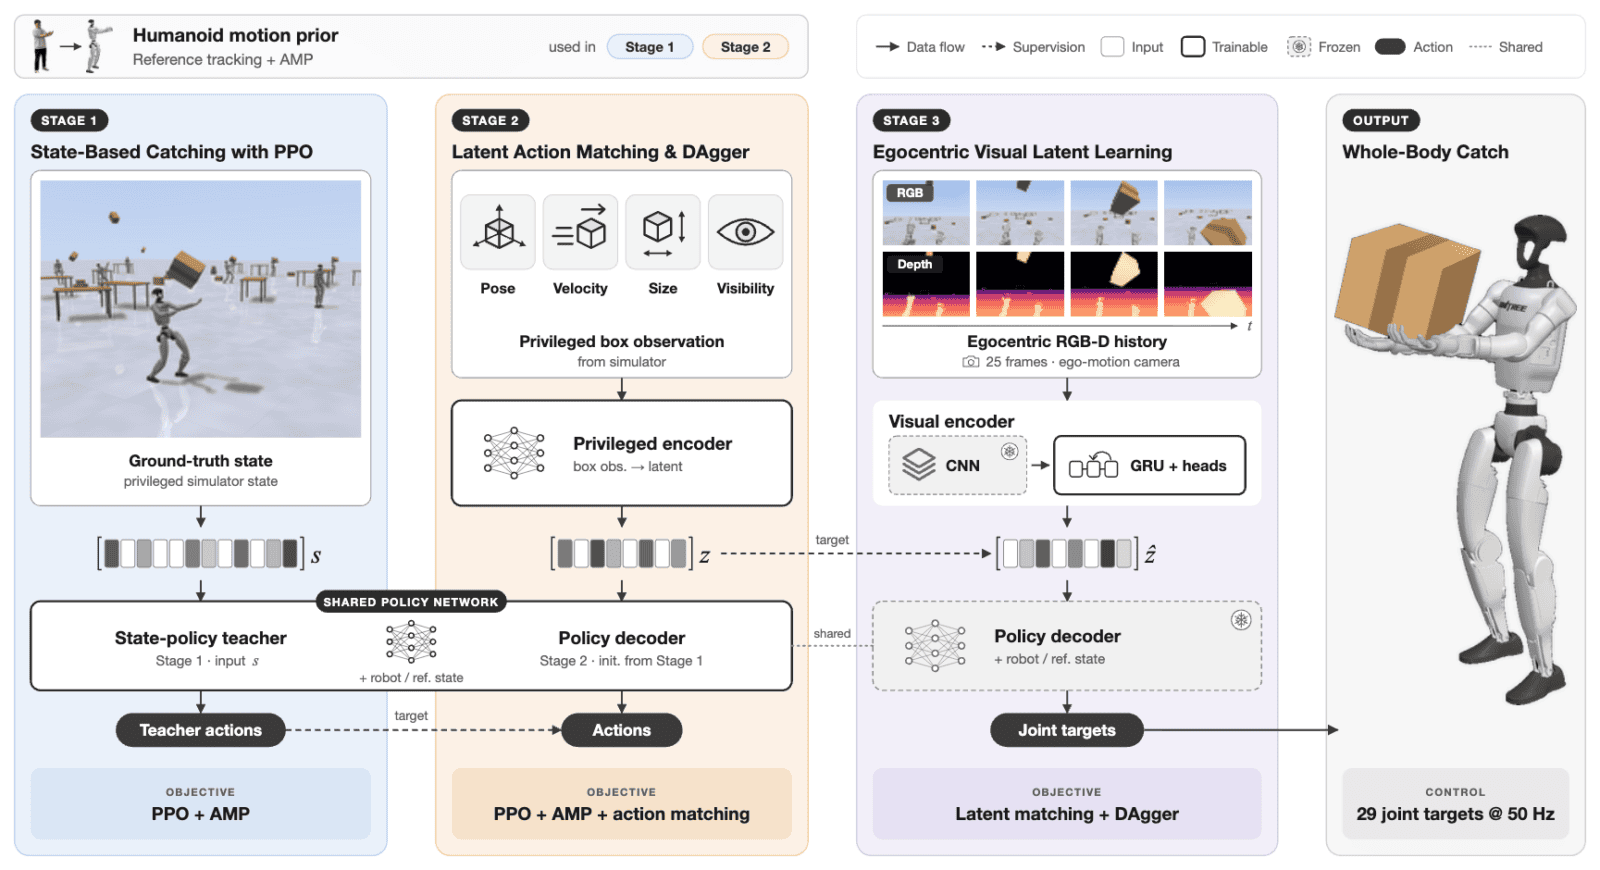
Если учить робота с подкреплением сразу по пикселям, на каждом шаге симуляции придётся рендерить RGB-D, а награда за поимку появляется только в конце броска. На одной RTX 3090 59 млн шагов второго этапа без рендеринга занимают около 35 минут, а с рендерингом заняли бы около 11 часов. Авторы разделили политику на две части: зрение превращает историю кадров в восьмимерный латентный вектор, который описывает динамику коробки, а контроллер по этому вектору и состоянию робота 50 раз в секунду выдаёт целевые углы для 29 суставов. Обучение идёт в симуляторе Isaac Lab в три этапа:
- Управление телом. Политика-учитель получает положение и скорость коробки и учится ловить её методом PPO. Данные о коробке зашумлены, пропадают и запаздывают, как на реальном роботе. Награда поощряет выход навстречу, удержание коробки предплечьями у груди и долгий захват. Гуманоидный робот повторяет движения людей, перенесённые на его скелет (ретаргетинг), а состязательный приор движений (AMP) добавляет награду, если дискриминатор не может отличить движение робота от человеческого;
- Динамика коробки. Привилегированный энкодер получает данные о коробке прямо из симулятора, но с задержкой 20-60 мс и пропусками, как у камеры, и сжимает их в вектор z. Сначала контроллер копирует действия учителя (behavior cloning), а потом действует сам, и учитель подсказывает ему верные действия (DAgger). В конце его дообучают через PPO;
- Зрение. Визуальный энкодер учится предсказывать тот же z по 25 последним RGB-D кадрам 192×144 и собственному движению камеры (ego-motion). Свёрточная нейросеть отмечает коробку на тепловой карте, а рекуррентная сеть GRU следит за ней во времени. Контроллер заморожен, поэтому вместо RL здесь обычная регрессия с учителем, и рендерить нужно всего около 1.6 млн шагов.
Результаты: гуманоидный робот против людей
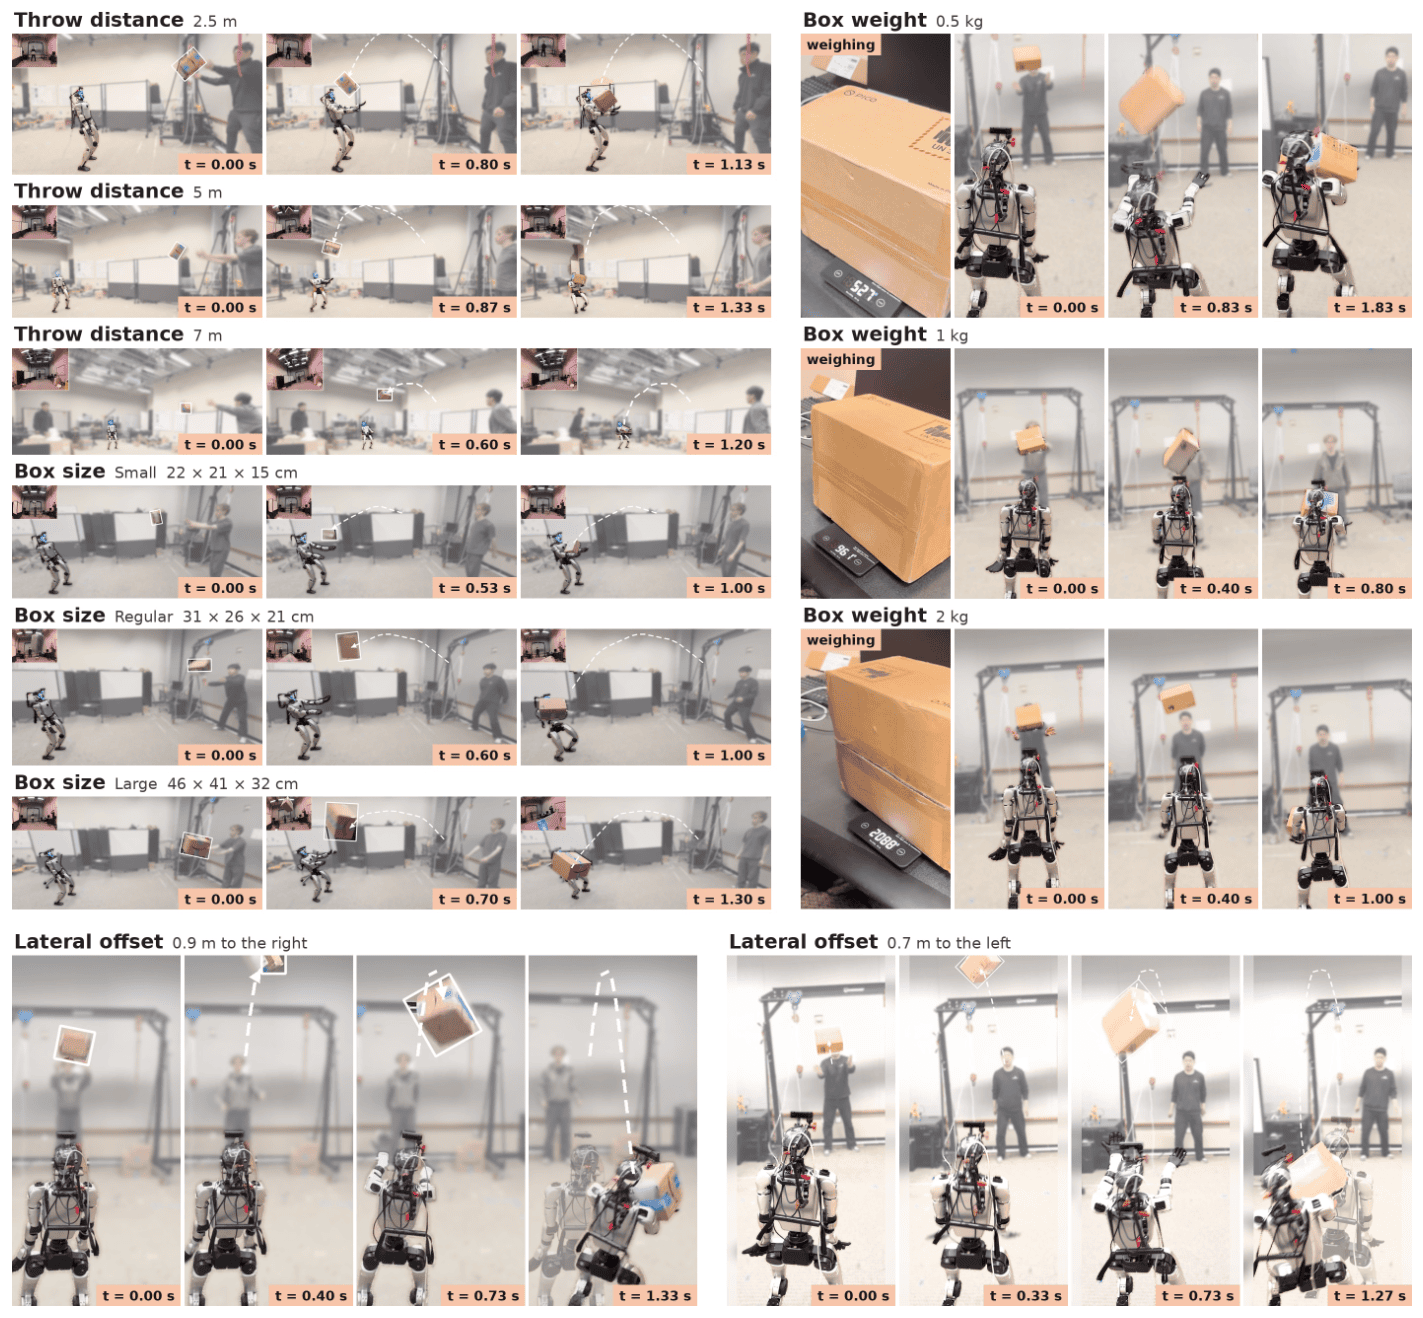
На реальном роботе Unitree G1 каждое условие проверяли всего 20 бросками, так что погрешность доходит до ±20 пунктов. С 2.5 метров гуманоидный робот поймал 65% бросков, с 5 метров 40%, с 7 метров 15%. Трое людей на тех же дистанциях ловили 85%, 68% и 28%, то есть с 7м коробку плохо ловят все. Маленькую и большую коробки, а также утяжелённые до 2 кг робот ловил реже: от 20% до 60% бросков. Даже когда коробку бросали не прямо в робота, а левее или правее, он поймал 8 бросков из 20.
После ловли управление переходит к готовому контроллеру движений SONIC: робот несёт коробку 7.8 м, отдаёт человеку и возвращается на 7.3 м назад. Из 20 попыток ловля удалась в 65%, перенос в 35%, передача в 30%, а весь цикл с возвращением в 25%.
Что важно внутри
В симуляции без истории кадров энкодер не видит движения: с одним кадром успех падает с 85.2% до 49.6% на бросках в центр и с 66.6% до 26.8% при смещении на 0.6 м. Без ego-motion получается 74.8% и 44.0%, без разметки тепловой карты 77.8% и 55.7%. Если учить зрение предсказывать полное состояние коробки вместо латента, успех падает до 66.5% и 47.1%.
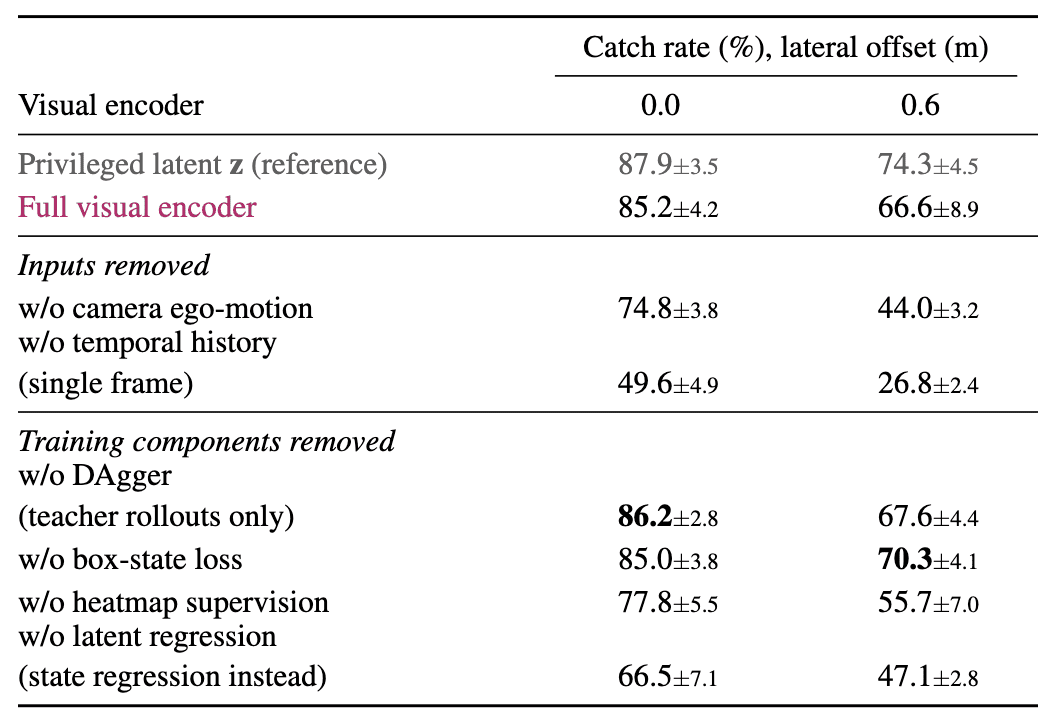
Без первого этапа контроллер, обученный с нуля, ловит лишь 6.7% коробок. Клонирование поведения на втором этапе даёт в среднем на 5.2 пункта больше, чем простой перенос весов учителя. Рандомизация задержки добавляет 5-11 пунктов, а аугментация цвета поднимает успех на синих и чёрных коробках с 60.2% и 61.2% до 88.0% и 88.8%.
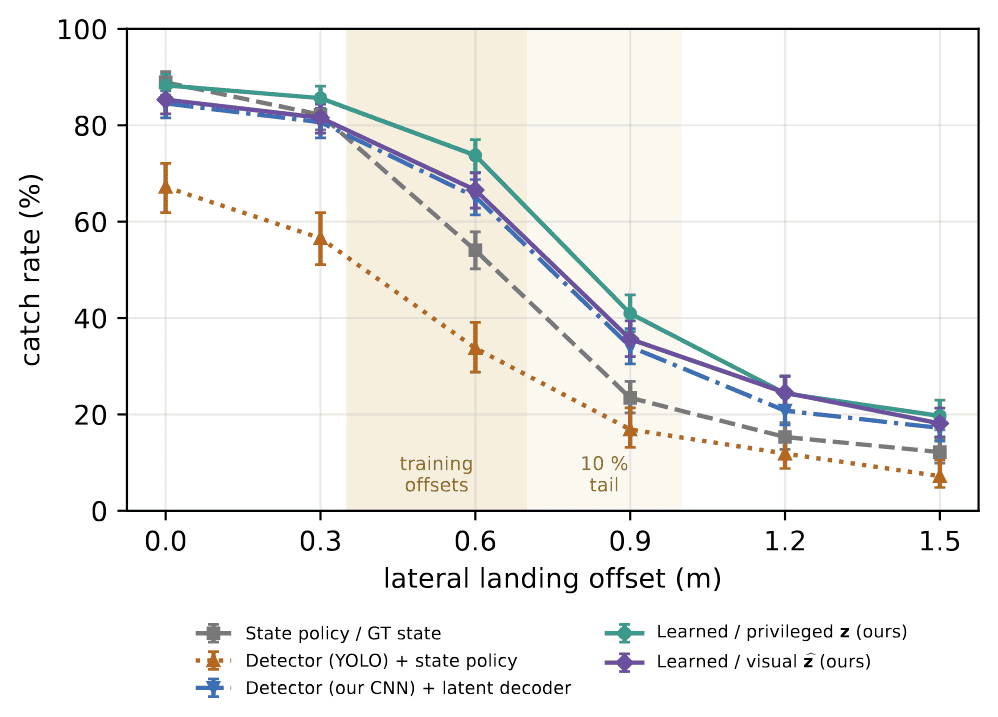
При боковом смещении точки падения визуальный контроллер обходит учителя первого этапа, которому дают точное состояние коробки: 66.6% против 54.1% на 0.6 м и 35.6% против 23.4% на 0.9 м. Прибавку дал PPO на втором этапе. Авторы собрали и классическую связку: та же свёрточная сеть как детектор, фильтр Калмана и политика первого этапа. На дистанциях из обучения Reflex обошёл её во всех 13 условиях, на 5.0-15.6 пункта. Но если отфильтрованное состояние подать в декодер Reflex, разрыв сокращается до 1.5 пункта в среднем: выигрыш даёт латентный интерфейс второго этапа, а обученный временной фильтр работает на уровне настроенного фильтра Калмана.
Ограничения
Главное слабое место: дальние броски. Третий этап учили на бросках с 3.0-3.5 м, и на 5 м в симуляции визуальный контроллер ловит 43.0% против 79.7% с привилегированными данными. Если добавить в данные броски с 2.5-7 м, успех на 5 м растёт до 75.8%, но на реальном роботе это пока не проверяли. Контроллер не знает размер коробки: маленькие и большие коробки в симуляции он перехватывает в 58.1% и 86.1% случаев, а удерживает только в 25.5% и 39.7%. Реальная задержка, измеренная для варианта с детектором YOLO, выходит за диапазон 20-60 мс из обучения. Рендеринг не моделирует размытие в движении и автоэкспозицию. Авторы видят в ловле коробки пример более широкого класса навыков, где тело готовится до контакта: перехвата, уклонения, передачи предметов и помощи человеку.