Исследователи из Nanjing University, JD.com и ещё шести китайских университетов представили VideoJev, семейство видеомоделей, которые отвечают на вопросы по видео в сотню раз быстрее моделей в режиме рассуждений (Thinking) и почти так же точно. Представьте помощника, который через камеру следит за готовкой и всё время проверяет, добавили ли уже шоколад и какой шаг рецепта идёт сейчас. Видеомодель с режимом рассуждений тратит на каждый ответ около 2.5 минуты. VideoJev работает в двух режимах: выбирает из вариантов ответа, которые передают вместе с вопросом, или находит нужный момент в видео по описанию (temporal grounding). Она выдает ответ за 1.1-1.5 секунды, а точность в среднем почти не отличается от ответов моделей с режимом рассуждений. Сам ролик модель прогоняет через себя один раз, сколько бы вопросов к нему ни задали.
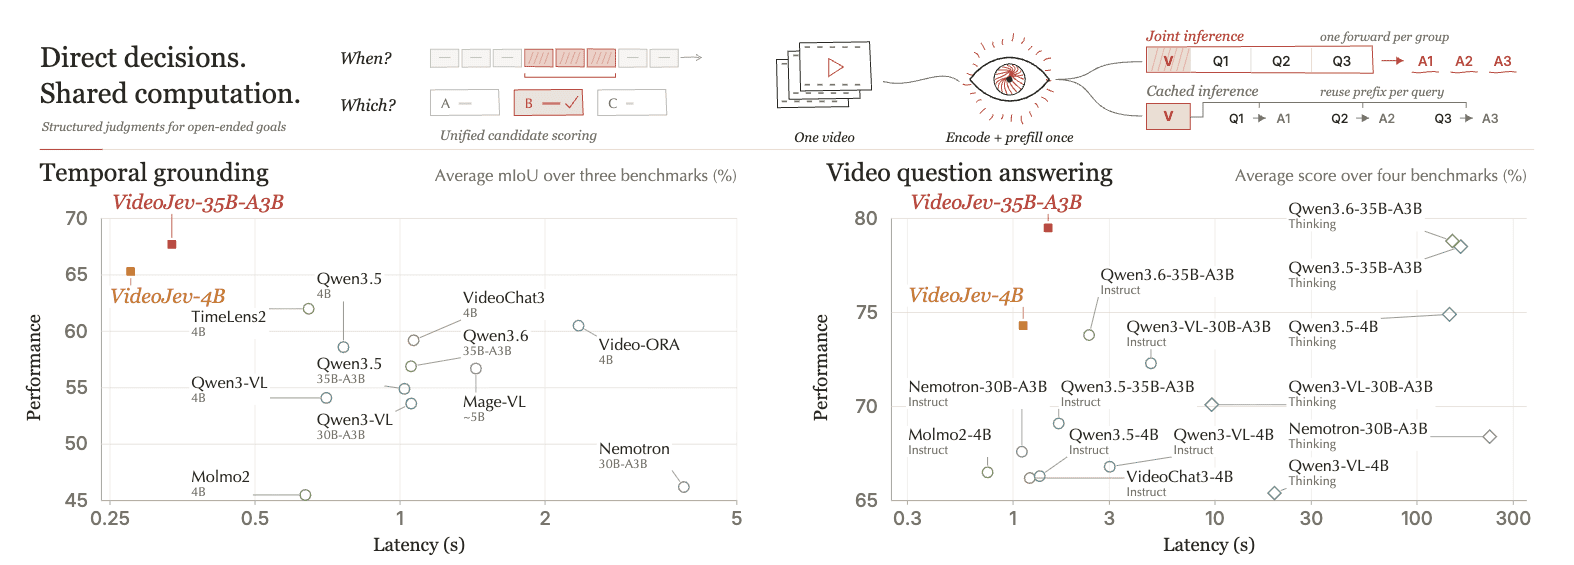
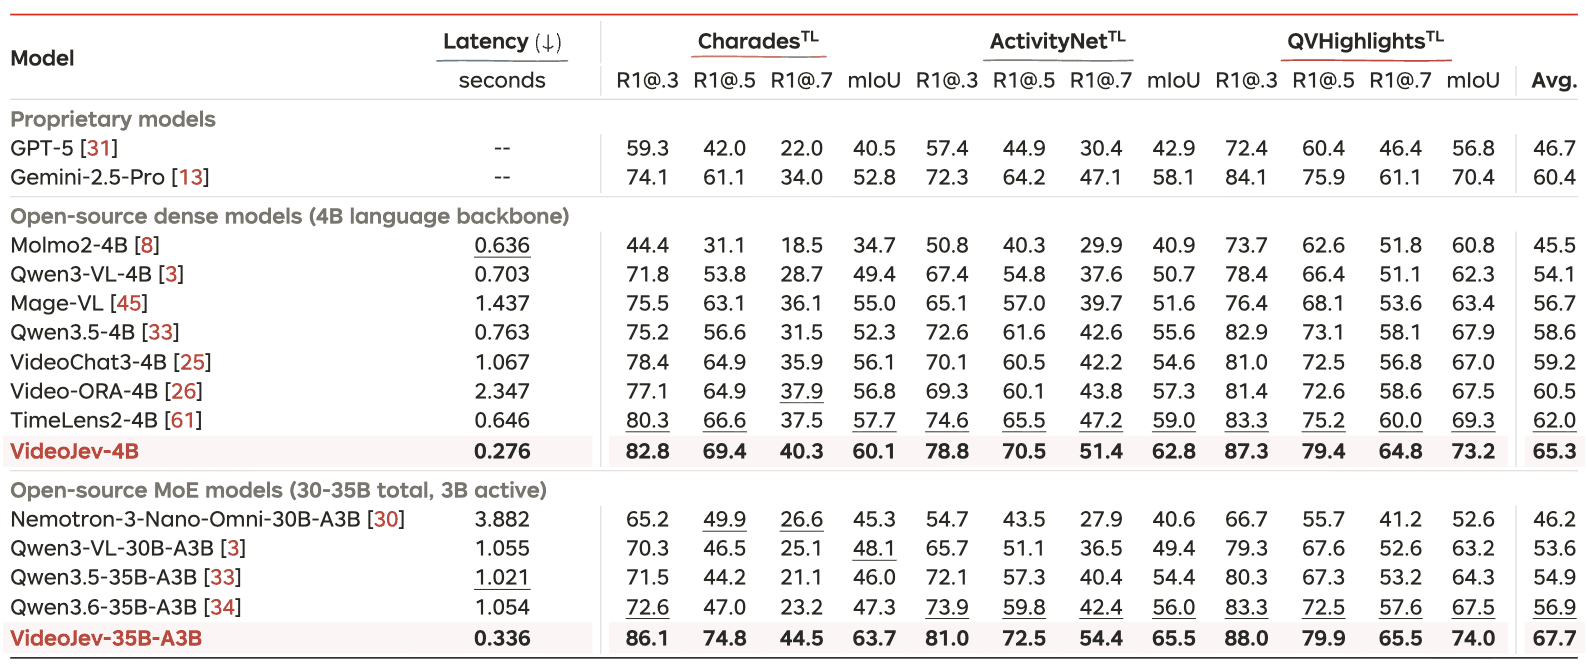
В поиске событий VideoJev-4B и VideoJev-35B-A3B подняли средний mIoU (насколько найденный отрезок совпадает с правильным) на 6.7 и 10.8 пункта относительно базовых Qwen3.5-4B и Qwen3.6-35B-A3B и работают в 2.8-3.1 раза быстрее. Младшая модель (65.3 mIoU) обошла специализированную TimeLens2-4B (62.0) и Gemini 2.5 Pro (60.4). Веса обеих моделей и код обучения, инференса и оценки открыты под лицензией Apache 2.0. Датасеты для поиска событий открыты, а корпус из 240 тысяч вопросов для QA не опубликован. Модели и датасеты опубликованы на Hugging Face, код на GitHub, больше примеров на странице проекта.
Как VideoJev отвечает на вопросы по видео
Генерацию, на которой работают обычные видео-MLLM, авторы убрали совсем: сняли с Qwen3.5 и Qwen3.6 голову, которая предсказывает следующий токен, и поставили на её место оценщик вариантов. Поэтому VideoJev не может написать ни слова: на выходе у неё только числа, по одной оценке на каждый вариант. Зато ответ всегда берётся из заданного списка и идёт с вероятностью, которую программа использует напрямую.
Варианты для вопросов модель не придумывает и заранее не знает. На бенчмарках их берут из датасета, а в приложении их задаёт код разработчика или LLM. Загрузить в VideoJev весь словарь, чтобы она собирала ответ сама, не получится. Ответ обычно состоит из нескольких слов, а собрать фразу можно только слово за словом, то есть генерацией. Кроме того, каждый вариант занимает место в контексте: из 256 тысяч токенов до 80% уходит на кадры видео, а учили VideoJev на вопросах с 4-5 вариантами.
Поэтому у VideoJev два способа работы:
- Сама по себе. Поиску момента готовые варианты не нужны. Выбор из известного списка тоже обходится без LLM, если список задаёт код: шаги рецепта или инструкции, классы действий, состояния сцены, ответы «да» и «нет»;
- В связке с LLM. На открытый вопрос вроде «что происходит в ролике?» VideoJev своими словами не ответит. Тогда LLM решает, что спросить, и предлагает варианты, а VideoJev быстро сверяет их с видео.
Идею авторы взяли у компании TypeSafe AI: её модель Jev тоже не пишет текст, а выдаёт вероятности заданных вариантов. Такие модели называют System One, по книге Даниэля Канемана «Думай медленно… решай быстро»: System One принимает быстрые интуитивные решения, а System Two медленно рассуждает. В связке LLM играет роль System Two, а VideoJev роль System One.
Как устроена VideoJev
В основе лежит предобученная видео-MLLM: плотная Qwen3.5-4B или Qwen3.6-35B-A3B со смесью экспертов (MoE), где на каждый токен работают около 3 из 35 млрд параметров. Вместе с головой у неё убирают MLP последнего слоя, так как признаки до него лучше передают смысл.
На вход идут токены видео, инструкция, вопрос и кандидаты. После каждого кандидата стоит новый токен <|option_end|>, после списка токен <|decide|>. Их скрытые состояния проецируются в нормированные векторы размерности 512: u для решения и vi для кандидатов. Оценка кандидата равна si = 10·u⊤vi + b, где b обучаемый сдвиг. Это похоже на механизм внимания: решение служит запросом (query), а кандидаты ключами (key).
Для поиска событий кандидатами служат метки времени, которые модель и так видит рядом с кадрами. Каждая обозначает отрезок из двух кадров, а сигмоида от оценки даёт вероятность, что он входит в событие. В QA роль кандидатов играют варианты ответа, а софтмакс превращает их оценки в вероятности.
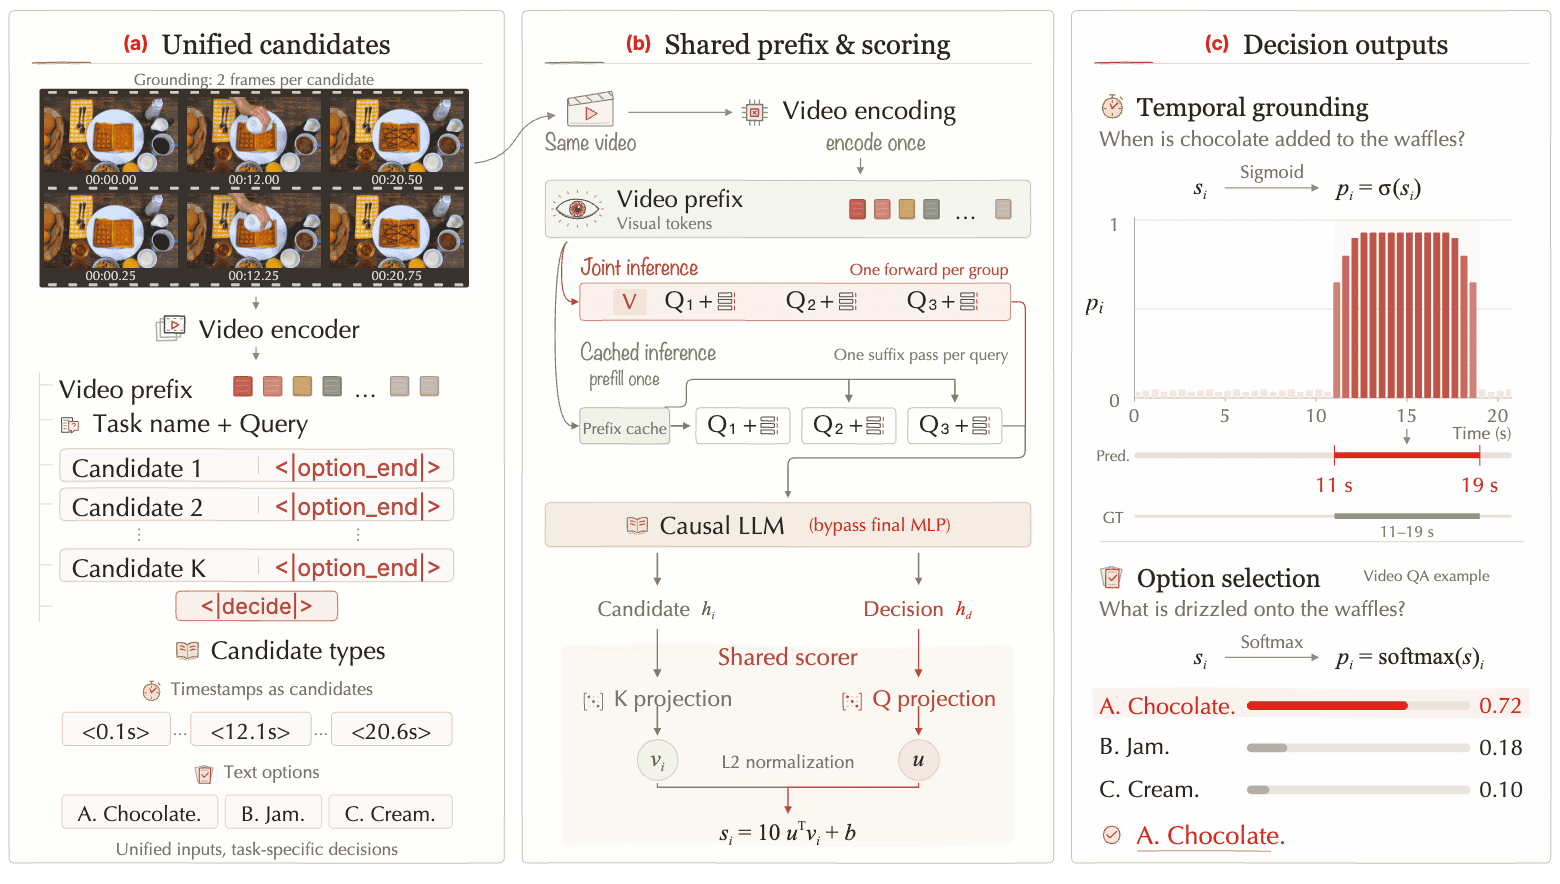
Отрезок при обучении считается положительным, если его середина лежит внутри события. Бинарная кросс-энтропия (BCE) учит каждую оценку отдельно, а функция потерь soft IoU награждает за покрытие всего события и штрафует за срабатывания вне его. На инференсе модель ищет непрерывный участок с максимальной суммой логитов за вычетом порога: это задача о максимальном подмассиве, которую алгоритм Кадане решает за линейное время. В QA варианты при обучении перемешивают, чтобы модель не запоминала позицию правильного ответа. Сначала на 30% видео учат только голову, затем на остальных 70% дообучают и языковую часть.
Вопросы по видео без повторного кодирования
При каузальном внимании токены видео стоят в начале и не зависят от вопросов после них. Поэтому видео достаточно один раз прогнать через модель (prefill) и сохранить результат в KV-кэше. Режимов инференса два:
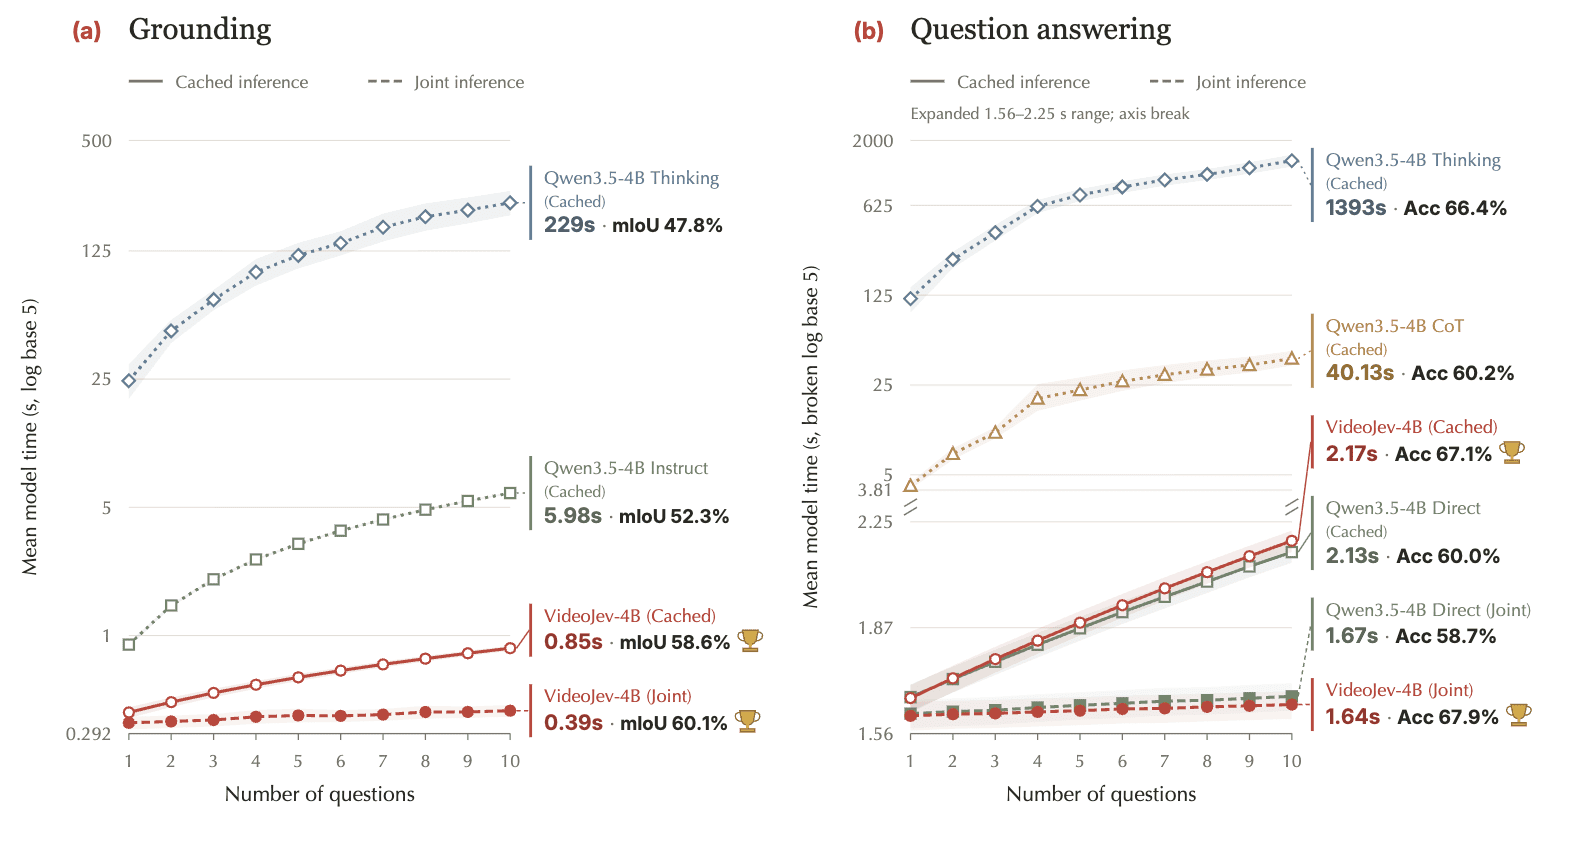
- Cached inference. Вопросы приходят по одному, и на каждый нужен один прямой проход только по его тексту и кандидатам;
- Joint inference. Все вопросы ставят друг за другом после видео, и один проход выдаёт оценки для всех. Поздние вопросы видят текст ранних, но не их ответы.
Joint inference даже немного точнее: лучше в 13 из 14 сравнений. Авторы связывают это с обучением в том же формате. У VideoJev-4B переход от одного вопроса к десяти добавляет 55 мс на поиск событий и 31 мс на QA. Десять запросов на поиск событий она обрабатывает за 0.39 секунды с mIoU 60.1, а Qwen3.5-4B за 5.98 секунды без рассуждений и за 229 секунд с ними, с mIoU 52.3 и 47.8.
Результаты: поиск событий и вопросы по видео
Поиск событий проверяли на Charades-STA, ActivityNet Captions и QVHighlights. VideoJev-4B набрала в среднем 65.3 mIoU при 0.276 секунды на запрос, VideoJev-35B-A3B 67.7 при 0.336 секунды. Обе версии лучшие по всем метрикам и самые быстрые среди открытых моделей своего размера. Базовые модели в замерах тоже переиспользуют префикс видео, так что ускорение дал именно отказ от генерации таймкодов.
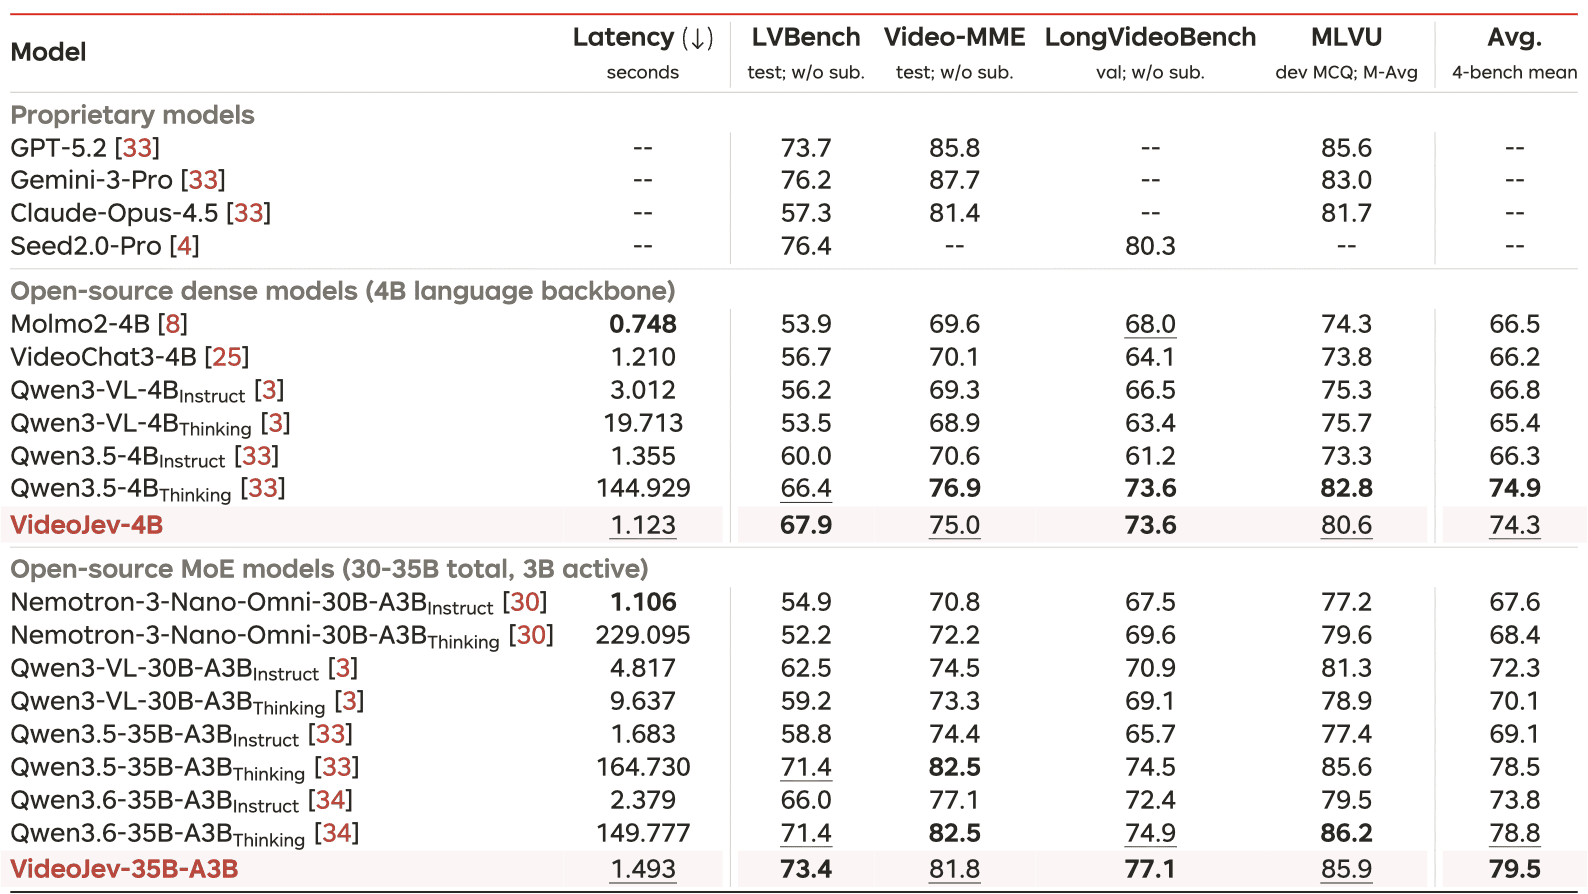
Вопросы по видео проверяли на LVBench, Video-MME, LongVideoBench и MLVU без субтитров и звука. Относительно базовых моделей без рассуждений (Instruct) VideoJev прибавила 8.0 и 5.7 пункта. VideoJev-4B уступает Qwen3.5-4B Thinking 0.6 пункта, а VideoJev-35B-A3B обходит Qwen3.6-35B-A3B Thinking на 0.7. Thinking сильнее на Video-MME и MLVU, зато на LVBench, где ролики длятся в среднем 68 минут, выигрывает VideoJev.
Что важно внутри
Обычная Qwen3.5-4B, которую дообучили генерировать ответы на тех же данных, отстала от VideoJev-4B на 1.3 пункта mIoU и 1.9 в QA, так что дело не только в данных. Soft IoU поднял mIoU с 60.7 до 65.3, а совместное обучение двух задач улучшило результат на всех семи бенчмарках.
Уверенность модели
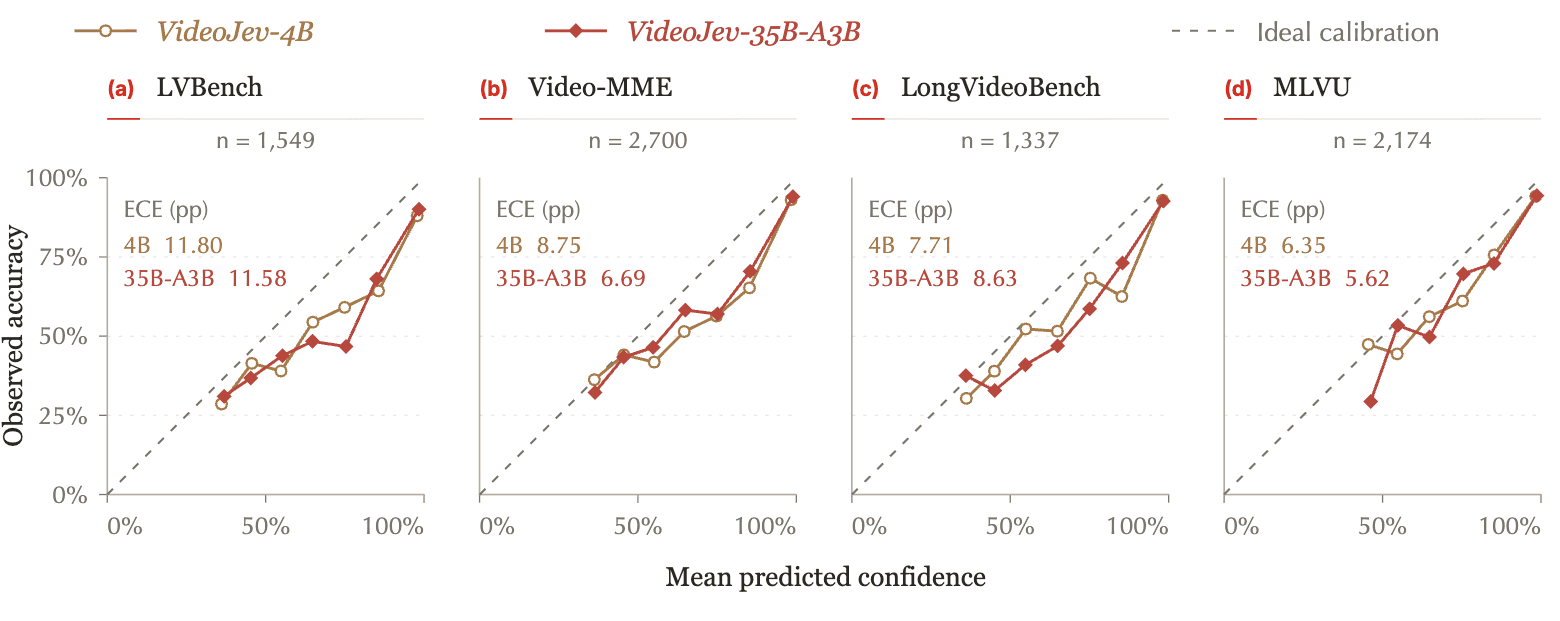
Оценки кандидатов работают как уверенность. На LVBench старшая версия уверена хотя бы на 99% в 591 ответе, и среди них верны 95.8% против 73.4% в среднем. Такие ответы агент может принимать сразу, а сомнительные отдавать модели с рассуждениями. Но вероятности завышены: ожидаемая ошибка калибровки (ECE) у младшей и старшей версий равна 8.65 и 8.13 процентного пункта. На калибровку VideoJev специально не обучали, в отличие от Jev.
Ограничения
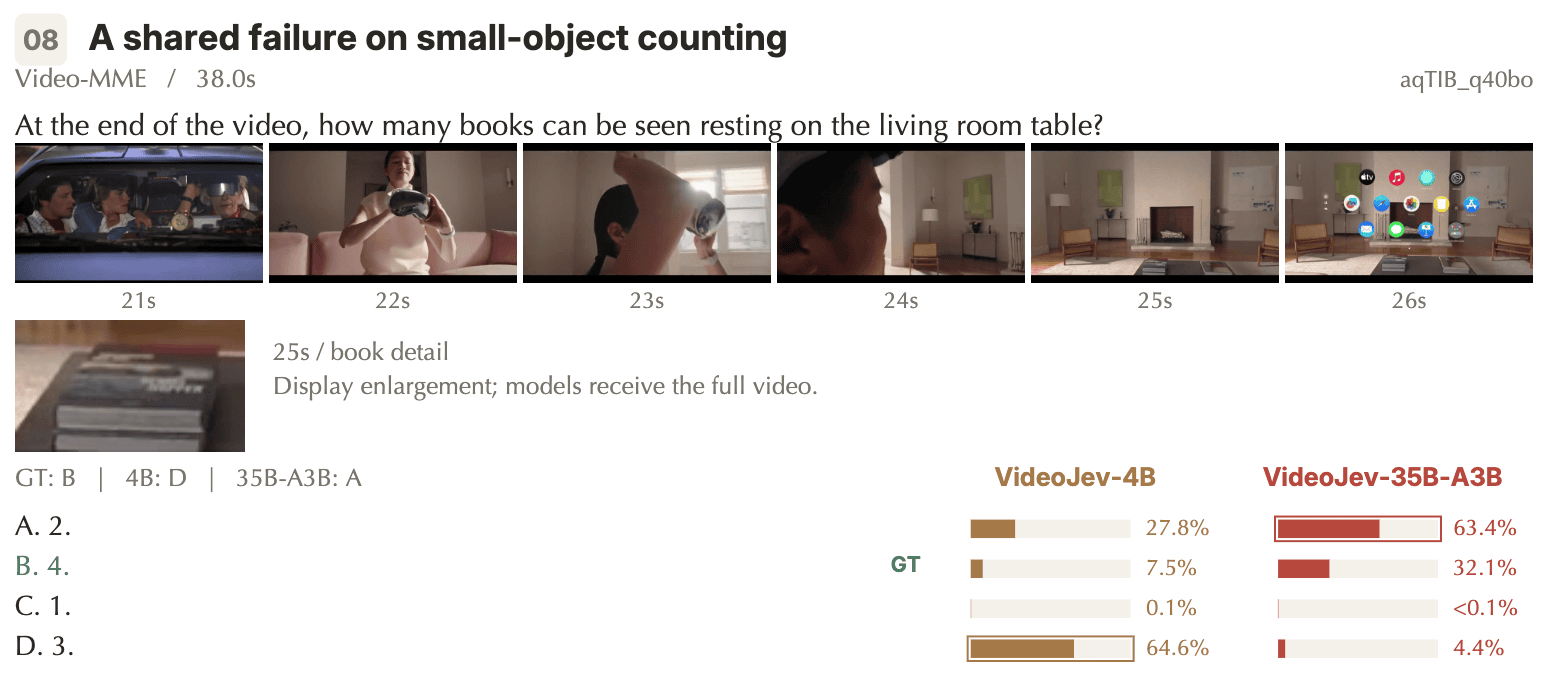
Кроме открытых ответов, VideoJev не умеет ещё двух вещей: находить несколько отрезков на один запрос и работать с потоковым видео. Мелкие объекты обе версии считают плохо: на вопрос о числе книг на столе они ответили «3» и «2» вместо «4».
Задержку мерили только для прямых проходов на H200, без декодирования видео, так что на практике ответ займёт больше времени. Авторы видят в VideoJev не ассистента, а быстрый компонент для мониторинга процедур, интерактивных помощников, роботов и агентов, которые работают за компьютером.