Статья полностью обновлена в октябре 2026 года. Первая версия 2018 года была переводом туториала «A PyTorch tutorial – deep learning in Python» из блога Adventures in Machine Learning; с тех пор PyTorch сильно изменился, поэтому текст и весь код написаны заново и проверены на PyTorch 2.14.
PyTorch — самый популярный фреймворк глубокого обучения в 2026 году. На нём написано большинство научных статей, почти все открытые большие языковые модели и инструменты вокруг них, от Hugging Face Transformers до vLLM. Его любят за то, что он ощущается как обычный Python: вы создаёте тензоры, вызываете функции, пишете циклы, а градиенты PyTorch считает сам.
В этом туториале мы пройдём путь от установки до обученной нейронной сети. Установим PyTorch с видеокартой и без, разберёмся с тензорами и автоматическим дифференцированием, соберём небольшую свёрточную сеть на nn.Module, загрузим данные через Dataset и DataLoader, напишем цикл обучения, сохраним и загрузим модель и ускорим её через torch.compile. Каждый фрагмент кода запущен, под ним — настоящий вывод. Набор данных входит в scikit-learn, так что скачивать ничего не нужно.
Коротко
- Установка:
pip install torch; для видеокарт NVIDIA выберите сборку с CUDA на pytorch.org. PyTorch 2.15 требует Python 3.11 или новее. - Тензоры — массивы как в NumPy, которые умеют работать на GPU.
- Autograd запоминает операции и считает градиенты одним вызовом
loss.backward(). - Модель — класс-наследник
nn.Module; данные приходят батчами изDataLoader. - Цикл обучения всегда одинаковый: прямой проход, функция потерь,
zero_grad(),backward(),step(). Наша небольшая CNN за 20 эпох на CPU достигает точности 96,4% на валидации.
Что такое PyTorch
PyTorch — это открытый фреймворк глубокого обучения для Python. Facebook AI Research выпустила его в 2016 году как преемника библиотеки Torch, написанной на Lua. В 2018 году вышла версия 1.0, в которую влился Caffe2 для работы в продакшне, а с 2022 года проектом управляет PyTorch Foundation в составе Linux Foundation. Текущая версия, 2.15, вышла 28 октября 2026 года.
PyTorch даёт три вещи: тензоры — многомерные массивы, которые работают на CPU и GPU; автоматическое дифференцирование, которое считает градиенты любых вычислений; и строительные блоки нейросетей — слои, функции потерь, оптимизаторы и средства загрузки данных. Вокруг него выросла большая экосистема: torchvision и torchaudio для изображений и звука, Hugging Face Transformers для языковых моделей, PyTorch Lightning для организации кода обучения, ExecuTorch для телефонов.
Как установить PyTorch
PyTorch ставится через pip. Пакет называется torch:
pip install torchЧто вы получите, зависит от платформы:
- Linux: стандартная сборка с PyPI уже поддерживает видеокарты NVIDIA через CUDA.
- Windows: стандартная сборка работает только на CPU. Для видеокарты NVIDIA откройте конструктор команды на pytorch.org, выберите версию CUDA и выполните предложенную команду — она добавляет
--index-url https://download.pytorch.org/whl/cu1XX. - macOS: стандартная сборка использует GPU чипов Apple Silicon через бэкенд MPS.
- Видеокарты AMD: выберите в конструкторе сборку с ROCm (Linux).
Что проверить перед установкой:
- Версия Python. PyTorch 2.15 поддерживает Python 3.11 и новее; 2.14 — последний выпуск для Python 3.10.
- Старые видеокарты NVIDIA. Начиная с 2.15 готовые сборки с CUDA не поддерживают архитектуры Maxwell, Pascal и Volta (например, GTX 10-й серии и Tesla V100). Самое старое поддерживаемое поколение — Turing (RTX 20-й серии, T4).
- Conda. Официальных conda-пакетов PyTorch больше нет. Окружение conda использовать можно, но PyTorch внутри него ставится через pip.
- Виртуальное окружение (
python -m venv .venv) отделяет PyTorch и его объёмные библиотеки CUDA от других проектов.
Проверить установку и наличие видеокарты:
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"Если на компьютере с видеокартой NVIDIA torch.cuda.is_available() выводит False, обычно причина в сборке только для CPU или в устаревшем драйвере NVIDIA. Учиться можно и вовсе без видеокарты: весь код из туториала выполняется на процессоре за секунды. Когда понадобится больше мощности, пригодится статья о том, как выбрать видеокарту для нейросетей.
Тензоры
Тензор — основная структура данных PyTorch: многомерный массив чисел, как массив NumPy, который к тому же может храниться на GPU и отслеживать градиенты. Создание тензоров, арифметика, индексация и обмен данными с NumPy:
import numpy as np
import torch

# Создание тензоров
a = torch.zeros(2, 3)                       # 2 строки, 3 столбца нулей
b = torch.rand(2, 3)                        # равномерно распределённые числа из [0, 1)
c = torch.tensor([[1.0, 2.0, 3.0],
                  [4.0, 5.0, 6.0]])         # из списка Python
print(a.shape, a.dtype, c.device)

# Арифметика поэлементная, @ — матричное умножение
print(c + 1)
print(c * c)
print(c @ c.T)                              # (2x3) @ (3x2) -> 2x2

# Индексация и изменение формы — как в NumPy
print(c[:, 1])                              # второй столбец
print(c.reshape(3, 2))
print(c.sum(), c.mean(dim=0))               # суммы и средние

# Связь с NumPy: from_numpy использует ту же память, что и массив
arr = np.arange(4.0)
t = torch.from_numpy(arr)
t[0] = 100
print(arr, t.numpy())

# Перенос тензора на GPU, если он есть
device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
print("device:", device, c.to(device).device)
torch.Size([2, 3]) torch.float32 cpu
tensor([[2., 3., 4.],
[5., 6., 7.]])
tensor([[ 1., 4., 9.],
[16., 25., 36.]])
tensor([[14., 32.],
[32., 77.]])
tensor([2., 5.])
tensor([[1., 2.],
[3., 4.],
[5., 6.]])
tensor(21.) tensor([2.5000, 3.5000, 4.5000])
[100. 1. 2. 3.] [100. 1. 2. 3.]
device: cpu cpuЧто стоит запомнить. У каждого тензора есть форма (shape), тип (dtype; обычно float32 для входов и весов модели и int64 для меток классов) и устройство (device). Операции возможны только между тензорами на одном устройстве — это самая частая ошибка новичков при работе с GPU. torch.from_numpy использует ту же память, что и массив NumPy, поэтому изменение одного меняет и другой, как видно в выводе.
Вычислительный граф и autograd
Фреймворки глубокого обучения представляют вычисления в виде графа: узлы — это операции, а рёбра передают между ними тензоры. Вот граф для выражения a = (b + c) × (c + 2), разбитого на промежуточные шаги d = b + c и e = c + 2:
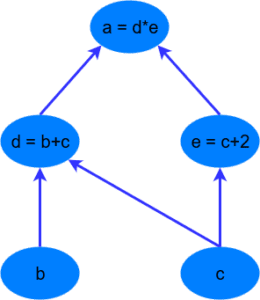
PyTorch строит такой граф на лету, пока выполняется код (это называется динамическим графом), а при вызове .backward() проходит его в обратном направлении и считает градиенты. Это и есть обратное распространение ошибки, только автоматическое. То же выражение в коде:
import torch

# a = (b + c) * (c + 2), вычислительный граф с картинки выше
b = torch.tensor(2.0, requires_grad=True)
c = torch.tensor(1.0, requires_grad=True)
d = b + c                 # промежуточный узел
e = c + 2                 # промежуточный узел
a = d * e
print("a =", a.item())

a.backward()              # обратный проход по графу заполняет .grad у каждого листа
print("da/db =", b.grad.item())   # = e = c + 2
print("da/dc =", c.grad.item())   # = e + d = (c + 2) + (b + c)
print("graph:", type(a.grad_fn).__name__, "<-", [type(f).__name__ for f, _ in a.grad_fn.next_functions])
a = 9.0
da/db = 3.0
da/dc = 6.0
graph: MulBackward0 <- ['AddBackward0', 'AddBackward0']Результаты совпадают с производными, посчитанными вручную: ∂a/∂b = c + 2 = 3 и ∂a/∂c = (c + 2) + (b + c) = 6. Тензоры, созданные с requires_grad=True, — это листья графа; после backward() их градиенты лежат в .grad. В нейросети листья — это веса, а градиенты подсказывают градиентному спуску, как их менять. В старых туториалах, включая версию этой статьи 2018 года, тензоры для этого заворачивали в объекты Variable; в PyTorch 0.4 этот API слился с тензорами и больше не нужен.
Загрузка данных: Dataset и DataLoader
PyTorch разделяет хранение данных и их подачу в модель. Dataset знает, сколько в нём примеров, и умеет вернуть пример по индексу; DataLoader собирает примеры в батчи, перемешивает их и может загружать данные в параллельных процессах. В нашем примере используется набор digits из scikit-learn: 1797 чёрно-белых изображений рукописных цифр размером 8×8 пикселей. В полном скрипте ниже класс DigitsDataset превращает изображения в тензор формы (N, 1, 8, 8) — число изображений, каналы, высота, ширина; именно такой порядок ожидают свёрточные слои. Для своих данных вы пишете те же три метода — __init__, __len__ и __getitem__ — и обычно читаете в __getitem__ файлы изображений или строки таблицы.
Нейронная сеть на nn.Module
Модель в PyTorch — это класс, унаследованный от nn.Module: слои создаются в __init__, а метод forward описывает, как через них проходят данные. В версии туториала 2018 года строилась полносвязная сеть для изображений MNIST размером 28×28: 784 входа, два скрытых слоя по 200 нейронов и 10 выходов — классический многослойный персептрон:
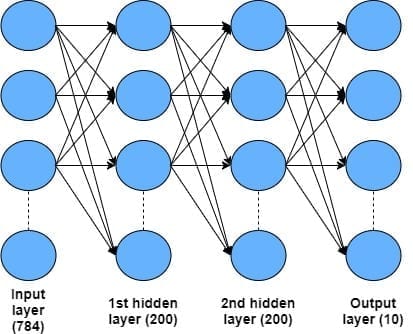
Для изображений лучше подходит свёрточная нейронная сеть, поэтому наша DigitNet состоит из двух свёрточных слоёв с функцией активации ReLU и max pooling и двух полносвязных слоёв. Комментарии в коде показывают форму данных после каждого слоя: 1×8×8 → 16×8×8 → 16×4×4 → 32×4×4 → 32×2×2 → 128 → 64 → 10 оценок, по одной на каждую цифру. Всего в сети 13 706 обучаемых параметров. Метод forward напрямую не вызывают: его запускает вызов model(x).
Цикл обучения
Ниже полный скрипт: данные, модель, циклы обучения и оценки, сохранение и загрузка. На CPU он отрабатывает за несколько секунд, а при наличии видеокарты автоматически использует её:
import json
import torch
from torch import nn
from torch.utils.data import Dataset, DataLoader
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"

# 1. Данные: 1797 чёрно-белых изображений рукописных цифр 8x8 пикселей
X, y = load_digits(return_X_y=True)
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=0, stratify=y)

class DigitsDataset(Dataset):
    def __init__(self, X, y):
        self.X = torch.tensor(X / 16.0, dtype=torch.float32).reshape(-1, 1, 8, 8)  # N x каналы x высота x ширина
        self.y = torch.tensor(y, dtype=torch.long)

    def __len__(self):
        return len(self.y)

    def __getitem__(self, i):
        return self.X[i], self.y[i]

train_loader = DataLoader(DigitsDataset(X_train, y_train), batch_size=64, shuffle=True)
val_loader = DataLoader(DigitsDataset(X_val, y_val), batch_size=256)

# 2. Модель: небольшая свёрточная сеть
class DigitNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 16, kernel_size=3, padding=1), nn.ReLU(),    # 16 x 8 x 8
            nn.MaxPool2d(2),                                          # 16 x 4 x 4
            nn.Conv2d(16, 32, kernel_size=3, padding=1), nn.ReLU(),   # 32 x 4 x 4
            nn.MaxPool2d(2),                                          # 32 x 2 x 2
        )
        self.classifier = nn.Sequential(nn.Flatten(), nn.Linear(32 * 2 * 2, 64), nn.ReLU(), nn.Linear(64, 10))

    def forward(self, x):
        return self.classifier(self.features(x))

model = DigitNet().to(device)
print("parameters:", sum(p.numel() for p in model.parameters()))
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

# 3. Циклы обучения и оценки
def train_one_epoch():
    model.train()
    total = 0.0
    for xb, yb in train_loader:
        xb, yb = xb.to(device), yb.to(device)
        loss = loss_fn(model(xb), yb)      # прямой проход
        optimizer.zero_grad()              # обнуляем старые градиенты
        loss.backward()                    # обратное распространение
        optimizer.step()                   # обновляем веса
        total += loss.item() * len(yb)
    return total / len(train_loader.dataset)

@torch.no_grad()
def evaluate():
    model.eval()
    correct = 0
    for xb, yb in val_loader:
        xb, yb = xb.to(device), yb.to(device)
        correct += (model(xb).argmax(dim=1) == yb).sum().item()
    return correct / len(val_loader.dataset)

history = []
for epoch in range(1, 21):
    train_loss = train_one_epoch()
    val_acc = evaluate()
    history.append((train_loss, val_acc))
    if epoch in (1, 2, 5, 10, 15, 20):
        print(f"epoch {epoch:2d}  train loss {train_loss:.4f}  val accuracy {val_acc:.3f}")

# 4. Сохраняем веса, загружаем их в новую модель и распознаём одно изображение
torch.save(model.state_dict(), "digitnet.pt")
restored = DigitNet().to(device)
restored.load_state_dict(torch.load("digitnet.pt", map_location=device))
restored.eval()
with torch.no_grad():
    image, label = val_loader.dataset[0]
    probs = torch.softmax(restored(image.unsqueeze(0).to(device)), dim=1)[0]
print(f"true label {label.item()}, predicted {probs.argmax().item()} with probability {probs.max().item():.3f}")
json.dump(history, open("history.json", "w"))
parameters: 13706
epoch 1 train loss 2.2875 val accuracy 0.136
epoch 2 train loss 2.1887 val accuracy 0.536
epoch 5 train loss 0.7820 val accuracy 0.850
epoch 10 train loss 0.2205 val accuracy 0.914
epoch 15 train loss 0.1175 val accuracy 0.961
epoch 20 train loss 0.0743 val accuracy 0.964
true label 7, predicted 7 with probability 0.995Сердце скрипта — внутренний цикл функции train_one_epoch, одинаковый в любом проекте на PyTorch:
- Прямой проход:
model(xb)вычисляет предсказания для батча, а функция потерь сравнивает их с метками.CrossEntropyLossпринимает «сырые» оценки (логиты) и целочисленные метки классов; добавлять перед ней softmax не нужно. optimizer.zero_grad()обнуляет градиенты предыдущего шага: по умолчанию PyTorch их накапливает.loss.backward()считает градиент функции потерь по всем 13 706 параметрам.optimizer.step()обновляет веса; Adam со скоростью обучения 0,001 — надёжный выбор по умолчанию.
Ещё две важные детали. model.train() и model.eval() переключают слои вроде dropout и batch normalization между режимами обучения и применения. А декоратор @torch.no_grad() у функции оценки отключает отслеживание градиентов, что экономит память и время, когда нужны только предсказания. Один проход по обучающим данным — это эпоха; при 1437 обучающих изображениях и батчах по 64 в эпохе 23 итерации.
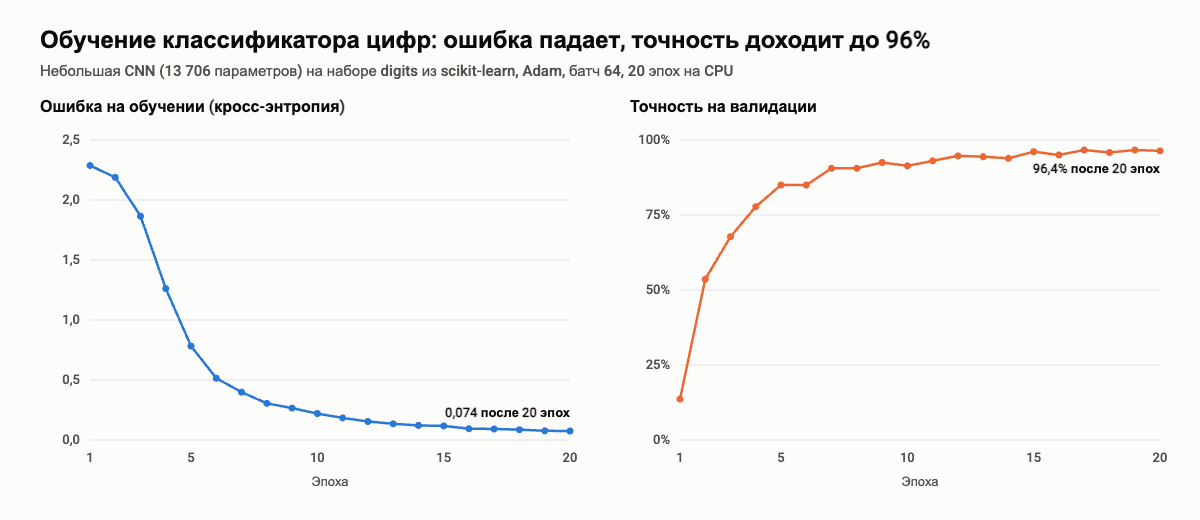
После первой эпохи сеть ещё угадывает: 13,6% точности на валидации, почти как 10% при случайном выборе из десяти цифр. К пятой эпохе она распознаёт 85% новых цифр, к пятнадцатой — больше 96%, а после 20 эпох достигает 96,4%; ошибка на обучении за это время падает с 2,29 до 0,074. Если учить дольше, ошибка на обучении продолжит снижаться, а точность на валидации почти не вырастет; следить за обеими метриками — так и замечают переобучение.
Сохранение, загрузка и предсказание
Модель рекомендуется сохранять через её state_dict — словарь со всеми весами: torch.save(model.state_dict(), "digitnet.pt"). Чтобы загрузить веса, создайте модель того же класса и вызовите load_state_dict, как в конце скрипта; параметр map_location позволяет загрузить веса, сохранённые на GPU, на машине без видеокарты. Начиная с PyTorch 2.6 torch.load по умолчанию загружает только тензоры и простые типы (weights_only=True) — это защищает от выполнения кода, спрятанного в скачанном чекпойнте.
Для предсказания переведите модель в режим оценки, добавьте размерность батча через unsqueeze(0) и превратите оценки в вероятности через softmax. Загруженная модель распознала первое изображение из валидации — семёрку — с вероятностью 0,995. Чтобы запускать модель вне Python, экспортируйте её через torch.export или в ONNX, а на телефонах — через ExecuTorch.
Ускорение: GPU, смешанная точность и torch.compile
В реальных проектах основной прирост скорости дают три вещи:
- Видеокарта. Выберите устройство один раз,
device = "cuda"(или"mps"на Mac), и переносите на него и модель (model.to(device)), и каждый батч, как в скрипте. На GPU большая модель обучается в десятки раз быстрее, чем на CPU. - Смешанная точность. Если обернуть прямой проход в
with torch.autocast(device_type="cuda", dtype=torch.bfloat16):, большинство операций выполняется в 16-битной точности на тензорных ядрах. На современных видеокартах NVIDIA это часто вдвое ускоряет обучение и вдвое сокращает расход памяти без потери точности. torch.compile. Одна строка,model = torch.compile(model), компилирует модель в оптимизированные ядра. Первый вызов медленный, потому что в этот момент идёт компиляция; дальше скомпилированная модель работает быстрее.
Быстрая проверка torch.compile на двухслойной сети с 8,4 млн параметров и батчем из 256 примеров:
import time
import torch
from torch import nn

model = nn.Sequential(nn.Linear(1024, 4096), nn.GELU(), nn.Linear(4096, 1024)).eval()
x = torch.randn(256, 1024)

compiled = torch.compile(model)            # та же модель, скомпилированная TorchInductor

def bench(f, n=50):
    with torch.no_grad():
        f(x)                                # прогрев (у скомпилированной модели здесь идёт компиляция)
        start = time.perf_counter()
        for _ in range(n):
            f(x)
    return (time.perf_counter() - start) / n * 1000

with torch.no_grad():
    print("same output:", torch.allclose(model(x), compiled(x), atol=1e-4))
print(f"eager:    {bench(model):.2f} ms per batch")
print(f"compiled: {bench(compiled):.2f} ms per batch")
same output: True
eager: 27.74 ms per batch
compiled: 24.11 ms per batchСкомпилированная модель выдаёт тот же результат и в этом запуске работает примерно на 13% быстрее. Но на нашем маленьком двухъядерном CPU разброс между запусками большой: от ускорения на 15% до небольшого замедления. На видеокартах, где компиляция объединяет множество мелких операций и экономит обращения к памяти, выигрыш обычно заметнее и стабильнее. Измеряйте на своей модели: эффект сильно зависит от архитектуры.
Что изучать дальше
- Большие наборы данных и предобученные модели: в torchvision есть загрузчики MNIST, CIFAR-10, ImageNet и предобученные сети вроде ResNet; для текстов начните с Hugging Face Transformers.
- Меньше шаблонного кода: PyTorch Lightning и Hugging Face Accelerate берут на себя циклы обучения, логирование, чекпойнты и обучение на нескольких GPU.
- Другие архитектуры с кодом на PyTorch: свёрточная нейронная сеть на PyTorch, рекуррентные сети, LSTM, вариационный автоэнкодер и GAN.
- Как всё устроено внутри: статья о том, как создать нейронную сеть с нуля на Python без фреймворков.
- Визуализация обучения:
torch.utils.tensorboardпишет логи для TensorBoard; популярные альтернативы — Weights & Biases и MLflow.
Частые вопросы
Сложно ли выучить PyTorch?
Нет, если вы знаете Python и NumPy. Основные идеи — тензоры, autograd, nn.Module, цикл обучения — помещаются в один этот туториал, а код читается как обычный Python. Больше времени уходит на само глубокое обучение: выбор архитектуры, подбор скорости обучения, борьбу с переобучением.
Нужна ли видеокарта, чтобы изучать PyTorch?
Нет. Весь код из туториала работает на процессоре ноутбука. Для моделей побольше есть бесплатные ноутбуки Google Colab и Kaggle с ограниченным временем на GPU, а облачные видеокарты можно арендовать почасово — см. сравнение облачных GPU для машинного обучения.
Как установить PyTorch с CUDA?
На Linux pip install torch уже включает CUDA. На Windows используйте команду из конструктора на pytorch.org с --index-url для вашей версии CUDA. Затем проверьте torch.cuda.is_available(); если выводится False, обновите драйвер NVIDIA или переустановите сборку с CUDA.
Чем torch отличается от PyTorch?
Ничем: PyTorch — название проекта, а torch — имя Python-пакета, который устанавливают и импортируют. torchvision и torchaudio — отдельные сопутствующие пакеты.
Что учить: PyTorch или TensorFlow?
PyTorch. В 2026 году он используется гораздо шире, а с марта 2026 года Google выпускает для TensorFlow только исправления безопасности и критических ошибок и рекомендует для новых проектов в генеративном ИИ Keras 3, JAX или PyTorch. Подробное сравнение — в статье PyTorch или TensorFlow в 2026 году.
Что такое PyTorch Lightning?
Библиотека поверх PyTorch, которая организует цикл обучения за вас: вы описываете модель, шаг обучения и оптимизатор, а Lightning берёт на себя эпохи, устройства, логирование, чекпойнты и распределённое обучение. Её стоит изучать после того, как вы несколько раз напишете цикл обучения вручную, как в этом туториале.
Python 3.9.1 (tags/v3.9.1:1e5d33e, Dec 7 2020, 17:08:21) [MSC v.1927 64 bit (AMD64)] on win32 Type «help», «copyright», «credits» or «license» for more information. >>> import torch Traceback (most recent call… Подробнее »
надо ёпт прописывать все параметры!!
даже количество эпох не указали
тут все — https://github.com/adventuresinML/adventures-in-ml-code/blob/master/pytorch_nn.py
<ipython-input-1-7892af61f44c>:46: UserWarning: Implicit dimension choice for log_softmax has been deprecated. Change the call to include dim=X as an argument. return F.log_softmax(x) --------------------------------------------------------------------------- IndexError Traceback (most recent call last) <ipython-input-1-7892af61f44c> in… Подробнее »
Прямо в ошибке ведь написали, что надо сделать.
Вместо
надо написать