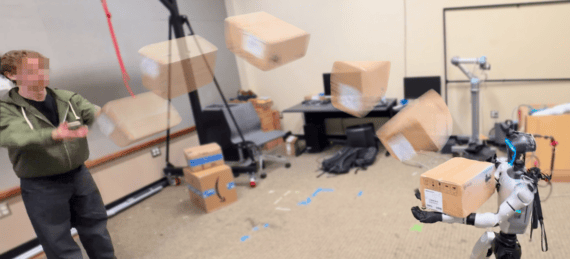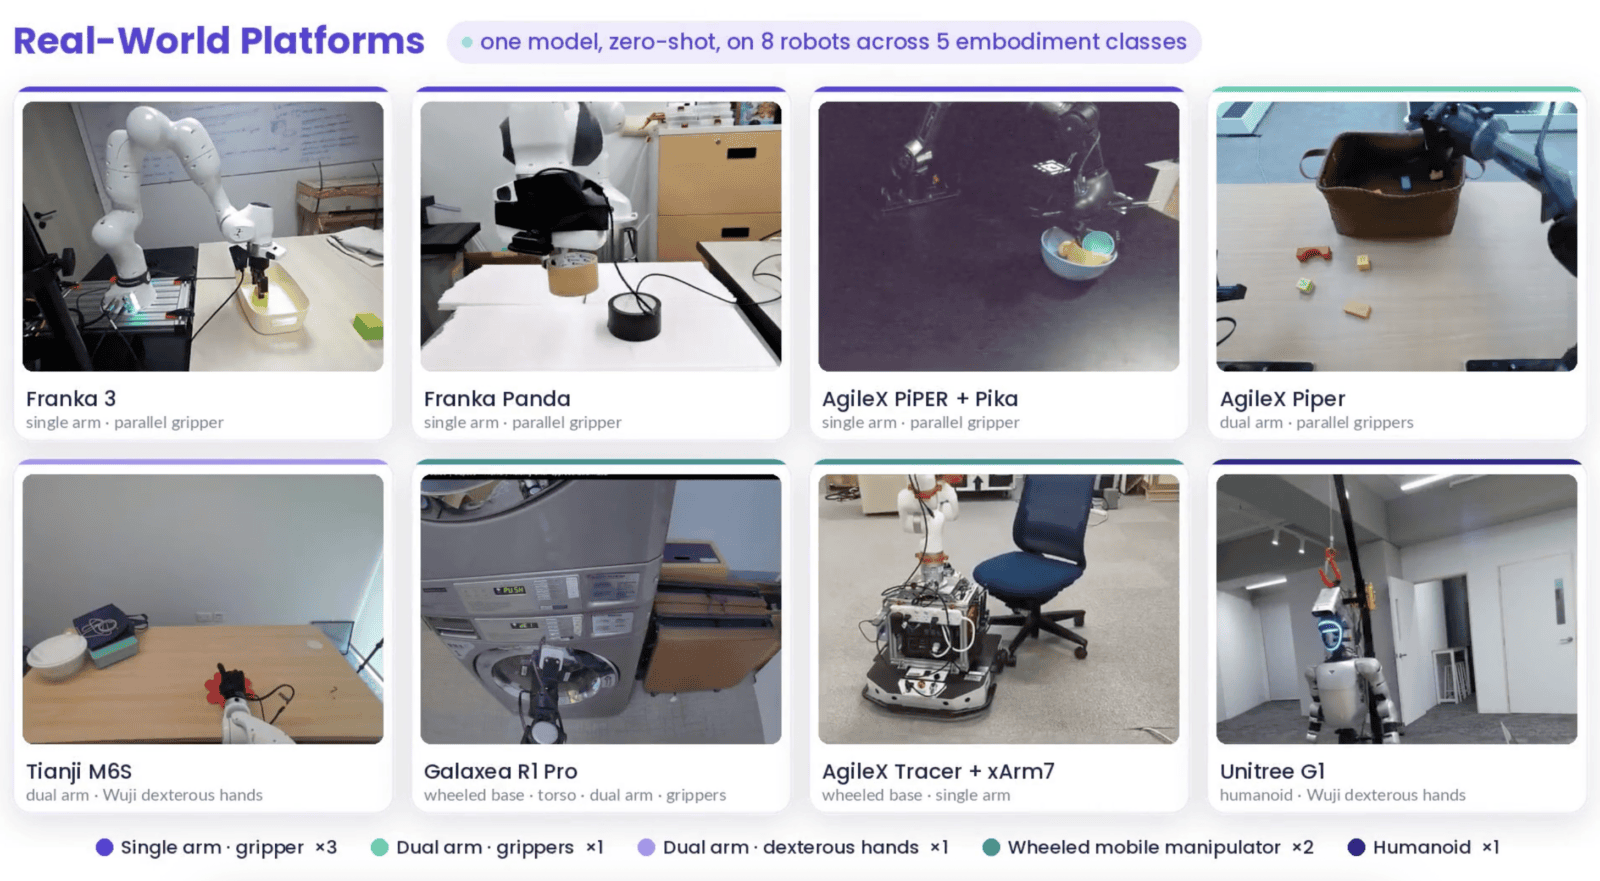
Команда SenseNova вместе с ACE Robotics, Ropedia, Nanyang Technological University и University of Tokyo опубликовала исследование, в котором проверила, достигла ли GPT-6-Astra от OpenAI воплощённого интеллекта (embodied intelligence). Воплощённый интеллект — это способность управлять роботами и выполнять задачи в физическом мире без дообучения. Astra управляла манипуляторами, многопалыми кистями, гуманоидом и навигацией на 12 бенчмарках в симуляции и на 8 реальных роботах. Короткий ответ: порог воплощённой компетентности GPT-6-Astra прошла, а порог практического воплощённого интеллекта пока нет. Проще говоря, симуляциях модель справляется, но в реальном мире все не так гладко.
Раньше роботами управляли VLA-модели (vision-language-action), которые учатся на записях решений тех же задач. GPT-6-Astra не дообучали под конкретные задачи, но на 9 из 12 бенчмарков она обошла лучшие опубликованные результаты, местами почти вдвое. С запасом шагов на исправление ошибок отрыв еще больше растёт. Но есть и слабые места: даже почти решённая задача занимает около часа, а с точным контактом на реальных роботах модель не справляется, например, ни разу не смогла вставить вилку в розетку. Авторы выложили пакеты знаний, логи 3180 тестовых эпизодов с 5888 видео (81 ГБ, лицензия MIT) для четырёх бенчмарков. Код обвязки SenseNova-RoboRSI заявлен под Apache 2.0, но пока не опубликован.
Как GPT-6-Astra управляла роботами в исследовании
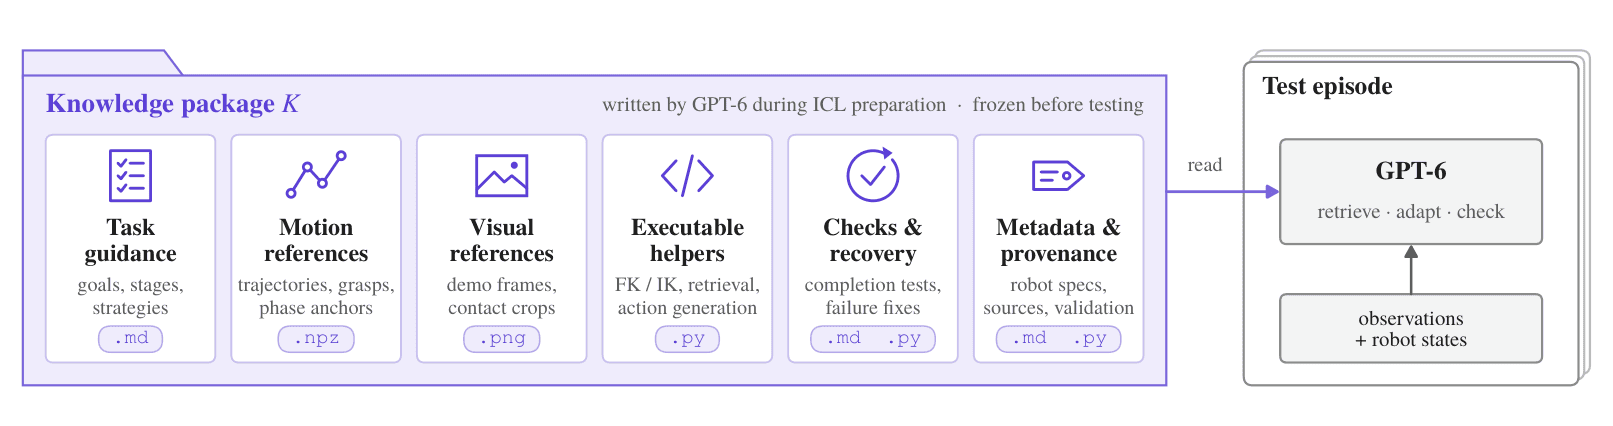
Модель работает в замкнутом цикле: смотрит на текущие кадры и состояние робота, выбирает одно действие или короткую серию. Робот их выполняет и возвращает новые наблюдения. Веса модели всё время заморожены. Протокол оценки строится на двух правилах:
- Обучение в контексте (in-context learning, ICL). VLA-модели учатся на записях решений задач, поэтому GPT-6-Astra тоже их получает. Перед тестом она изучает обучающие данные и собирает пакет знаний: этапы задачи, эталонные траектории, кадры из демонстраций, Python-код для кинематики, проверки выполнения и рецепты восстановления. Пакет знаний замораживают, и каждый тестовый эпизод начинается с чистой сессии. Это похоже на шпаргалку по разобранным задачам, которую на экзамене уже нельзя дополнять;
- Увеличенный бюджет шагов. Модели разрешают до 10 раз больше шагов, чем в правилах бенчмарка, потому что стандартный лимит часто обрывает эпизод, пока модель исправляет ошибку. Продление идёт в том же эпизоде, без сброса сцены.
Воплощённая компетентность в симуляции
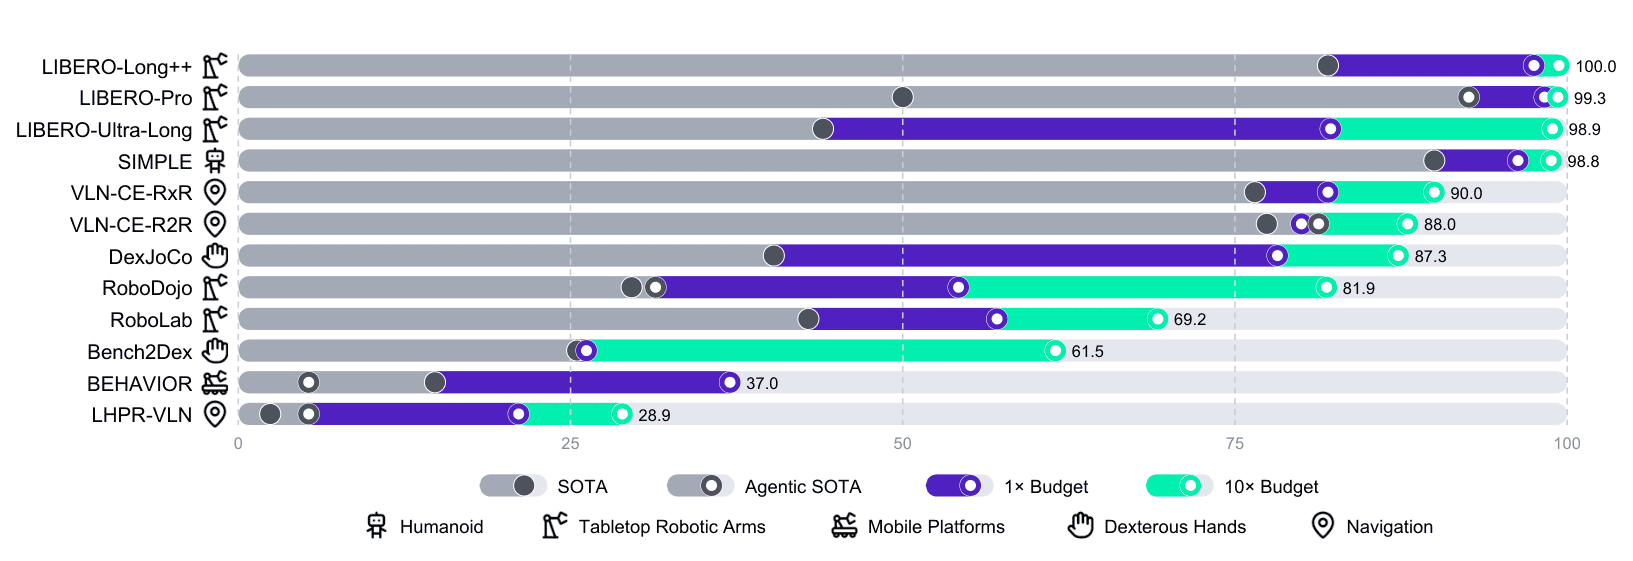
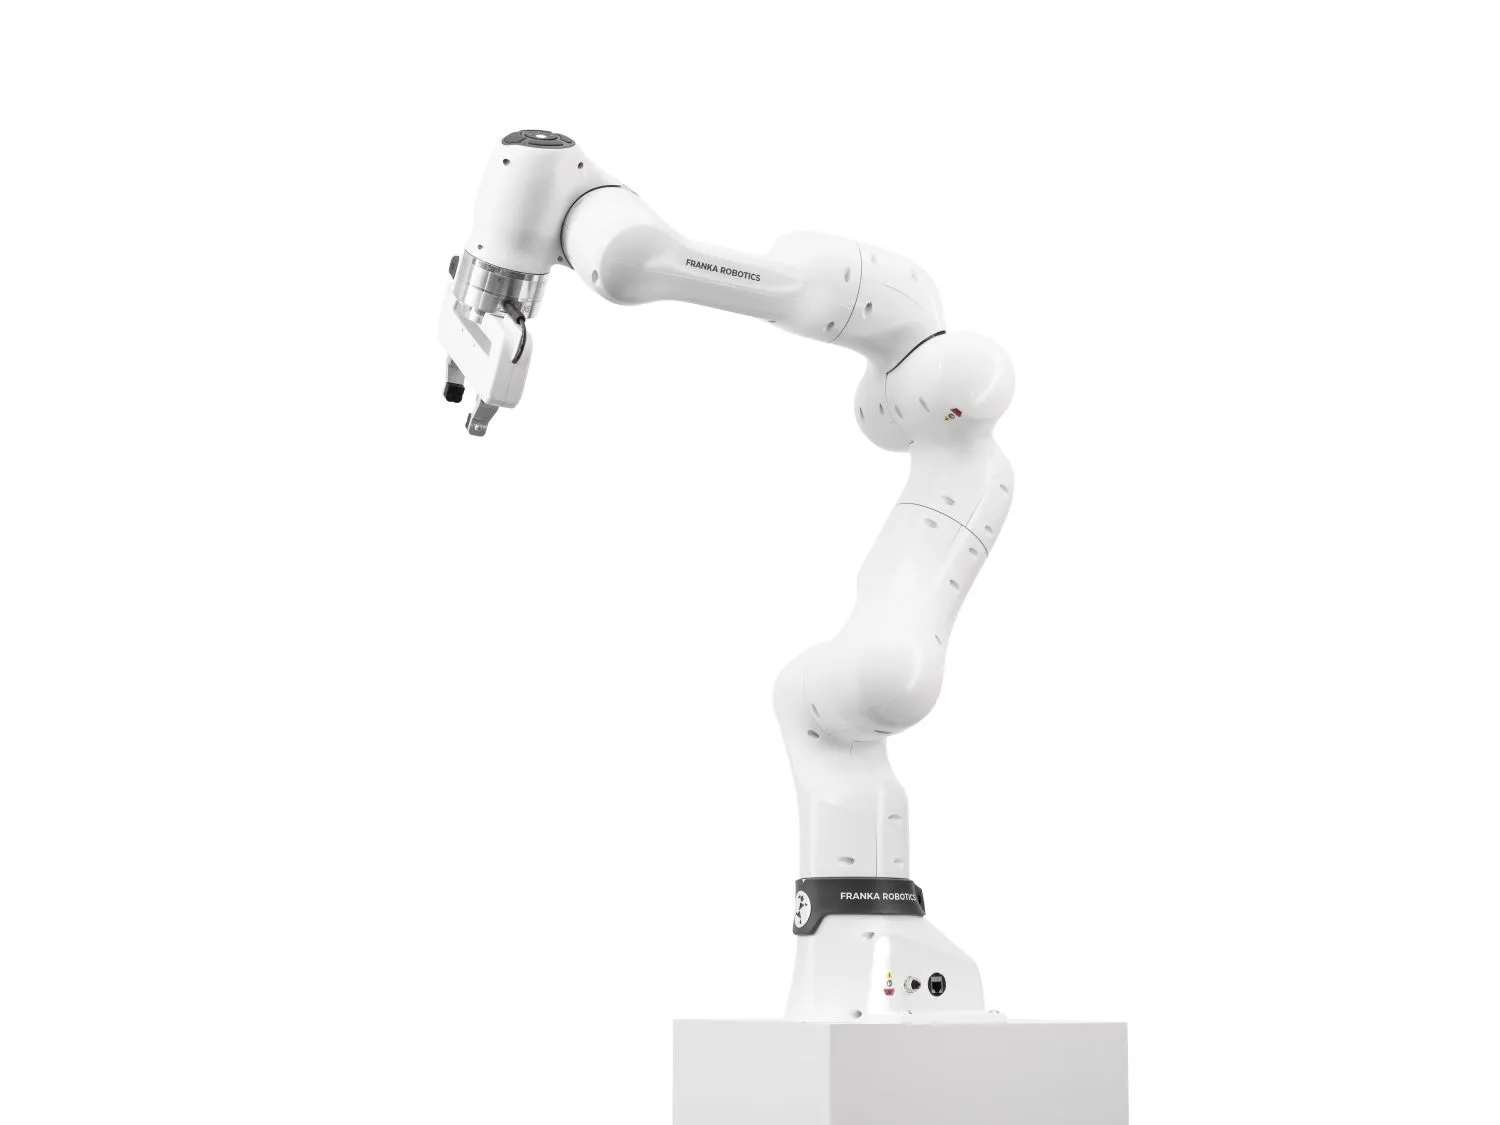
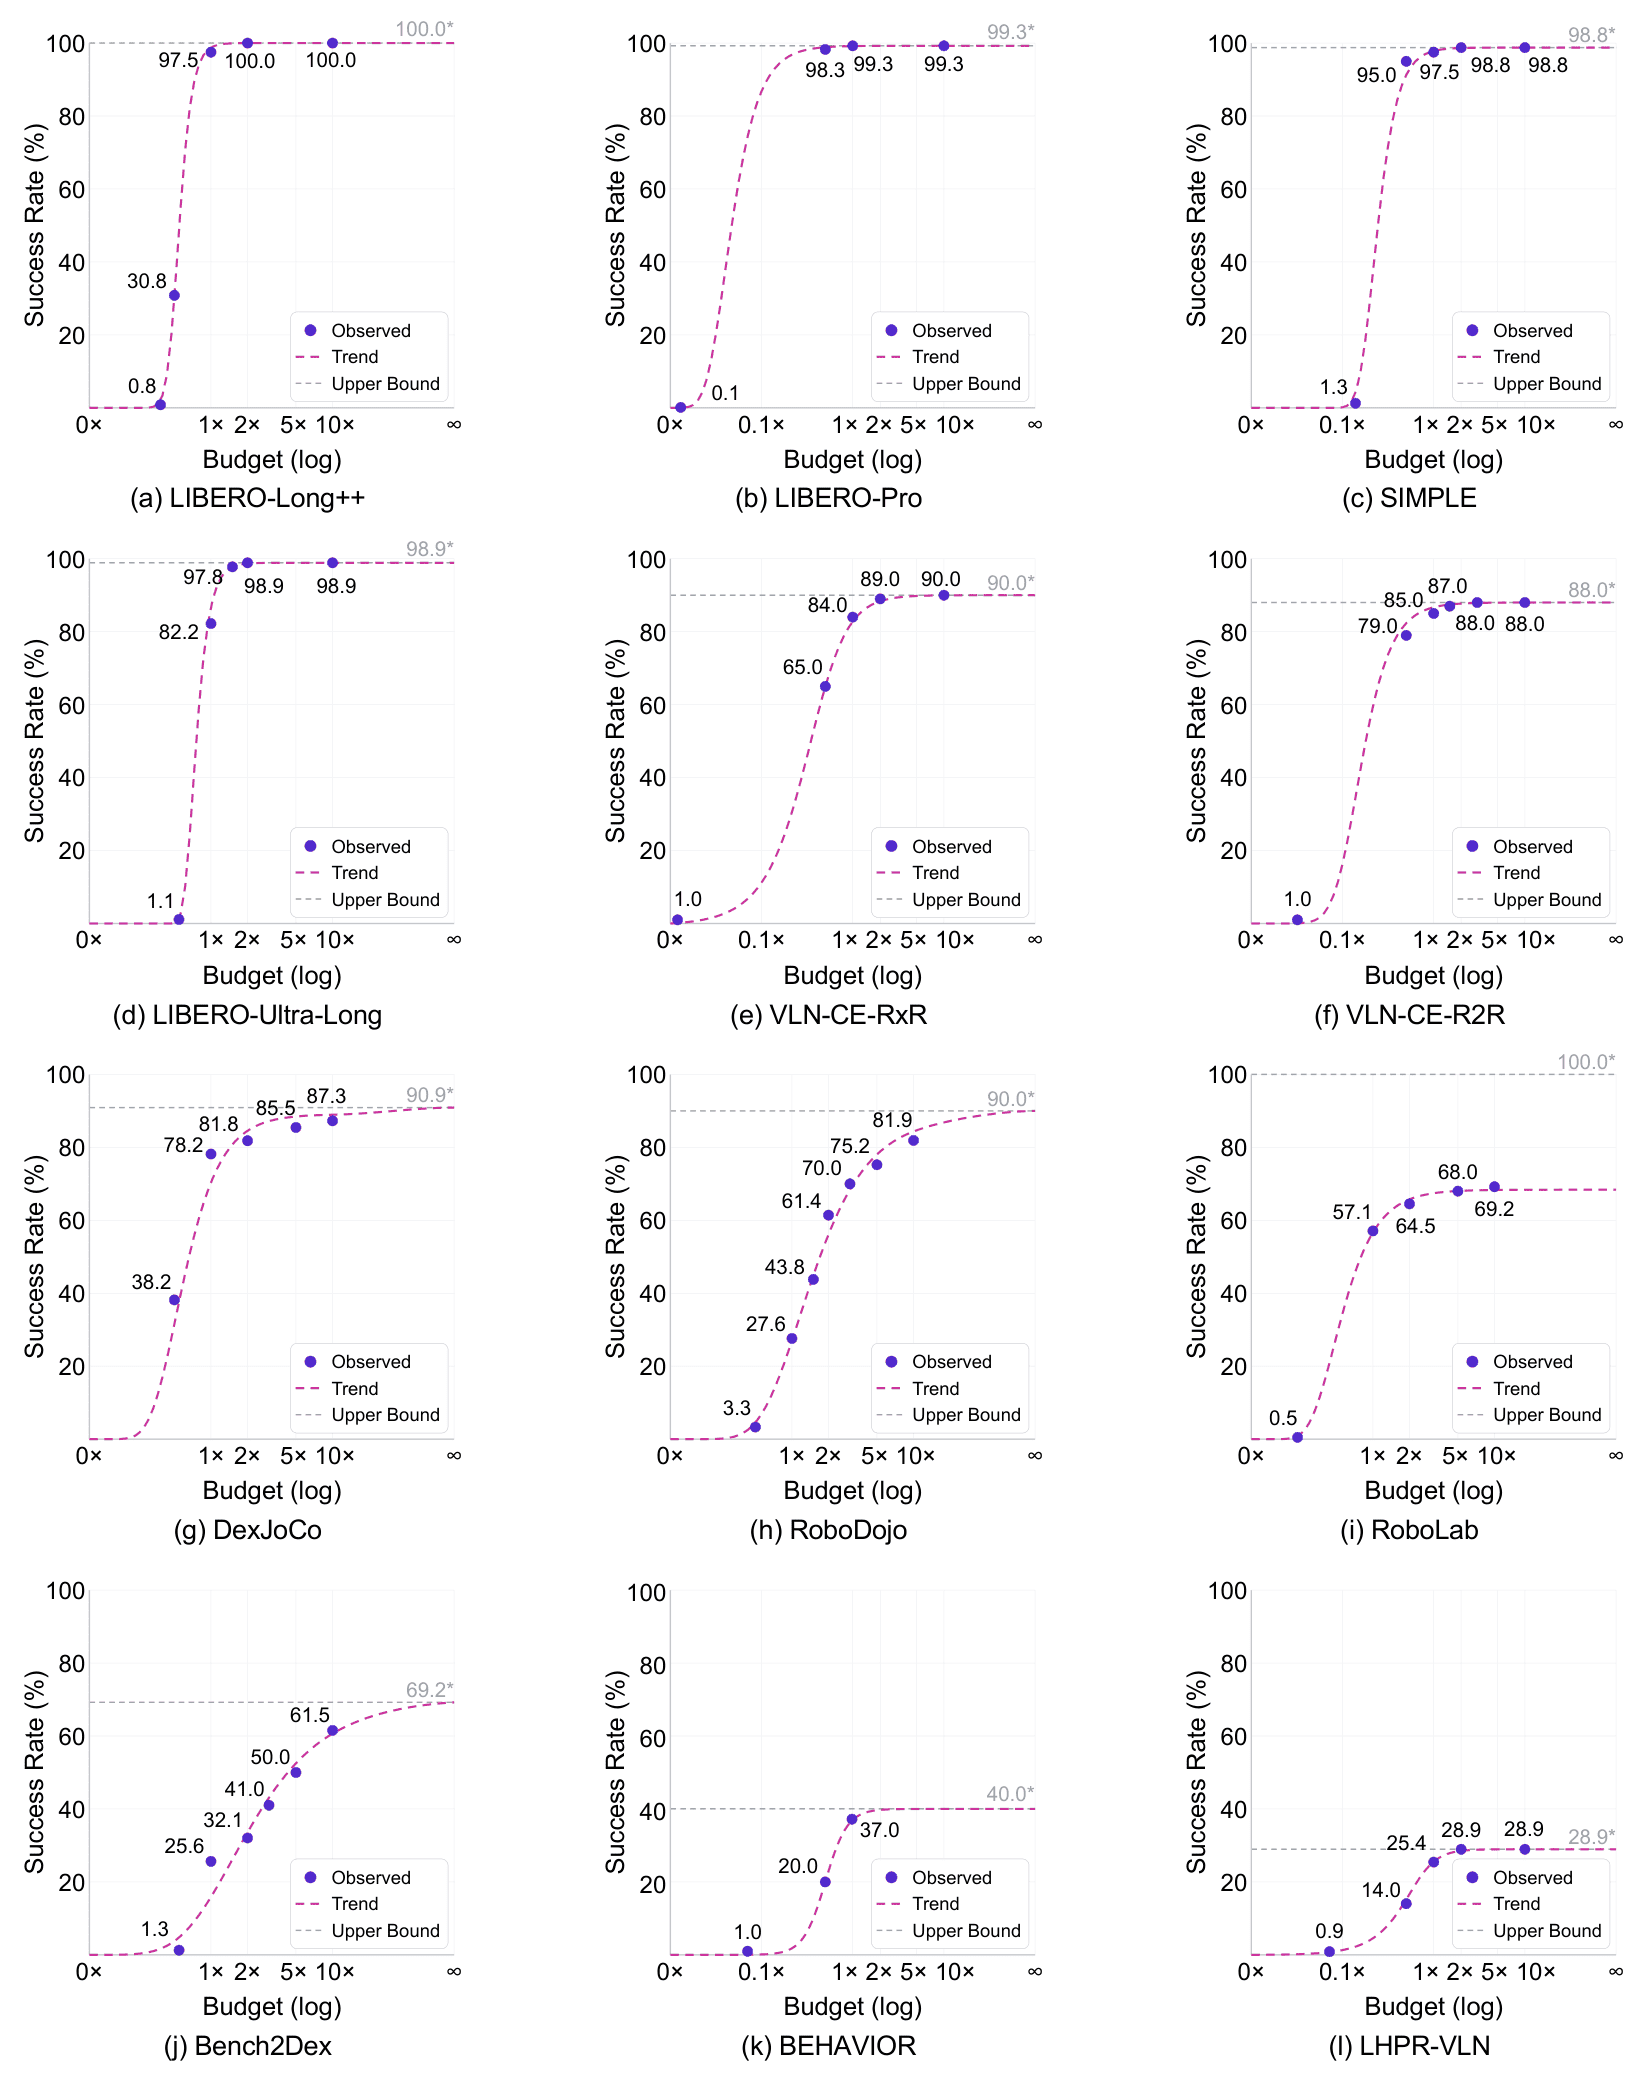
Бенчмарки делятся на пять групп по типу робота. Больше всего задач у однорукого манипулятора Franka. В семействе LIBERO он выполняет кухонные задачи по текстовой инструкции, например кладёт томатный соус в корзину или включает плиту и ставит на неё кофеварку. LIBERO-PRO слегка меняет сцены и формулировки, чтобы проверить, не заучила ли модель решения. LIBERO-Long++ добавляет на стол лишние предметы и меняет порядок шагов, а в LIBERO-Ultra-Long одна задача, например навести порядок на кухне, складывается из цепочки в 9-16 действий. На ней GPT-6-Astra при стандартном лимите шагов успешно завершает 82.2% задач против 44.0% у лучшей прошлой модели LiLo-VLA, а с запасом шагов все тесты LIBERO выполнены на 98.9-100%.
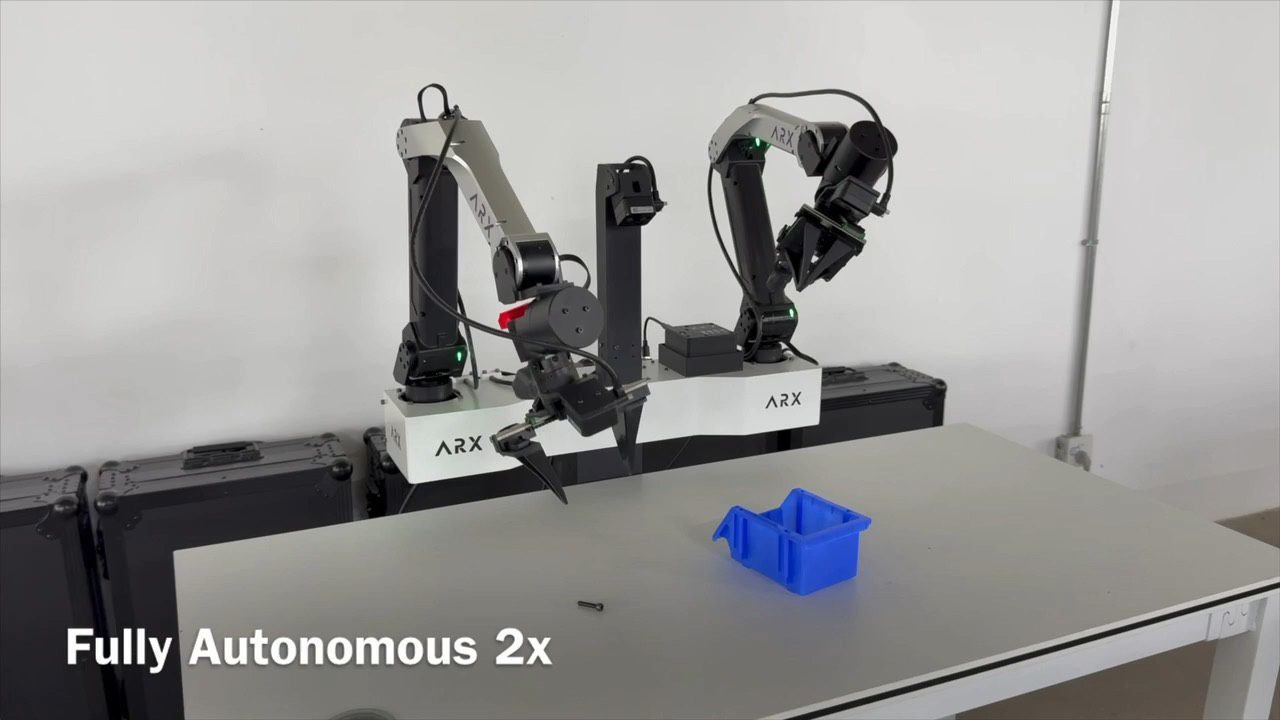
RoboDojo сложнее: двурукий робот ARX X5 выполняет 42 задачи из пяти групп. Есть задачи на точность (закрутить винты, вставить ключ), длинные цепочки действий (разложить яйца из корзины в подставку, сыграть в крестики-нолики), задачи на память (поменять блоки местами) и на обобщение (сложить одежду, повесить кружки на крючки). В группе Open своих демонстраций нет, а задачи вроде «убери инструменты в ящик» или «налей жидкость по инструкции» модель выполняет, применяя общий пакет знаний из других групп задач. При стандартном лимите GPT-6-Astra решает 27.6% задач, чуть ниже прошлого рекорда 31.4%, но с запасом шагов успех растёт втрое, до 81.9%. Хуже всего идёт группа Open: 15% при стандартном лимите.
RoboLab проверяет, как модель понимает инструкции: в 120 задачах нужно выбрать предмет по описанию, расставить предметы в заданном взаимном расположении, собрать стопку или перевернуть объект. Обучающей выборки здесь нет, так что модель работает zero-shot и набирает 57.1% против 42.9% у лучшей на этом бенчмарке FLUX 3 Action.
В DexJoCo и Bench2Dex вместо простого захвата применяются многопалые кисти. В DexJoCo выполнялись 11 задач в симуляторе MuJoCo: забить гвоздь молотком, сложить очки, полить растение, разблокировать iPad, переложить кольца Ханойской башни. Здесь разрыв с прошлыми моделями самый заметный: 78.2% успешных завершений эпизодов против 40.3% у π0.5. Bench2Dex проверяет 26 двуручных задач на 12 сочетаниях манипулятора и кисти: собрать пазл, сыграть мелодию на пианино, налить воду из крана в стакан. При стандартном лимите GPT-6-Astra набирает 25.6%, столько же, сколько π0.5, а с запасом шагов 61.5%.
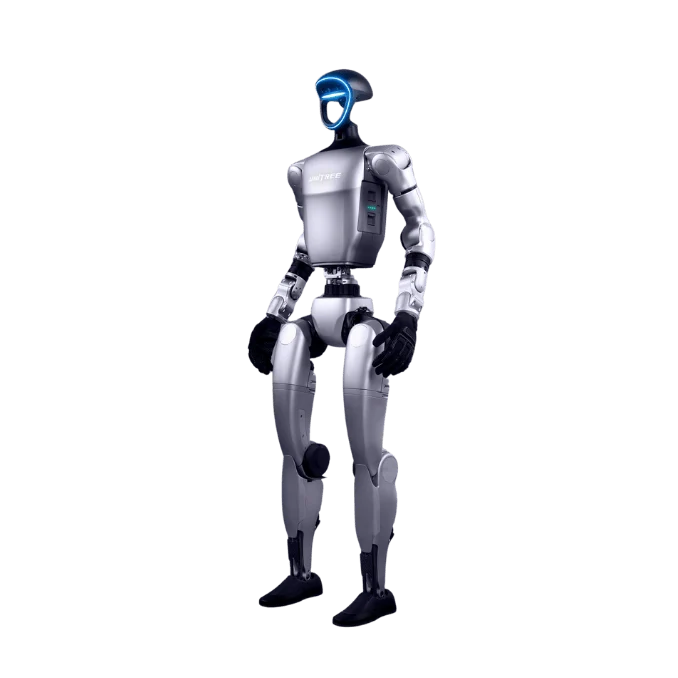
SIMPLE проверяет гуманоида Unitree G1 с двумя кистями: нужно сместиться вбок и взять предмет, наклониться за ним, передать из руки в руку, перенести со стола на стол. На сложных уровнях меняли освещение и сдвигали предметы. Здесь удобно мерить вклад ICL: на четырёх общих задачах успех без пакета знаний 70.8%, с ним 90.8%, а с запасом шагов успех доходит до 98.8%.
BEHAVIOR — самый бытовой тест: колёсный двурукий робот выполняет 100 домашних дел, например заносит в дом покупки или собирает набор инструментов в ящик, а в сценах есть жидкости и мягкие предметы. GPT-6-Astra справилась с 37% задач против 14.8% у лучшего прошлого решения. Лимит шагов здесь не увеличивали, официальный и так большой.
Последняя группа — про навигацию. В VLN-CE робот получает словесное описание маршрута по незнакомому дому, идёт шагами по 25 см с поворотами и должен остановиться не дальше 3 м от цели. С запасом шагов GPT-6-Astra проходит 88-90% маршрутов. Следующий тест LHPR-VLN сложнее: по одной инструкции нужно посетить 2-4 цели строго по порядку, а остановка у неверной цели сбивает всю последовательность. Здесь результат самый низкий, 21.1% и 28.9% с запасом шагов, потому что модель теряла план маршрута.
Из этих результатов видно, когда работает каждое из двух правил. Пакет знаний сильнее всего помогает, когда тестовые задачи почти совпадают с обучающими: в LIBERO, SIMPLE и VLN-CE модель находит в пакете готовое движение или маршрут и подгоняет его под текущую сцену. Если похожих примеров нет, как в группе Open или на RoboLab, результат заметно ниже. Запас шагов полезнее всего в точных и двуручных задачах RoboDojo и Bench2Dex: модель часто промахивается с первой попытки, замечает это и пробует снова, а стандартный лимит обрывает эпизод раньше, чем она успевает исправиться.
Сравнивать с прошлыми моделями нужно осторожно. Затраты не уравнивали, и GPT-6-Astra может тратить на один эпизод миллионы токенов и десятки минут. Кроме того, на некоторых бенчмарках GPT-6-Astra запускали всего несколько раз. На Bench2Dex каждую задачу она выполняла по три раза, а π0.5 по пятьдесят. Когда попыток три, одна случайная удача или неудача сдвигает результат по задаче сразу на 33 пункта, поэтому такие цифры стоит считать грубой оценкой.
За результат платят токенами и временем: на LIBERO-Long++ эпизод съедает около миллиона токенов и почти час, на LIBERO-Ultra-Long около 9 млн токенов и почти два часа, на RoboDojo с расширенным бюджетом больше трёх часов. 98% токенов приходится на закэшированный вход, так что 1 млн токенов обходится примерно в $1. Пока модель думает, симулятор стоит на паузе.
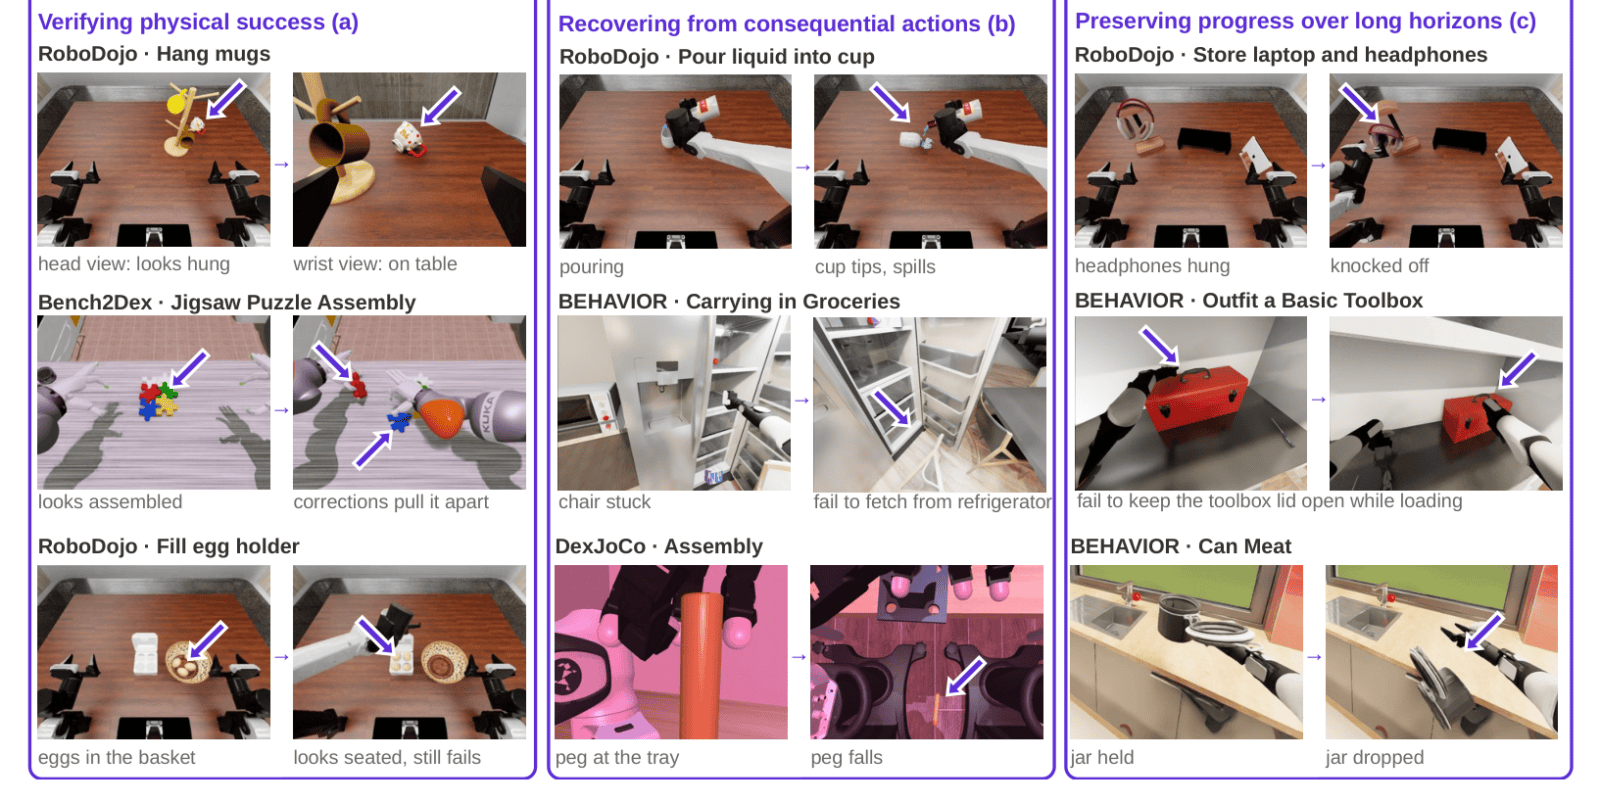
Оставшиеся ошибки делятся на три типа.
- Astra не проверяла физический результат и верила тому, как сцена выглядела с одного ракурса. В одной из задач RoboDojo робот должен повесить кружку на крючок. На кадре с головной камеры ручка кружки перекрыла с крючок, и модель решила, что кружка уже висит. С этого ракурса не видно, прошёл ли крючок сквозь ручку, а посмотреть с другой стороны, например через камеру на запястье, модель не догадалась. На самом деле кружка лежала на столе.
- Если после промаха обстановка менялась и прежний план уже не работал, модель не находла нового решения. В задаче на сборку из DexJoCo деталь выскользнула из пальцев робота и упала на пол. Модель решила, что до неё не дотянуться, убрала руки и остановилась, хотя запас шагов ещё оставался.
- На длинных задачах модель иногда сама ломала то, что уже сделала. Повесив наушники на подставку, она вернулась поправить амбушюру и сбросила их.
Что важно в обвязке
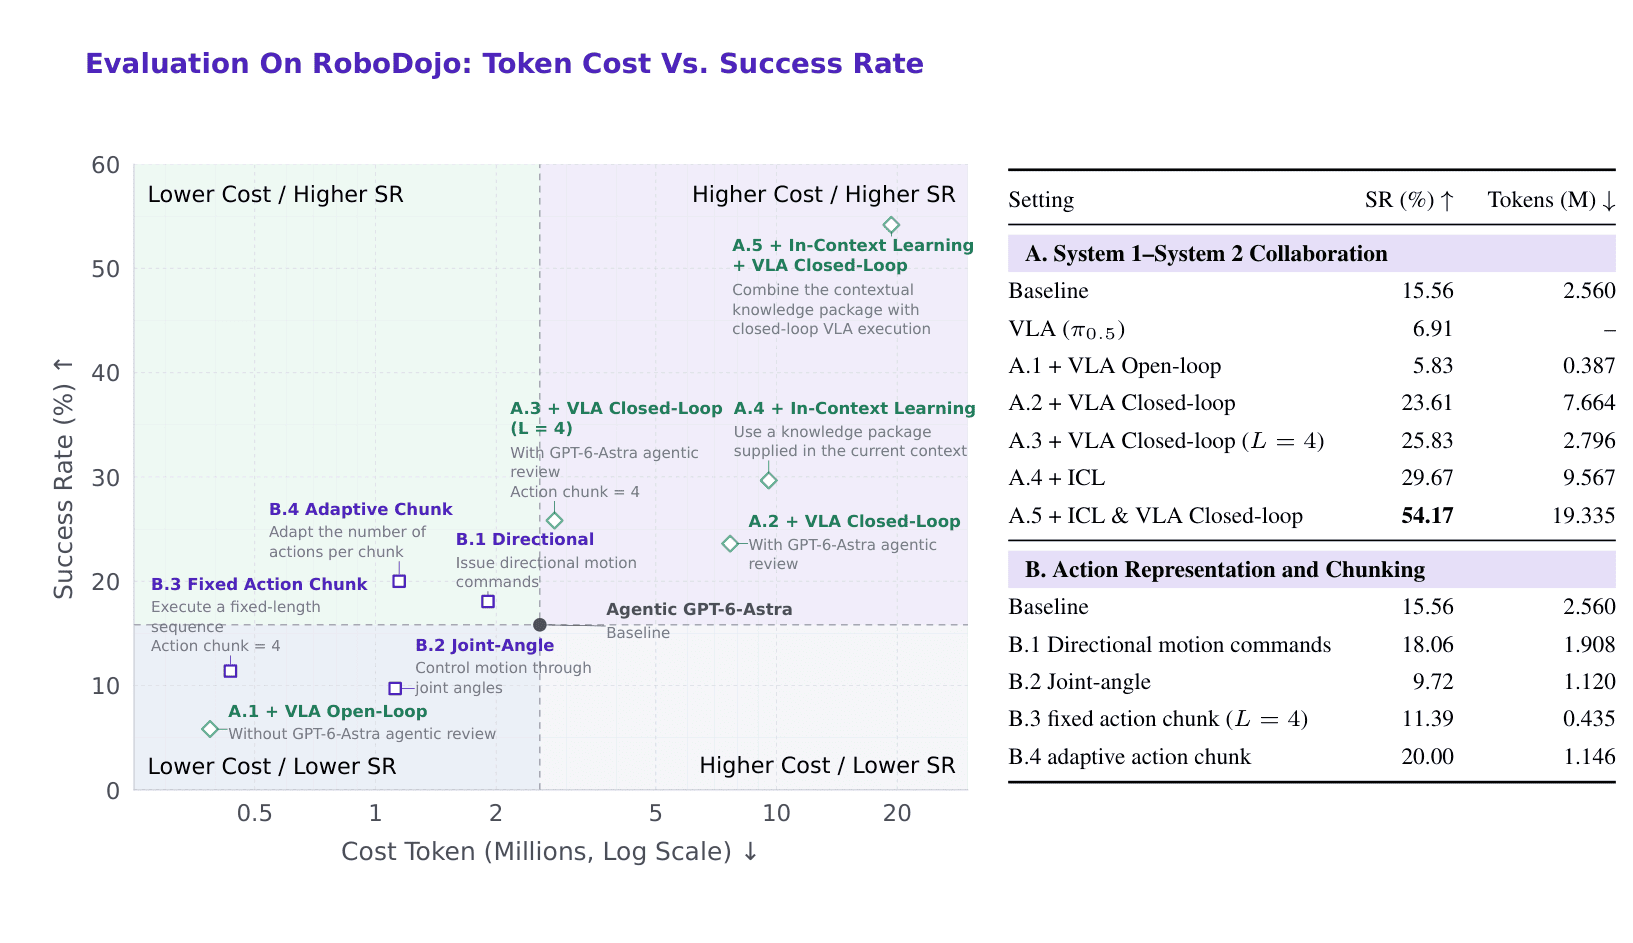
Обвязку (agent harness) авторы проверили на 42 задачах RoboDojo. Сначала они разделили работу между двумя моделями. Небольшая VLA-модель π0.5, дообученная на RoboDojo, быстро предлагает следующие движения робота. GPT-6-Astra думает медленно, зато лучше понимает задачу, поэтому она смотрит на кадры и до исполнения принимает, исправляет или отклоняет каждое предложенное движение. Авторы называют такую связку System 1 и System 2, по аналогии с книгой Даниэля Канемана «Думай медленно… решай быстро», где System 1 принимает быстрые интуитивные решения, а System 2 медленно рассуждает.
Сама π0.5 решает 6.91% задач. GPT-6-Astra, которая управляет роботом в одиночку, без VLA и пакета знаний, решает 15.56% и тратит на эпизод 2.56 млн токенов. Если она проверяет каждое движение π0.5, успех растёт до 23.61%, но токенов уходит втрое больше, 7.66 млн. Если проверять сразу по четыре движения, успех 25.83% при 2.80 млн токенов, почти как в одиночку. Лучший результат, 54.17%, дала связка вместе с пакетом знаний, но она съедает 19.3 млн токенов на эпизод.
Важен и формат действий. В одиночном режиме GPT-6-Astra задаёт координаты схвата, и если заменить их на углы суставов, успех падает на 5.84 пункта. А если модель сама выбирает, сколько движений выдать за раз, успех растёт до 20.00%, а токенов уходит вдвое меньше. Модели удобнее отдавать смысловые команды, а точное движение лучше оставить контроллерам робота.
Воплощённый интеллект на реальных роботах
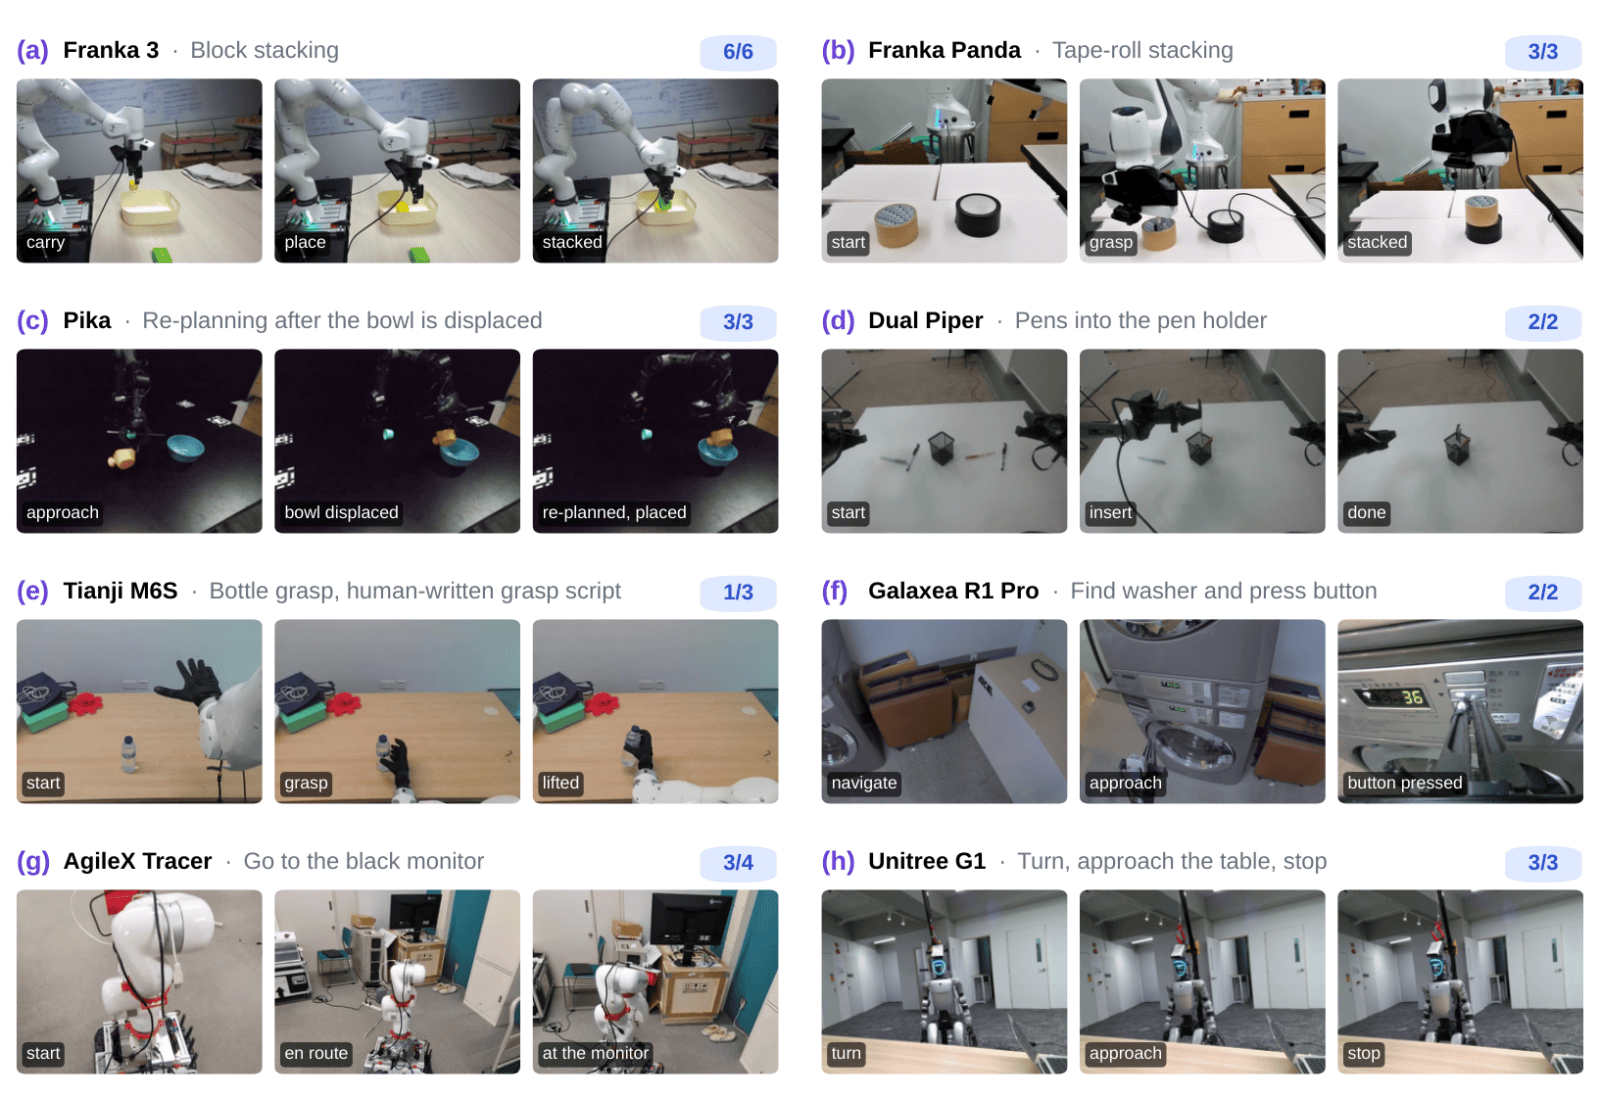
На реальных роботах проверили, как переносятся результаты из симуляции в физический мир. Демонстраций здесь нет, поэтому вместо пакета знаний модель получает контекст, который пишет человек, с пределами суставов, расположением камер и ограничениями безопасности. Лимит считают не в шагах, а во времени, обычно это 60 минут на попытку.
Одна и та же модель без дообучения управляла всеми восемью роботами, от манипулятора Franka до гуманоида Unitree G1. Но надёжно выполнять у неё получается только самые простые задачи. Взять твёрдый предмет и переставить его модель смогла в 17 попытках из 18. С тканью, точным контактом и длинными маршрутами всё хуже. Складывание ткани на Franka 3 удалось в 2 попытках из 4, поиск предмета в здании на AgileX Tracer в 9 из 23, а вставить вилку в розетку модель не смогла ни разу за 11 попыток на трёх роботах.
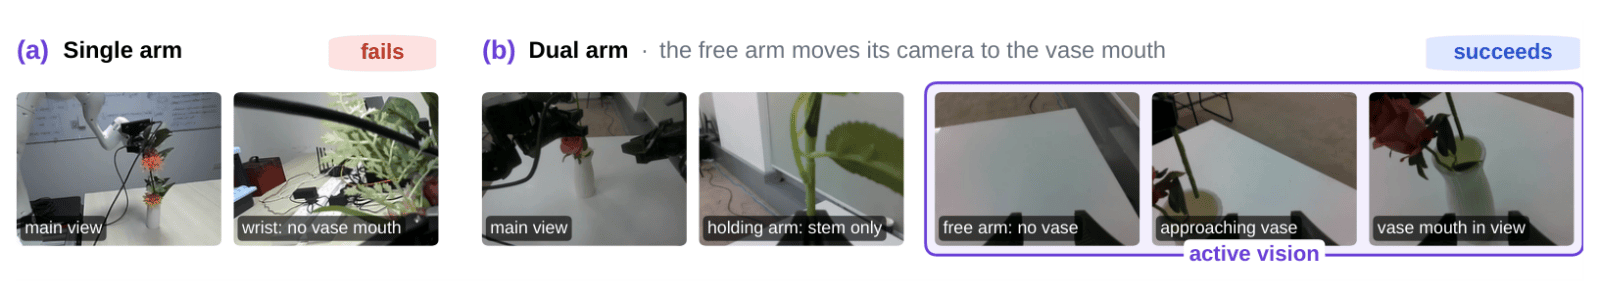
При этом у модели нашлась сильная сторона, которой нет у VLA-моделей. Это активное зрение, то есть умение двигать камеру, чтобы увидеть нужное. В одной из задач робот должен вставить цветок в вазу. Захват держит стебель сверху, и стебель перекрывает горлышко вазы под цветком. У однорукого Franka 3 другой камеры рядом нет, поэтому модель вставляет цветок вслепую, и он падает рядом с вазой. У двурукого Piper одна рука держит цветок, а вторую модель сама подводит к вазе так, чтобы камера на её запястье смотрела на горлышко, и по этому кадру вставляет цветок. VLA-моделям такой приём взять неоткуда. Их учат на записях телеуправления, где оператор смотрит на сцену своими глазами и камеры робота не двигаются. GPT-6-Astra додумалась двигать камеры сама.
Почему же это ещё не практический воплощённый интеллект? Оба приёма, на которых держались результаты в симуляции, на реальных роботах почти не работают. Запас шагов в симуляции бесплатен, а на реальном роботе каждая лишняя попытка чего-то стоит. Неудачный контакт вызывает защитную остановку, после которой попытку уже не продолжить. Так закончились две из трёх попыток вставить вилку на роботе PiPER. Долгая работа перегревает приводы, и на Galaxea R1 Pro перегрев корпуса прервал обе попытки собрать цветы. Ещё дороже время. На гуманоиде Unitree G1 модель около 90% времени думает, один запрос к API обычно занимает около 25 секунд, и даже удачные попытки взять игрушку длились больше часа.
Пакет знаний собирают из демонстраций, а для новой задачи на реальном роботе их обычно нет. Их заменяет контекст от человека, и от его качества результат зависит напрямую. Многопалые кисти Wuji на роботе Tianji M6S по коду захвата, который написала сама модель, не подняли игрушку ни разу из трёх попыток, а с готовыми скриптами захвата от человека подняли все три раза. Выходит, что на реальных роботах GPT-6-Astra уже справляется с простыми задачами, но медленно, дорого и с подсказками человека.
Каким должен быть следующий бенчмарк
Нынешние бенчмарки, по мнению авторов, сделаны под модели, обученные имитацией, поэтому они предлагают три принципа:
- Задачи из потребностей людей. Просьба звучит по-человечески («Приготовь мне завтрак»), а оценивают пользу результата и негласные обязанности вроде закрытого холодильника;
- Без демонстраций. Опыт агент набирает сам;
- Мир не ждёт. Пока модель думает, время в симуляции идёт.
Прототип собрали в NVIDIA Isaac Sim: квартиру с физикой жидкостей, тканями и нагревом, где GPT-6-Astra управляет роботом AgiBot G2. Модель оставила холодильник открытым с 300-й по 765-ю секунду, пока носила фрукты, а незнакомый кран открывала давлением вниз вместо поворота, и раковина переполнилась. Снять яйцо с огня она решила верно, но выключила конфорку примерно через 90 секунд после того, как яйцо схватилось, и оно подгорело.
Отсюда вывод авторов: воплощённая компетентность у GPT-6-Astra уже есть, а для воплощённого интеллекта ей нужно работать надёжно, быстро и недорого на реальных роботах.