Claude Fable 5.2 и Mythos 5.2: на 20% дешевле версий 5.1 и сильнее Opus 5.5 почти на всех тестах Anthropic

10 ноября 2026
Claude Fable 5.2 and Mythos 5.2

Claude Fable 5.2 и Mythos 5.2: на 20% дешевле версий 5.1 и сильнее Opus 5.5 почти на всех тестах Anthropic

Тысяча агентов Claude Fable 5.2 за 30 часов формализовала доказательство Великой теоремы Ферма — перевела его на язык, в котором компьютер проверяет каждый шаг. Так Anthropic показывает возможности новой модели.…
Нейросети для стримов в бенчмарке StreamEval: лучшая модель справилась только с 15% правок по референсу

26 октября 2026
редактирование видео в реальном времени - benchmark streameval

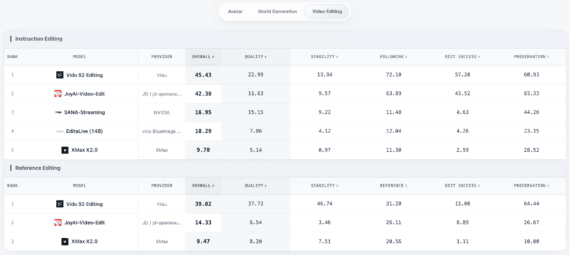
Нейросети для стримов в бенчмарке StreamEval: лучшая модель справилась только с 15% правок по референсу

Исследователи из Tsinghua University, NVIDIA, CMU, UC Berkeley, Princeton, NUS и Reactor опубликовали StreamEval — бенчмарк, который проверяет, насколько хорошо нейросети для стримов генерируют видео в реальном времени: умеет ли…

ClawBench: лучший ИИ-агент смог успешно завершить только 33% реальных повседневных задач

13 апреля 2026

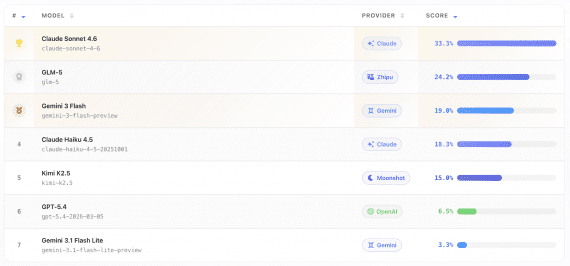
ClawBench: лучший ИИ-агент смог успешно завершить только 33% реальных повседневных задач

ClawBench — бенчмарк, который проверяет, могут ли ИИ-агенты выполнять настоящие повседневные задачи в интернете: забронировать рейс, откликнуться на вакансию, оформить заказ. Результаты показали, что даже сильнейшая модель — Claude Sonnet…

VBVR: открытый датасет на 2 миллиона видео для обучения видеомоделей рассуждению

26 февраля 2026
VBVR dataset

VBVR: открытый датасет на 2 миллиона видео для обучения видеомоделей рассуждению

Команда из более чем 50 исследователей со всего мира — из CMU, Oxford и других университетов — опубликовала Very Big Video Reasoning (VBVR) — огромный набор данных для обучения видеомоделей…

Claude Sonnet 4.5 побеждает на полноценном backend-бенчмарке, лучше всех справившись и с кодом, и с настройкой окружения

22 января 2026
abc-bench-pipeline-workflow

Claude Sonnet 4.5 побеждает на полноценном backend-бенчмарке, лучше всех справившись и с кодом, и с настройкой окружения

Команда исследователей из Fudan University и Shanghai Qiji Zhifeng Co. представила ABC-Bench — первый бенчмарк, который проверяет способность ИИ-агентов решать полноценные задачи backend-разработки: от изучения кода в репозитории до настройки…

AI-модели на 13% хуже людей распознают сгенерированные ASMR-видео

18 декабря 2025
AI-generated video

AI-модели на 13% хуже людей распознают сгенерированные ASMR-видео

Исследователи из CUHK, NUS, University of Oxford и Video Rebirth представили Video Reality Test — первый бенчмарк, который проверяет, могут ли современные AI-модели создавать видео, неотличимые от настоящих. В отличие…

Remote Labor Index: ведущие ИИ-агенты справились с 2.5% реальных задач с биржи фрилансеров

4 ноября 2025
Remote Labor AI benchmark open source

Remote Labor Index: ведущие ИИ-агенты справились с 2.5% реальных задач с биржи фрилансеров

Команда исследователей из Center for AI Safety и Scale AI опубликовала Remote Labor Index (RLI) — первый бенчмарк, который проверяет, могут ли ИИ-агенты делать настоящую работу фрилансеров. Они собрали 240…