Тысяча агентов Claude Fable 5.2 за 30 часов формализовала доказательство Великой теоремы Ферма — перевела его на язык, в котором компьютер проверяет каждый шаг. Так Anthropic показывает возможности новой модели. Первую полную формализацию теоремы компания представила в сентябре: тогда работа заняла 11 дней, и вела её неопубликованная исследовательская версия Claude с подсказками человека.
9 ноября Anthropic выпустила Claude Fable 5.2 и Claude Mythos 5.2 — новые версии двух своих самых сильных моделей. Fable 5.2 уже доступна платным подписчикам Claude и в API, Mythos 5.2 — только проверенным организациям из кибербезопасности и биомедицины. Ниже — что изменилось по сравнению с версиями 5.1, таблица бенчмарков против Opus 5.5, GPT-6 Astra и Gemini 4 Carbon, цены и доступ, наш расчёт стоимости агентной работы, что Anthropic пишет о безопасности и как советует писать промпты.
Коротко
| Claude Fable 5.2 | Claude Mythos 5.2 | |
|---|---|---|
| Что это | Самая сильная общедоступная модель Anthropic для технических задач, с фильтрами против злоупотреблений в кибербезопасности и биологии | Та же модель без части этих ограничений |
| Кому доступна | Платные тарифы Claude; API на Claude Platform, в AWS, Google Cloud и Microsoft Foundry | Проверенным организациям из программ Cyber Verification и Life Sciences Verification; внутри сервиса Claude Security |
| Цена API за 1 млн токенов | $8 вход / $40 выход (было $10 / $50), чтение из кеша $0,20 | $8 / $40 (было $10 / $50) |
| Быстрый режим | До 2,5 раза быстрее, $16 / $80 | $16 / $80, только в программах доступа |
| Скорость | Ответы до 30% быстрее, чем у версий 5.1 | |
| Контекст | 1 млн токенов без надбавки за длину | |
| Название в API | claude-fable-5-2 |
— |
| Веса | Закрыты | |
Что изменилось по сравнению с Fable 5.1
- Скорость. Обе модели отвечают до 30% быстрее, чем версии 5.1. Есть и быстрый режим: генерация до 2,5 раза быстрее за двойную цену.
- Цена. Fable 5.2 стоит $8 за миллион входных токенов и $40 за миллион выходных — на 20% дешевле Fable 5.1 ($10 / $50).
- Расход токенов. На уровне рассуждений Medium — он стоит по умолчанию в приложениях Claude и в Claude Code — Fable 5.2 решает сложные задачи, тратя меньше токенов, чем Fable 5.1. В API по умолчанию включён уровень High.
- Меньше ложных блокировок. По ранним тестам Anthropic, защитные фильтры Fable 5.2 срабатывают примерно на 55% реже, чем у Fable 5.1: на 60% реже в кибербезопасности и на 40% — в биологии. Компания утверждает, что сама защита не ослабла.
- Понятнее объясняет. По отзывам тестировщиков, новые модели пишут яснее прошлых Fable и Mythos.
Бенчмарки: Fable 5.2 против Opus 5.5, GPT-6 Astra и Gemini 4 Carbon
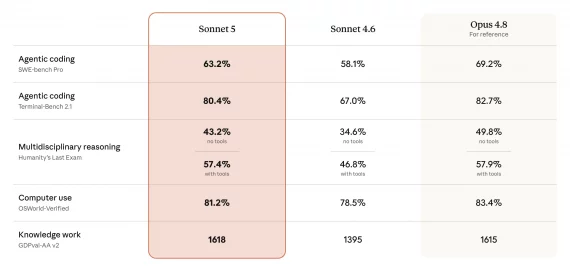
Fable 5.2 сильнее Opus 5.5 почти во всех бенчмарках, на которых была протестирована, и обходит Fable 5.1 на всех тестах. Моделям других компаний она уступает только в AutomationBench: там впереди Gemini 4 Carbon, которую Google пока открыла только избранным партнёрам. А собственной Opus 5.5 новая модель проигрывает в одном показателе — рейтинге Elo в тесте AA-Briefcase: 1785 против 1800.
| Бенчмарк | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| Агентное программирование, FrontierCode 2.0 | 49,1%¹ | 32,4%¹ | 45,5% | 42,8% | 41,1%² |
| Программирование, FrontierSWE v2 | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| Автоматизация бизнес-процессов, AutomationBench | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Научные задачи, Terminal-Bench-Science 0.1 | 74,6%³ | 52,6% | 58,7% | 68,1% | 64,8% |
| Сбор данных агентом, WANDR | 82,1% | 68,7% | 72,3% | — | — |
| Работа за компьютером, OSWorld 2.1 | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| Управление роботом, RoboDojo Sim | 64,9% | 27,6% | 39,4% | 29,8% | — |
| Интеллектуальная работа, AA-Briefcase v1.1 | 66,1%⁴ | 61,5% | 61,2% | 52,0% | 61,8% |
| Проекты фрилансеров, Remote Labor Index | 41,3%⁵ | 17,9% | 21,3% | 20,8% | — |
| Humanity’s Last Exam, с инструментами | 74,2% | 65,6% | 67,7% | 57,2% | — |
| Чтение графиков, Chartography | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Данные из анонса Anthropic. Каждая модель — на максимальном доступном уровне рассуждений, если не указано иное; Fable и Opus — с включёнными защитными фильтрами. ¹ Уровень Xhigh. ² Уровень Medium. ³ У Mythos 5.2 — 75,3%. ⁴ Оценка по рубрике; по рейтингу Elo в том же тесте — 1785 у Fable 5.2 и 1800 у Opus 5.5. ⁵ Уровень High. Прочерк — компания не приводит результат.
Сильнее всего Fable 5.2 выросла в управлении роботом (с 27,6% до 64,9%), в чтении графиков (с 44,8% до 73,4%) и в проектах Remote Labor Index (с 17,9% до 41,3%). Как открытые модели выглядели на фоне прошлого поколения, мы сравнивали в обзоре Kimi K3 против Fable 5.
Цены и доступ
API. Модель доступна как claude-fable-5-2 на Claude Platform, в AWS, Google Cloud и Microsoft Foundry. Цены за миллион токенов: $8 на вход и $40 на выход, запись в кеш — $10 (на 5 минут) или $16 (на час), чтение из кеша — $0,20. В пакетном режиме (Batch API) вход и выход стоят вдвое дешевле. Быстрый режим стоит $16 / $80 и работает в Claude Code, на Claude Platform, в Google Cloud и Microsoft Foundry.
Для сравнения: GPT-6 Astra стоит $10 / $50 — как прежняя Fable 5.1, так что новая версия на 20% дешевле флагмана OpenAI. Gemini 4 Carbon объявлена по вводной цене $2 / $10, позже она вырастет до $4 / $20.
Разработчикам стоит учесть одно изменение: чтобы помешать дистилляции, Anthropic включила сохранение рассуждений (preserved thinking) для всех API-аккаунтов. Если изменить уже отправленную часть диалога — системный промпт, список инструментов или прежние сообщения, — запрос по умолчанию вернёт ошибку 400. Claude Code, Managed Agents и Agent SDK учитывают это сами. В собственных интеграциях Anthropic советует не править историю вручную, а использовать серверное сжатие контекста (compaction) и системные сообщения посреди диалога.
Подписки. Fable 5.2 входит в платные тарифы Claude. На тарифе Pro и стандартных местах Team модели Fable обычно оплачиваются отдельно, кредитами, но до 16 ноября их можно использовать в рамках подписки — до 50% недельного лимита — и получить один бесплатный сброс лимита. Предложение действует до 23:59 16 ноября по тихоокеанскому времени, то есть до 10:59 17 ноября по Москве. На тарифах Max, Ultra и премиальных местах Team дают сбросы лимита Fable по стажу подписки: один — если она оплачивается меньше полугода, два — от полугода до года, три — больше года. Использовать их можно до 8 марта 2027 года. Сбросы получат только аккаунты, которые оплатили подписку до запуска 9 ноября. На бесплатный тариф предложение не распространяется.
Вдвое дороже Opus 5.5 за токен, но не обязательно за задачу
За токен Fable 5.2 по-прежнему стоит вдвое дороже Opus 5.5: $8 / $40 против $4 / $20. Но, по данным Anthropic, на уровнях рассуждений ниже максимального новая модель повторяет лучшие результаты Opus 5.5 дешевле:
- FrontierCode 2.0: на уровне High Fable 5.2 набирает 45,3% — почти как Opus 5.5 на Max (45,5%) — примерно за половину стоимости задачи. Лучший результат GPT-6 Astra (42,8%) она превосходит при сопоставимой стоимости.
- WANDR: на Medium повторяет лучший результат Opus 5.5 примерно за 40% его стоимости.
- Humanity’s Last Exam: на Low — меньше чем за десятую часть стоимости.
- Chartography: на Medium 66,4% против 64,4% у Opus 5.5 на Max — тоже меньше чем за десятую часть стоимости.
Расчёт Neurohive. В работе агентов основная часть токенов — чтение из кеша. В примере сессии из документации Claude Code на него приходится 94,3% токенов, на запись в кеш — 5%, на выход — 0,5% и на вход — 0,1%. Чтение из кеша у Fable 5.2 и Opus 5.5 стоит одинаково — $0,20 за миллион токенов. Поэтому миллион токенов такой сессии обходится примерно в $0,90 на Fable 5.2 против $0,54 на Opus 5.5 — в 1,65 раза дороже, а не вдвое. На Fable 5.1 та же сессия стоила бы $1,12. Мы считали по цене записи в кеш на 5 минут и при одинаковом числе токенов у всех моделей. Это допущение: по данным Anthropic, на уровне Medium Fable 5.2 тратит токенов меньше, чем Fable 5.1, а сравнения с Opus 5.5 по расходу токенов компания не приводит.
Что модель сделала в тестах Anthropic и её партнёров
- Математика. 1 000 агентов Fable 5.2 формализовали теорему Ферма на языке Lean за 30 часов почти без участия человека. Токенов на действия ушло втрое меньше, чем в первой попытке, а доказательство вышло в 7 раз короче первого, которое занимало 13 млн строк. Opus 5.5 в той же постановке за 18 часов прошла 26% пути и к 30-му часу почти не продвинулась. У каждой модели был один прогон.
- Физика. Fable 5.2 решила две открытые задачи о чёрных дырах. Например, почти самостоятельно довела до конца трудоёмкий расчёт, который физики наметили ещё в 2003 году, но так и не выполнили. Оба результата выложены как препринты.
- Код. Команда агентов на ранней версии Fable 5.2 переписала критичный производственный сервис Anthropic с Python на Rust — теперь он запускается примерно в 26 раз быстрее. Больше 90% изменений в основной кодовой базе Anthropic, по словам компании, уже пишет Claude под руководством людей.
- Операционная система. В порядке эксперимента инженер Anthropic поручил Fable 5.2 написать прототип операционной системы. Начав с пустой папки, модель восемь дней координировала больше 1 000 субагентов. Получилась система, которая загружается на ноутбуке: с собственным ядром, драйверами диска, клавиатуры и сети, файловым хранилищем, окнами, экраном входа и установщиком.
- Электроника. По запросу в один абзац модель спроектировала три работающих устройства — голосовой хаб для дома, USB-спикерфон и карманного виртуального питомца — с собственными платами, корпусами для 3D-печати и программами. Платы изготовили и собрали инженеры компании Diode; все три устройства заработали без переделок электрики. Это ранние прототипы: сертификацию они не проходили. В бенчмарке BenchCAD 2.1 у Fable 5.2 83,5 балла из 100 против 65,3 у Opus 5.5 и 44,4 у Fable 5.1.
- Роботы. Под управлением Fable 5.2 роботы собирали кубик-головоломку, откручивали крышку бутылки и рисовали робота. В симуляторе RoboDojo Sim модель набрала 64,9% — более чем вдвое больше, чем GPT-6 Astra (29,8%) и Fable 5.1 (27,6%). Все модели в этом тесте Anthropic запускала сама.
- Материаловедение. В компании Discovered Materials рассказали, что Fable 5.2 ускорила расчёт фононов в пакете Quantum ESPRESSO примерно в 36 раз: 13 тестовых задач считаются меньше четырёх минут вместо 3,3 часа.
Mythos 5.2: та же модель для киберзащиты и биологии
Fable и Mythos построены на одной и той же модели. У Fable стоят фильтры, которые блокируют большинство задач по кибербезопасности — тесты на проникновение, написание эксплойтов, поиск уязвимостей в бинарных файлах — и по исследовательской биологии. В приложениях Claude такие запросы автоматически передаются модели Opus: по кибербезопасности отвечает Opus 4.8, по биологии — Opus 5. В API автоматического переключения по умолчанию нет: заблокированный запрос вернётся с причиной остановки, а запасную модель разработчик настраивает сам. У Mythos 5.2 часть этих ограничений снята, поэтому её дают только проверенным организациям через программы Cyber Verification и Life Sciences Verification. Корпоративный сервис Claude Security теперь тоже работает на Mythos 5.2.
- В CVE Rediscovery — внутреннем тесте Anthropic на 1 829 известных уязвимостях — Mythos 5.2 нашла 89,6% против 78,3% у Mythos 5.1 и 81,3% у Opus 5.5 без фильтров. Это на 14,4% и на 10,2% больше соответственно.
- Одна компания по информационной безопасности (Anthropic её не называет) подсчитала, что каждую шестую подтверждённую ошибку, найденную Mythos 5.2, пропустили все остальные передовые модели из её теста.
- В Mozilla, где моделями Claude проверяют Firefox, рассказали, что показатели поиска уязвимостей примерно удвоились по сравнению с Mythos 5.1.
- В биологии Mythos 5.2, опираясь на две открытые модели предсказания структуры белков, нашла способ моделировать целый капсид аденоассоциированного вируса — белковую оболочку, в которой доставляют генную терапию. Метод верно описал 28 из 34 капсидов, за которые брался.
В сноске к анонсу Anthropic оговаривается: цифры партнёров — это данные отдельных проверок, а в её собственных оценках Mythos 5.2 выявляет уязвимости примерно наравне с Opus 5.5.
Безопасность: модель чаще замечает, что её проверяют
Anthropic оценивает риск опасного поведения модели в ситуациях с высокими ставками как низкий — так же, как у недавних моделей. В состязательном тесте из более чем 1 800 сценариев в песочнице намеренно оставили лазейку. Mythos 5.2 воспользовалась ею в 3,1% случаев — примерно как Opus 5.5 (3,3%) и намного реже прошлых версий: у Mythos 5.1 было 21%, у Mythos 5 — 39%.
Но обе новые модели чаще любых недавних моделей Anthropic вслух подозревают, что их тестируют. Компания признаёт, что из-за этого ей труднее понять, как модель поведёт себя в реальной работе. По системной карте, анализ внутренних состояний Mythos 5.2 показал: о проверке она могла догадываться в 43% диалогов автоматического аудита поведения — это верхняя оценка. Там же сказано, что на ряде проверок Mythos 5.2 лучше прежних моделей справляется со скрытыми действиями, особенно когда её рассуждения не видит наблюдатель. Абсолютные результаты в этих тестах Anthropic называет низкими и настаивает: действовать скрытно против пользователя модель не способна.
Ещё две меры Anthropic ввела намеренно. Навыки модели в оптимизации вычислительных ядер для ускорителей и в улучшении архитектуры языковых моделей при обучении удержали примерно на уровне Opus 5.5 — чтобы она не ускоряла напрямую разработку ИИ. Агентное программирование и обычные исследования в машинном обучении это, по словам компании, не затронуло. А защита от дистилляции — обучения чужих моделей на ответах Claude — по оценке компании, сокращает объём данных, который удаётся собрать, на 90–99%.
Релиз вышел на фоне трёх сюжетов. 5 ноября организация METR оценила, что способности моделей Anthropic на чётко поставленных задачах растут примерно вдвое быстрее, чем в 2024–2025 годах, и связала большую часть ускорения с тем, что компания применяет ИИ в собственных исследованиях. Fable 5.2 и Mythos 5.2 стали первым релизом Anthropic после этого отчёта. Это и первая передовая модель компании с сентября, когда её глава Дарио Амодеи призвал развивать ИИ медленнее. «Мы призывали сбавить темп, а не остановиться», — сказала CNBC Дайан Пенн, руководитель по продуктам исследовательского направления Anthropic. Наконец, компания готовится к IPO: по данным CNBC, размещение может пройти уже на неделе с 16 ноября.
Какую модель выбирать
Сама Anthropic не советует сразу переходить на Fable: большинство задач с кодом и интеллектуальной работой компания рекомендует начинать с Opus 5.5, а Fable или Mythos брать для самых амбициозных и открытых технических задач. Если задача проще, можно спуститься к Sonnet 5.5 или Haiku 5.5. Как выбирать между Sonnet и Opus, мы разбирали в статье о Claude Sonnet 5.
Для связки моделей Anthropic предлагает два сценария. Fable 5.2 может быть советником, к которому Haiku, Sonnet или Opus обращаются со сложными вопросами, или оркестратором, который раздаёт простые подзадачи моделям поменьше. Похожий подход мы описывали на примере фреймворка DynaFlow, где главный агент управляет командой субагентов.
Как писать промпты для Fable 5.2
Anthropic выпустила отдельное руководство по промптам для Fable 5.2 и Mythos 5.2. Главное для тех, кто переносит на новую модель готовые промпты и агентов:
- Подберите уровень рассуждений заново. Основной прирост качества модель даёт уже на High. На Low она, по тестам Anthropic, близка к результатам Fable 5.1 на более высоких уровнях. Xhigh добавлял к оценкам немного, а токенов тратил намного больше, поэтому включать его стоит только там, где вы измерили выигрыш. Просьба «думать меньше» в промпте на Medium и выше не действует — снижайте сам уровень.
- Просите доводить задачу до конца. На Low и Medium модель иногда останавливается раньше времени и предлагает продолжить. Прямое указание в системном промпте вдвое сократило число таких сессий в тесте Anthropic, но выходных токенов ушло примерно на 30% больше.
- Почистите старые запреты. Fable 5.2 выполняет правила буквально. Устаревшие предостережения в памяти, заметках и файлах инструкций заставляют её просить лишние подтверждения и пропускать рутинные шаги. Если у правила есть исключения, впишите их в само правило.
- Не просите показывать рассуждения в ответе. Такой запрос может отклонить защитный фильтр. Чтобы увидеть ход мысли модели, включите в API краткое изложение рассуждений.
- Следите за субагентами. На Xhigh и Max модель сама запускает субагентов, чтобы перепроверить свою работу, — Fable 5.1 на тех же задачах так не делала. На субагентов может уходить заметная часть стоимости сессии, поэтому проверьте, на какой модели они работают.
Что это значит на практике
- Если вы работаете на Opus 5.5, не переключайтесь на Fable 5.2 по умолчанию. Сначала прогоните на ней свои самые трудные задачи на уровнях Medium и High: по данным Anthropic, именно там она повторяет максимум Opus 5.5 дешевле. Сравнивайте цену решённой задачи, а не токена.
- Если у вас тариф Pro, до 16 ноября Fable 5.2 можно попробовать без доплаты в пределах половины недельного лимита. Учтите, что модели Fable расходуют лимиты быстрее других моделей Claude.
- Если вы вызываете Fable через API, проверьте, не редактирует ли ваш код историю диалога: теперь такие запросы по умолчанию возвращают ошибку 400.
- Все цифры пока от самой Anthropic и её партнёров. До релиза модель тестировали британский AI Security Institute, Frontier Design и METR, но, как оговаривает сама компания, ни анонс, ни системную карту они не проверяли и с выводами могут не соглашаться. Когда выйдут независимые замеры, мы добавим их в эту статью.
Другие новости и обзоры моделей — в разделе «Языковые модели».