Сейчас сложные задачи всё чаще решает не одна нейросеть, а команда ИИ-агентов, где один ищет информацию, второй выполняет задачу, а третий проверяет результат. Исследователи из National University of Singapore показали: команда ИИ-агентов сама по себе не повышает точность ответов, а без умелой оркестрации даже снижает. Когда модели Qwen3.5-27B без специального обучения дали возможность использовать субагентов, точность её ответов упала с 72% до 65%. Проблема была в том, что модель не умеет руководить агентами. Чаще всего она отдавала всю задачу одному агенту, а когда собирала команду, агенты почти не обменивались результатами: только в 13% случаев вывод одного агента передавался следующему. Чтобы научить модель руководить, исследователи создали фреймворк DynaFlow. Главный агент сперва оценивает задачу: простую решает сам, а для сложной собирает команду агентов и пишет для неё короткий скрипт, где расписано, кто что делает, кому передаёт результаты и кто их проверяет.
И главный агент, и его помощники работают на базе Qwen3.5-27B, но в разных версиях. Главного агента дообучили руководить командой субагентов при помощи модели-учителя GLM-5.3 Max, а роль субагентов играет замороженная Qwen3.5-27B, которая каждый раз получает от главного агента свою роль и инструкцию. После обучения модель почти на половину вопросов (47%) отвечает сама, без помощников, и в среднем зовёт 2.4 помощника на вопрос вместо 4.2. Это экономит вычисления, ведь каждый помощник это отдельный запуск модели, а точность почти не изменилась: 87.94% против 88.08%, если звать команду всегда. Все 90 олимпиадных задач AIME за 2024-2026 годы решены без ошибок. Обучение заняло примерно полтора дня на двух видеокартах H100. На GitHub авторы выложили код под лицензией MIT, с которым DynaFlow можно запустить на любой модели, доступной по API. Разборы примеров есть на странице проекта.
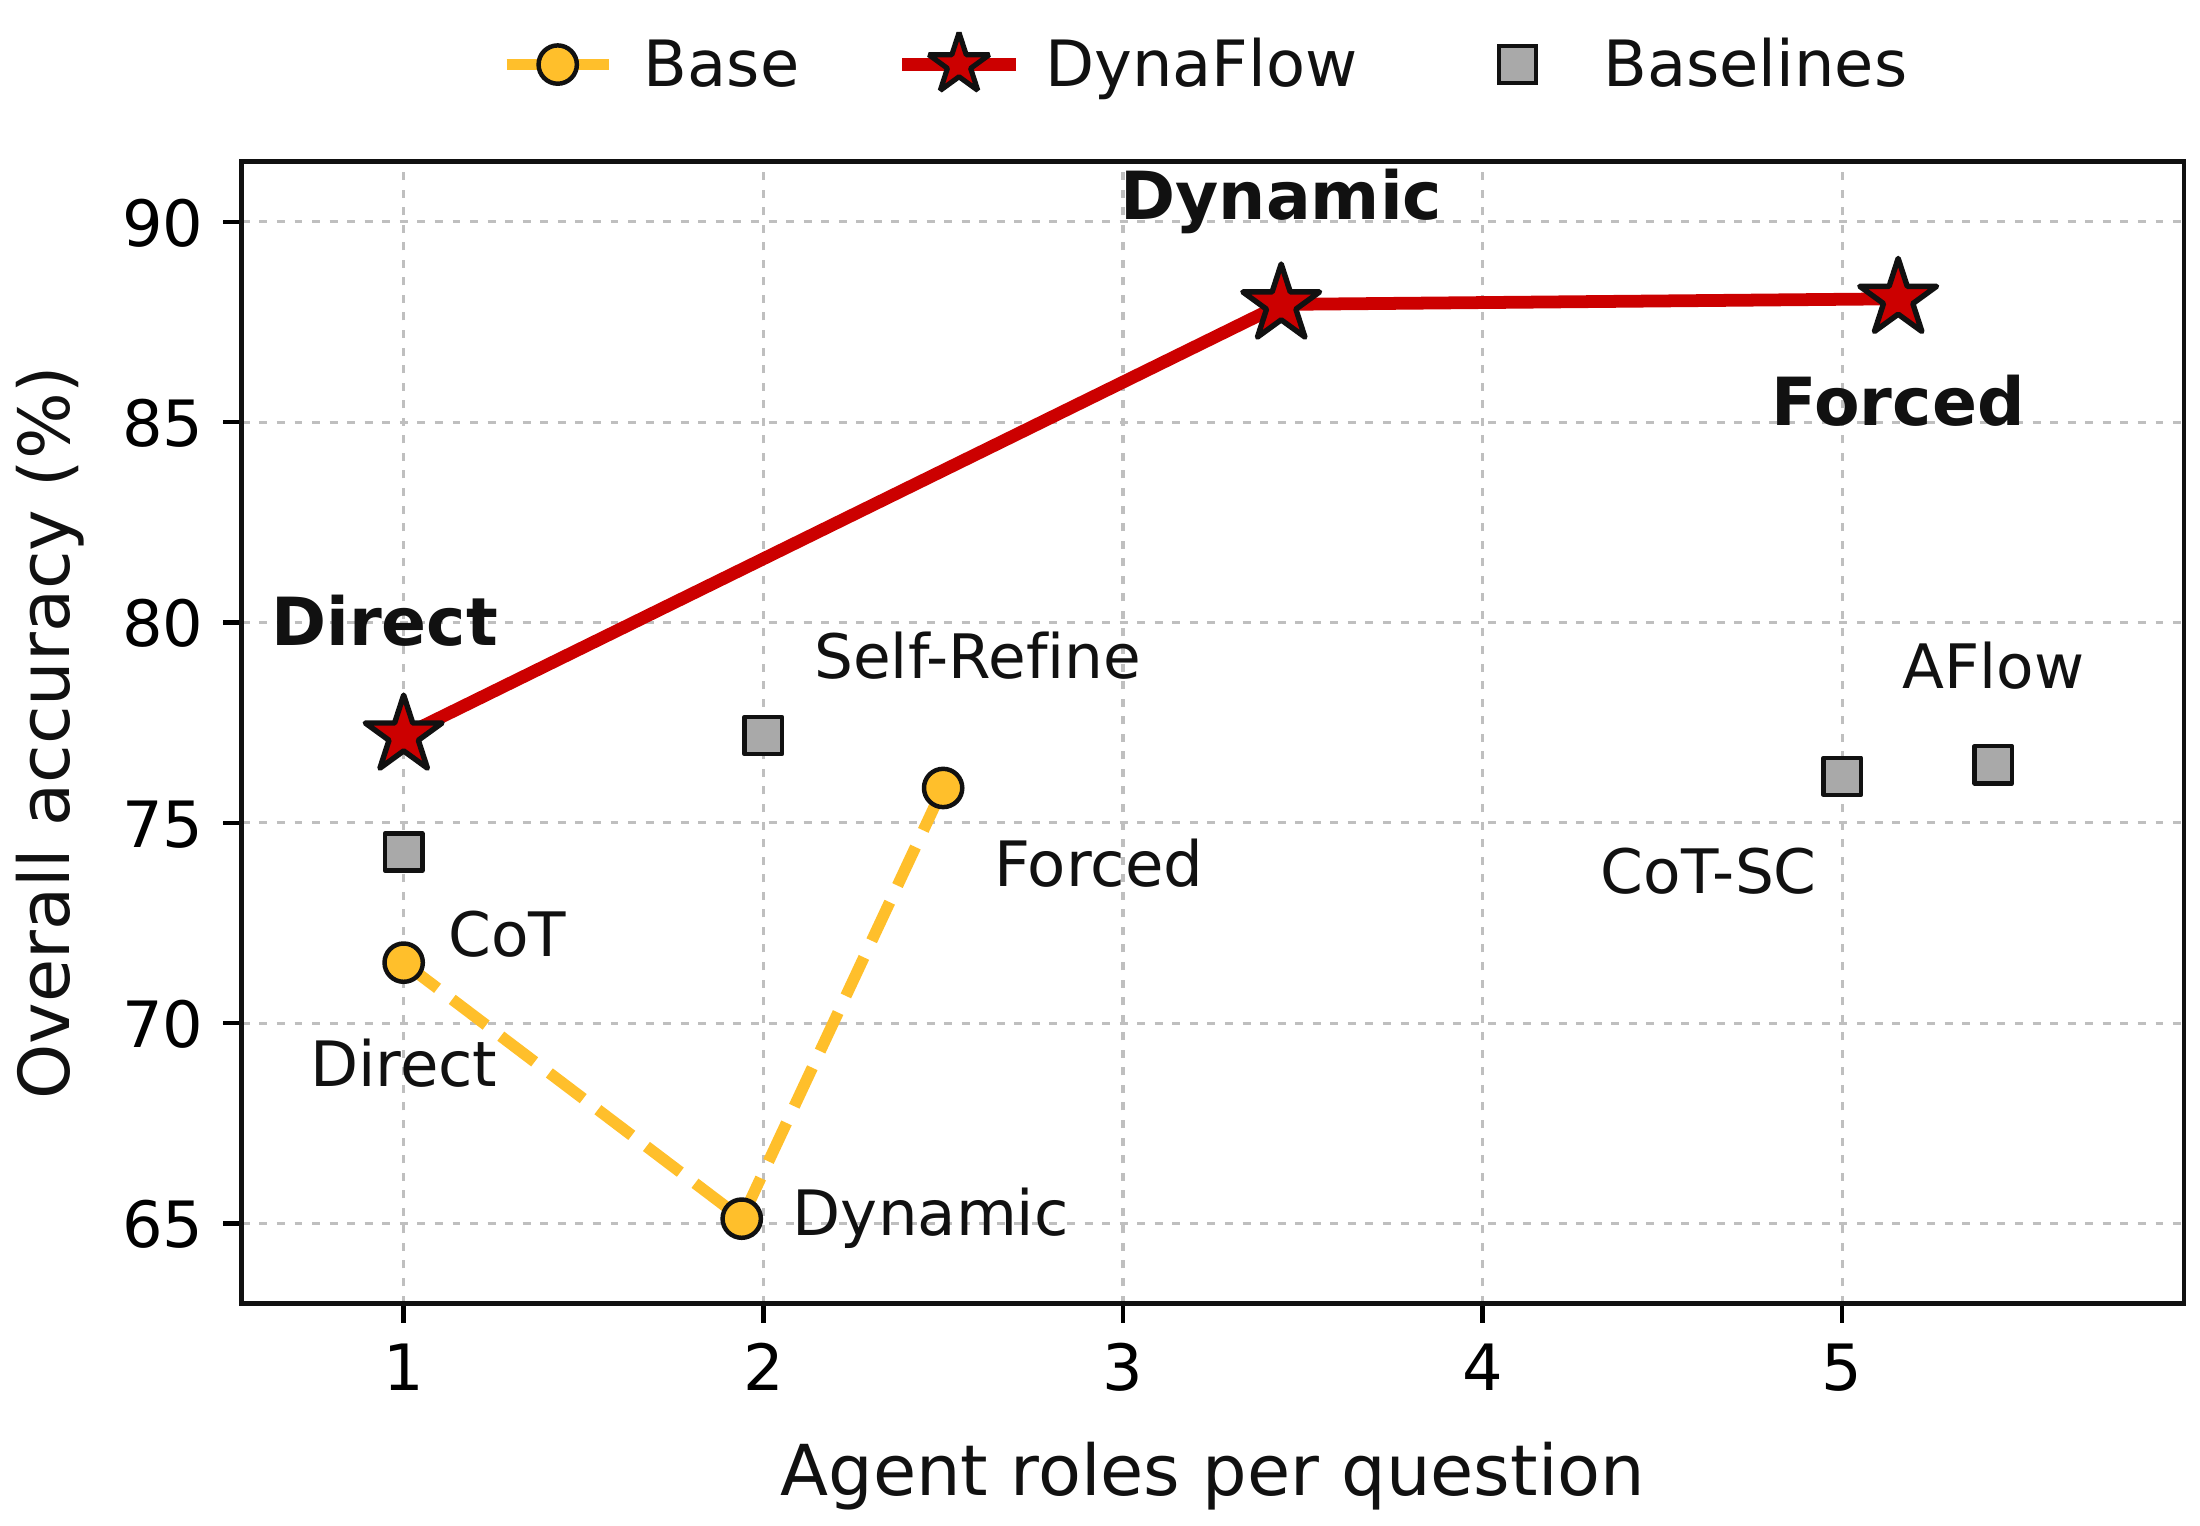
Свободная оркестрация: какой должна быть команда ИИ-агентов
Оркестрацией называют организацию работы агентов: кто что делает, в каком порядке и как они обмениваются результатами. Обычно её задают заранее, одинаково для любой задачи. Но простому вопросу хватит одного агента, независимые подзадачи выгоднее решать параллельно, а на зависимых этапах каждый следующий агент должен получить результат предыдущего. Авторы называют это свободной оркестрацией (Free Orchestration): модель сама решает, нужна ли команда, и собирает её под задачу по ходу решения.
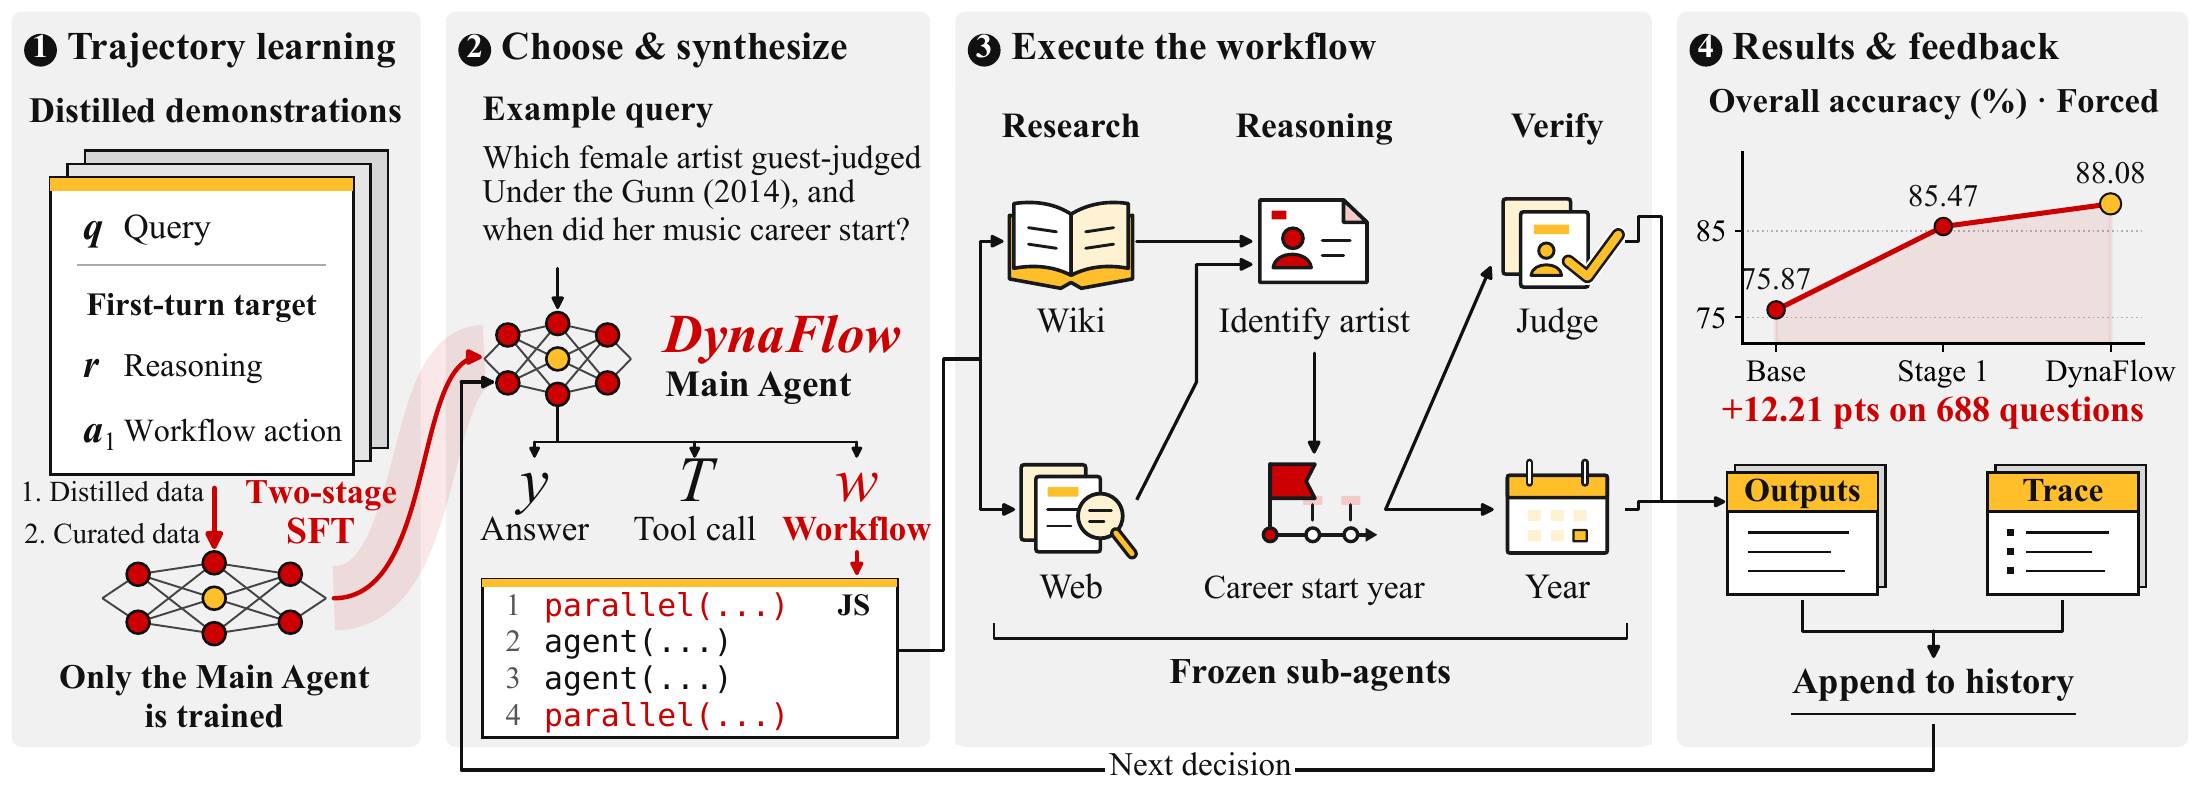
Как устроена команда ИИ-агентов в DynaFlow
На каждом шаге главный агент выбирает из трёх действий: ответить, вызвать инструмент вроде веб-поиска или написать скрипт для команды. Такой скрипт авторы называют workflow. Это программа на JavaScript, где команда agent вызывает субагента, parallel запускает несколько вызовов одновременно, а pipeline выстраивает зависимые этапы. Субагент видит только то, что передано в скрипте, рассуждений главного агента он не знает. Главный агент получает итог и журнал ответов каждого субагента и по ним решает, отвечать, перепроверять или запускать новый workflow.
Три режима работы
DynaFlow проверяли в трёх режимах:
- в Direct главный агент отвечает сам, без инструментов и субагентов;
- в Dynamic он сам выбирает между прямым ответом и workflow;
- в Forced он обязан запустить workflow.
В двух последних режимах главный агент только планирует и подводит итог, а решают и проверяют субагенты.
Как обучали главного агента
Главного агента обучали на готовых примерах (supervised fine-tuning) в два этапа. На первом этапе (Stage 1) модель-учитель GLM-5.3 Max решала задачи с теми же субагентами, а записи её решений, то есть рассуждения и написанные скрипты, стали обучающими примерами. Оставили около 2 тысяч решений с правильным ответом из HotpotQA и BrowseComp, наборов вопросов с поиском в интернете. Учили только тому, как разобрать задачу и написать первый workflow.
Верный ответ ещё не означает, что команда была организована хорошо. Поэтому на втором этапе (Stage 2) модель DeepSeek-V4.1-Flash в роли судьи искала в скриптах учителя три типа ошибок.
- Главный агент выдаёт субагентам непроверенные утверждения за факты.
- Инструкция подталкивает проверяющего агента к ожидаемому ответу вместо честной проверки.
- Нужные данные не доходят до следующего агента, авторы называют это дефектом передачи информации.
После отбора осталось 712 примеров, на которых модель доучили. Дообучали через QLoRA: веса Qwen сжаты до 4 бит и заморожены, а обучаются только добавочные матрицы, около 117 млн параметров из 27 млрд.
Результаты
DynaFlow проверяли на 688 задачах из шести бенчмарков: олимпиадная математика AIME 2024-2026, многоязычная математика PolyMATH, вопросы уровня аспирантуры по биологии, химии и физике GPQA-Diamond и HotpotQA, где ответ собирается из нескольких поисковых шагов. DynaFlow сравнили с четырьмя подходами на базе той же Qwen3.5-27B. В CoT модель просто рассуждает по шагам, в CoT-SC даёт пять ответов и выбирает самый частый, в Self-Refine критикует и исправляет собственный ответ, а AFlow использует готовые мультиагентные workflow, заранее подобранные автоматически. Лучшим из них оказался Self-Refine: 77.18% против 88.08% у DynaFlow в режиме Forced.
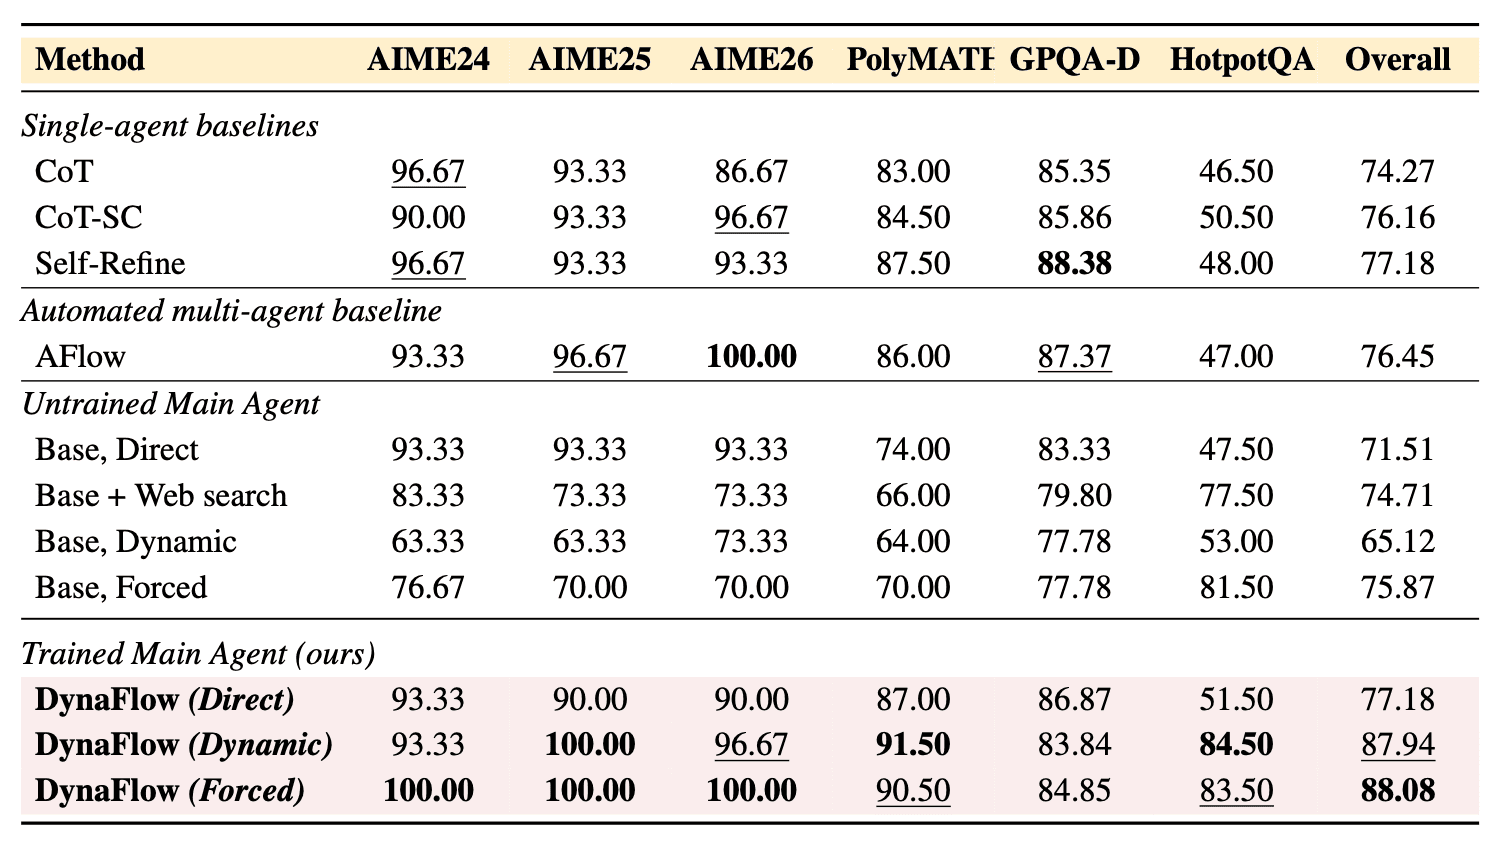
Самый большой прирост получился на математике, хотя обучающие примеры были только из задач на поиск: на PolyMATH точность выросла с 70.00% до 90.50%. Похоже, модель научилась организации командной работы, а этот навык не зависит от области. На HotpotQA у методов для сравнения нет поиска, поэтому честнее сравнение с той же Qwen с веб-поиском: её DynaFlow обходит на 6-7 процентных пунктов (п.п.).
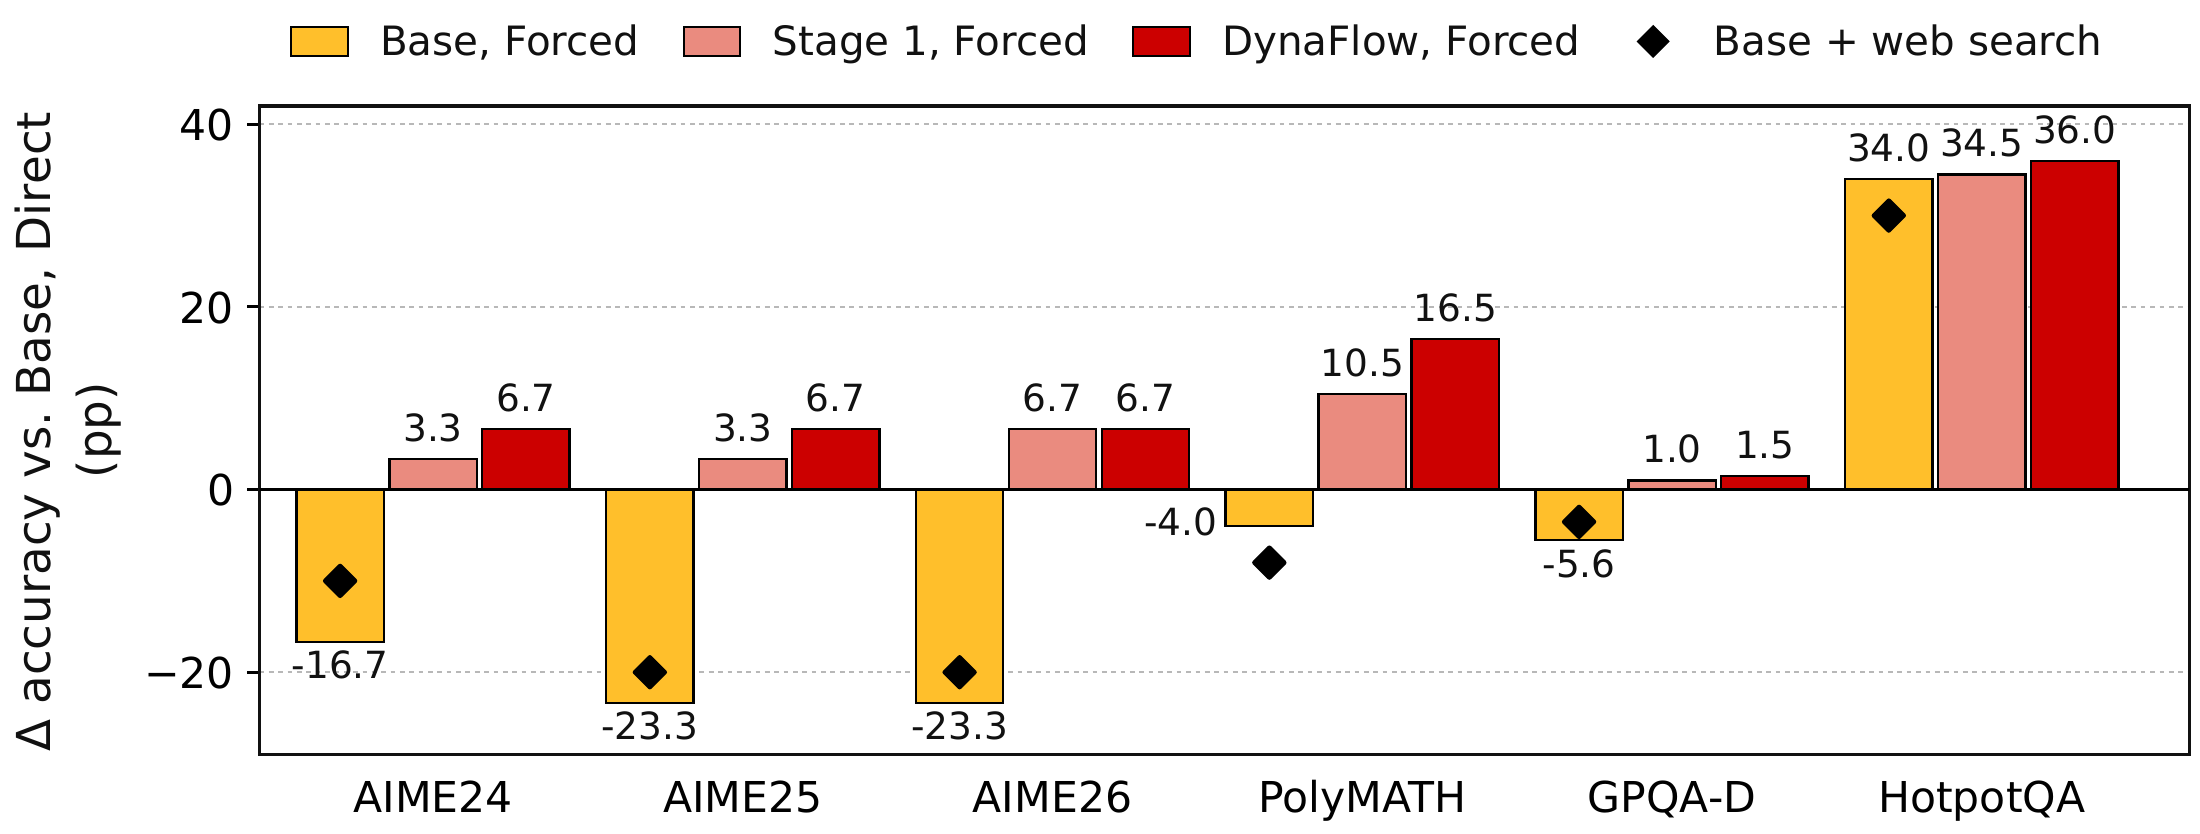
Без обучения команда только мешает. Необученный главный агент (на графиках Base) в режиме Forced проигрывает самому себе в режиме Direct везде, кроме HotpotQA, где workflow даёт доступ к поиску, а на AIME 2025 и 2026 теряет по 23.3 п.п. После обучения Forced не хуже Direct на всех шести бенчмарках.
Слабое место модели GPQA-Diamond: 84.85% против 88.38% у Self-Refine. Здесь ошибка одного субагента сбивает следующую проверку, а главный агент не всегда выбирает верные аргументы для ответа.
Как после обучения меняется команда ИИ-агентов
Почему обучение помогает, видно по самим скриптам. Гибридных скриптов, где параллельные этапы сочетаются с последовательными, до обучения было 3.4%, а после стало 85.6%. Доля скриптов, где результат одного этапа передаётся следующему с прямым указанием его использовать, выросла с 12.6% до 97.7%. Отбор примеров на втором этапе вдвое сократил серьёзные дефекты передачи информации: с 1.9% до 0.9%.
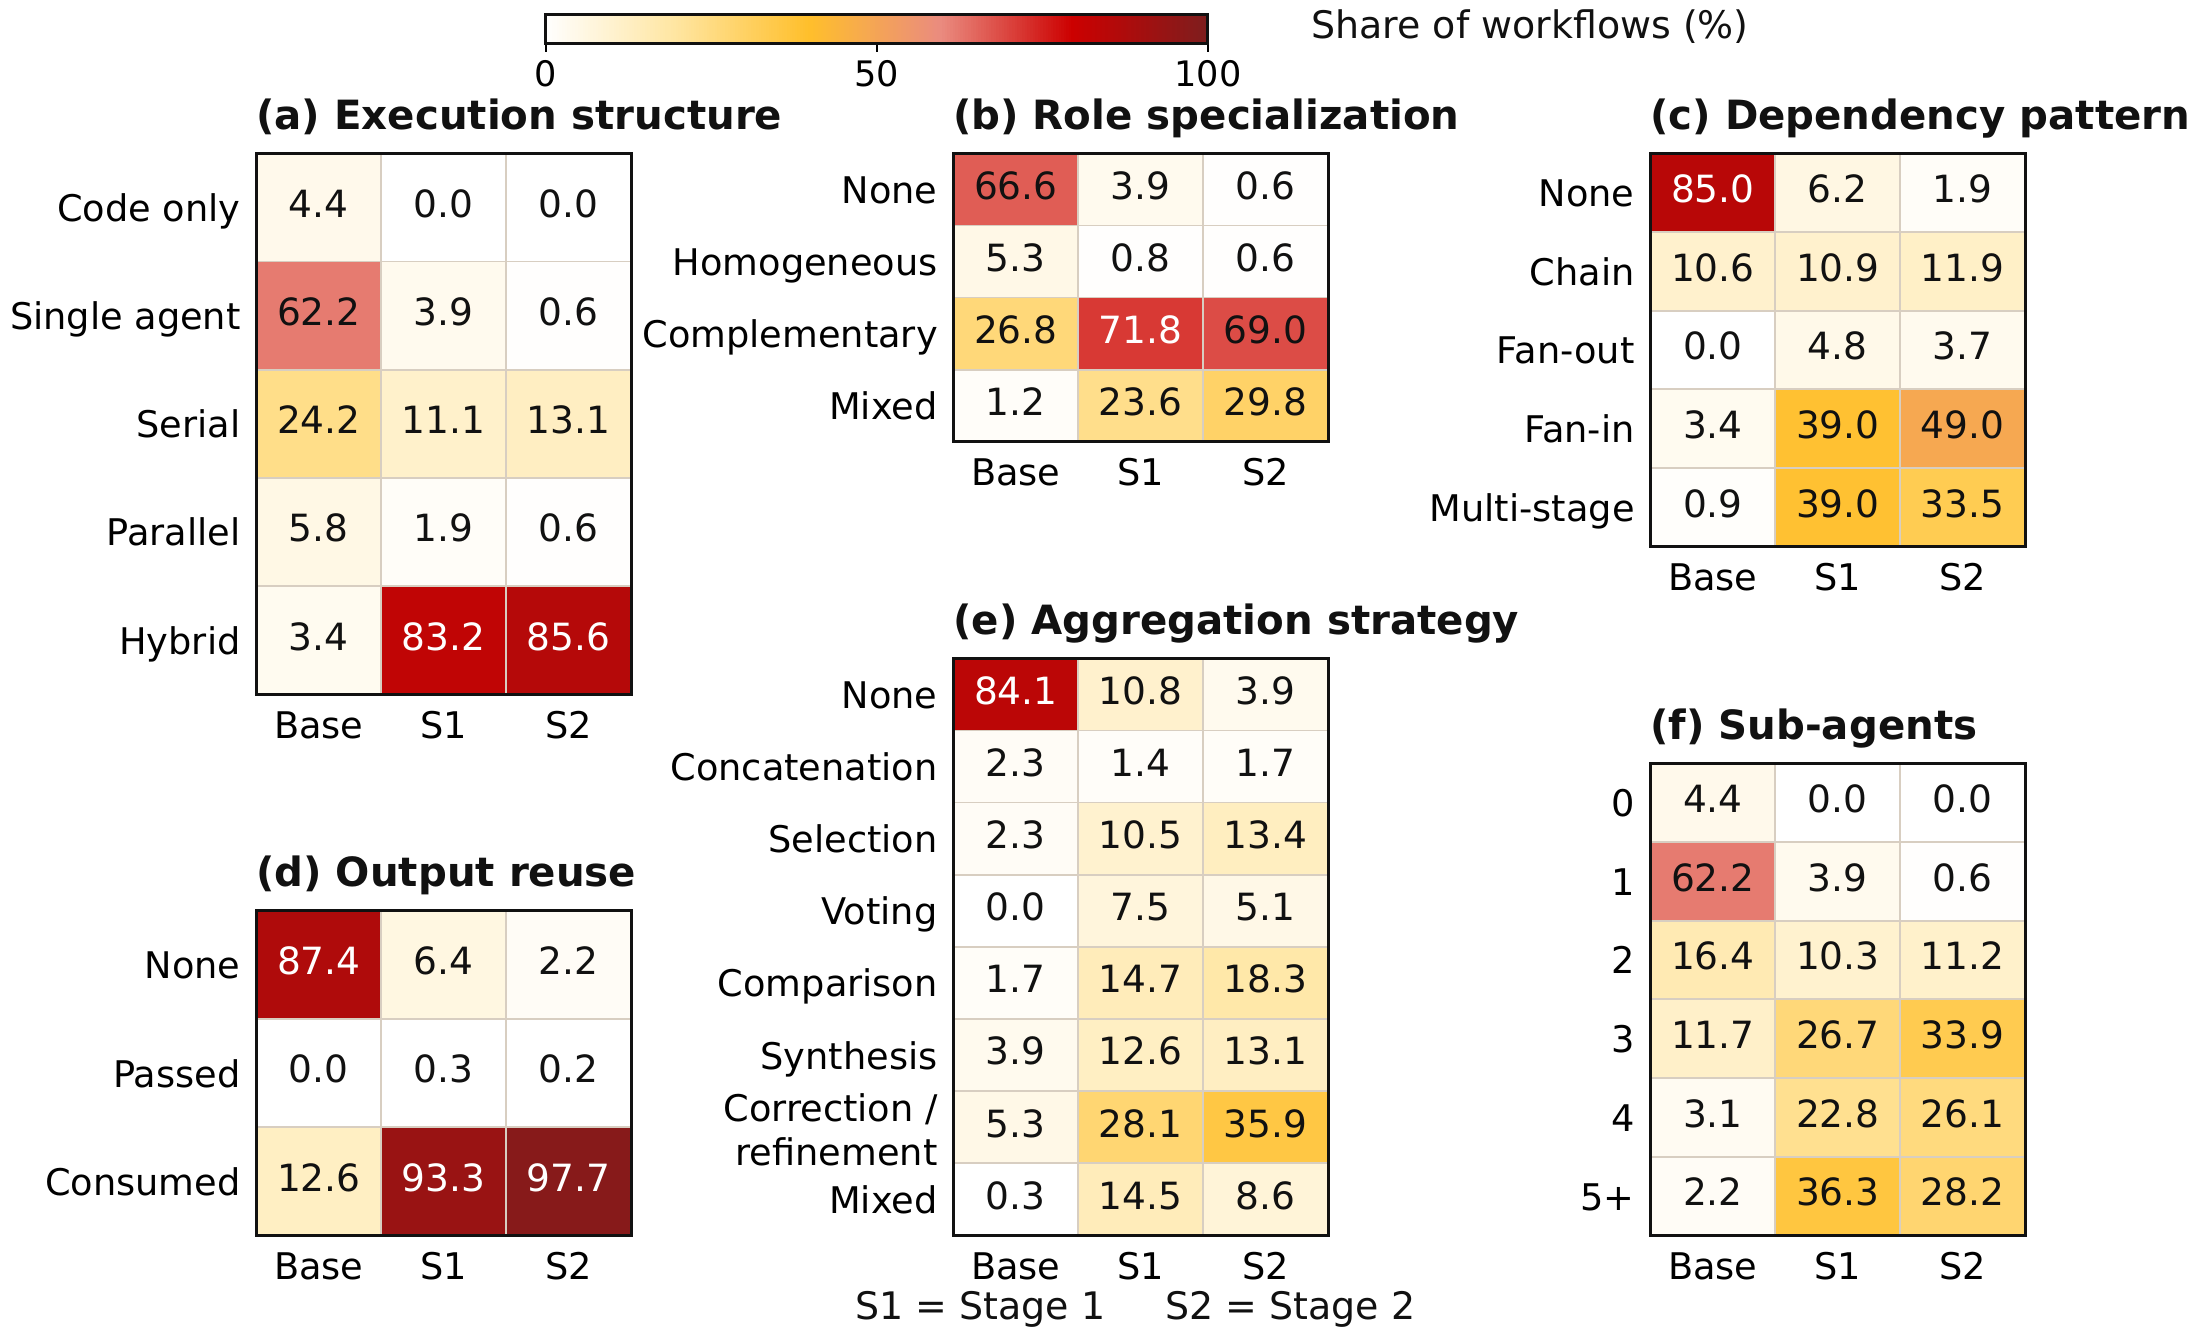
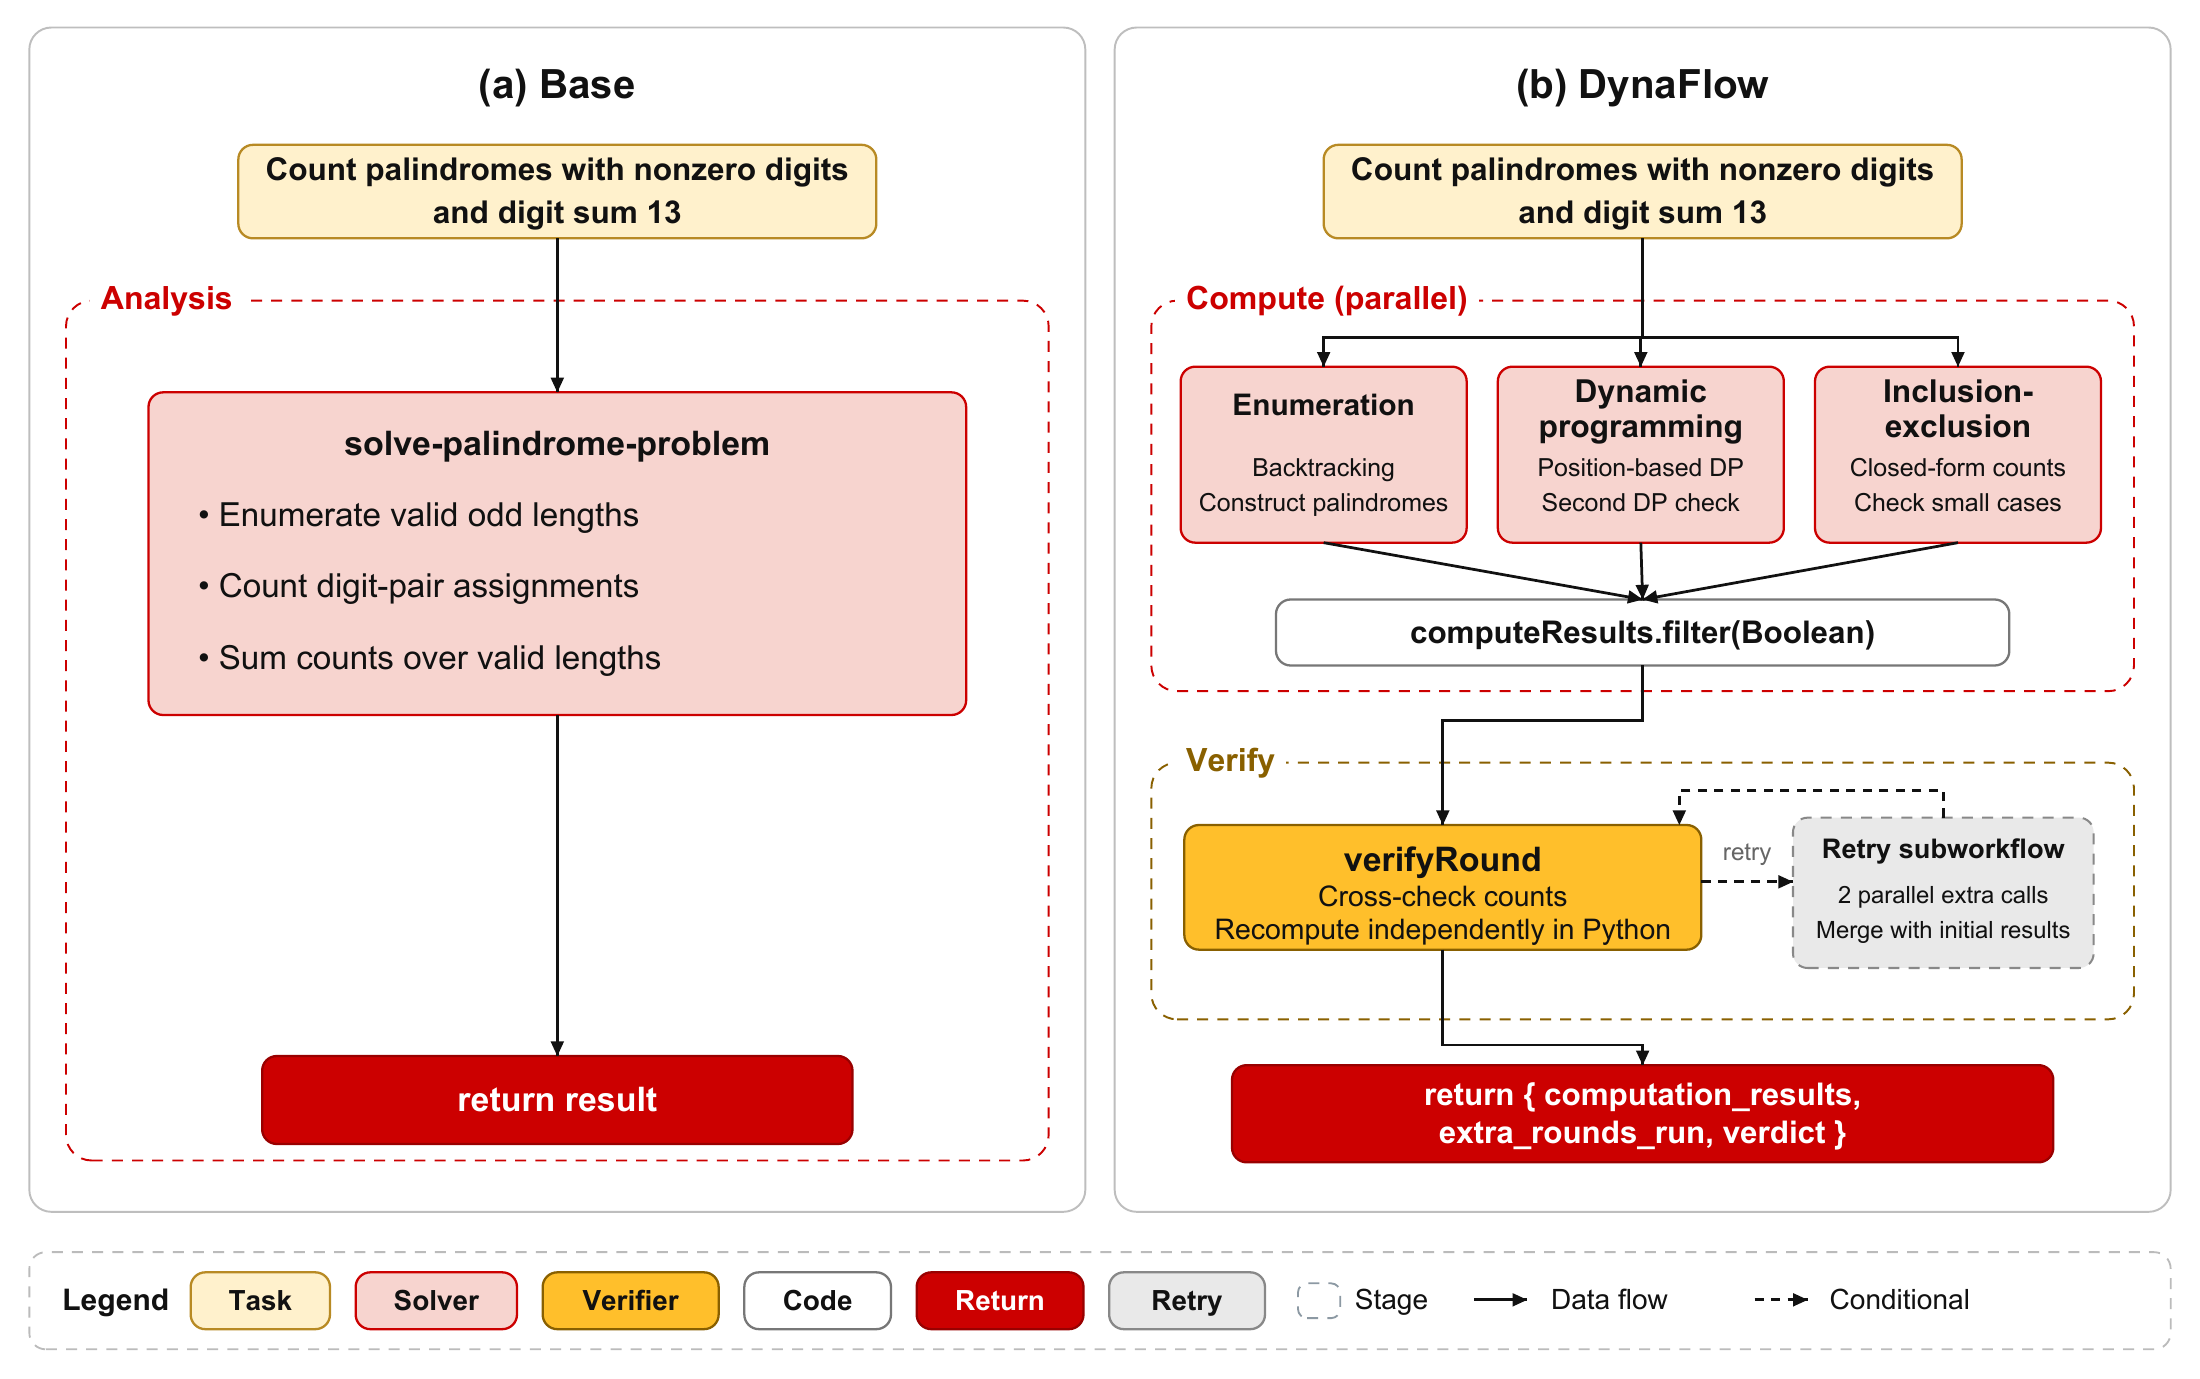
Команда ИИ-агентов подстраивается под задачу. На математике больше 90% вызовов получают решатели и проверяющие, а на HotpotQA 59.6% вызовов приходится на исследователей, которые ищут информацию. В задаче о подсчёте палиндромов из AIME 2026 необученный агент поручил всё одному решателю и ошибся: 59 вместо 62. DynaFlow запустил трёх решателей с разными методами и проверяющего, и все четверо получили верный ответ 62.
Ограничения
Субагентов не дообучали, поэтому итоговое качество упирается в их собственные ошибки, как на GPQA-Diamond. Главного агента учили только первому шагу, реагировать на противоречивые ответы субагентов он не учился. Главный вывод работы: качество мультиагентной оркестрации зависит в первую очередь от того, насколько аккуратно промежуточные результаты передаются, проверяются и уточняются между этапами.