Глубокое обучение работает на видеокартах, и от выбора GPU зависит, займёт эксперимент минуты или дни и поместится ли модель на ваш компьютер вообще. В 2026 году выбор сложнее, чем когда-либо: есть игровые и профессиональные видеокарты, компактные «ИИ-компьютеры» с большим объёмом общей памяти и серверные GPU, которые большинство не покупает, а арендует. Вдобавок мировой дефицит памяти поднял цены многих моделей намного выше официальных.
В статье разберём, что на самом деле важно в видеокарте для нейросетей, сколько памяти нужно для обучения и для запуска LLM на своём компьютере, какие GPU имеет смысл брать при разном бюджете в конце 2026 года и когда выгоднее арендовать облачный GPU.
Главное
- Сначала смотрите на объём видеопамяти (VRAM): он определяет, какие модели поместятся. LLM на 32 млрд параметров в 4 битах требует около 21 ГБ, на 70 млрд — около 43 ГБ; полное дообучение — примерно 16 байт на параметр.
- Скорость генерации определяет пропускная способность памяти: для каждого нового токена LLM читает все веса, поэтому токены в секунду ограничены пропускной способностью, делённой на размер модели.
- NVIDIA по-прежнему самый надёжный выбор из-за CUDA, но AMD ROCm, Apple MLX и Intel уже подходят для многих задач.
- Цены в 2026 году искажены дефицитом DRAM: RTX 5090 с рекомендованной ценой $1,999 во второй половине 2026 года продавалась за $4,000–9,000. Сверяйте актуальные цены, смотрите на б/у карты и облако.
- Большие модели обучайте в облаке: аренда H100 стоит примерно $2–7 в час, что выгоднее покупки для разовых крупных задач.
Зачем нейросетям видеокарта
Обучение и работа нейросети — это в основном умножение матриц: каждый слой умножает входные данные на матрицу весов, а обратное распространение ошибки делает то же в обратную сторону, чтобы посчитать градиенты. У процессора несколько десятков мощных ядер, у видеокарты — тысячи простых и очень быстрая память, поэтому такие параллельные вычисления она выполняет в десятки и сотни раз быстрее. С 2017 года в видеокартах NVIDIA есть ещё и тензорные ядра — блоки для умножения матриц в пониженной точности (FP16, BF16, FP8, а начиная с поколения Blackwell и FP4), которые ускоряют вычисления ещё в несколько раз.
Быстрый GPU позволяет проверять идеи за часы вместо дней и ставить больше экспериментов, а это не менее важно, чем итоговая модель. Для запуска моделей видеокарта определяет, что вообще можно использовать локально: на ноутбучной видеокарте работают небольшие модели, на карте с 24 ГБ — хорошая LLM на 32 млрд параметров, а модели на 70 млрд нужно 48 ГБ и больше.
Что важно в GPU для нейросетей
Примерно в порядке важности:
- Объём памяти (VRAM). В память GPU должны поместиться веса модели, активации, состояния оптимизатора, а для LLM ещё и KV-кэш. Если не помещается, задачу не запустить вовсе или она будет работать очень медленно с выгрузкой в оперативную память. Это первый фильтр при любом выборе.
- Пропускная способность памяти. Скорость, с которой данные передаются между памятью и вычислительными блоками. Генерация текста LLM упирается именно в неё: для каждого нового токена нужно один раз прочитать все веса. Пропускная способность также ограничивает рекуррентные сети, инференс с маленьким батчем и многие задачи обучения.
- Производительность тензорных ядер и поддерживаемые форматы. Пиковые TFLOPS в FP16, BF16, FP8 и FP4 важны для обучения и для обработки длинных промптов. Каждый шаг вниз по точности примерно удваивает производительность, если ваш софт его использует.
- Программная экосистема. PyTorch, JAX, vLLM, llama.cpp, Hugging Face и почти весь исследовательский код в первую очередь разрабатываются под NVIDIA CUDA. AMD ROCm уже поддерживает PyTorch и основные движки инференса на новых видеокартах, Apple MLX хорошо запускает LLM на Mac, Intel поддерживает PyTorch через бэкенд XPU, но вне NVIDIA проблем с совместимостью будет больше.
- Питание, охлаждение и размер. Топовая видеокарта потребляет 450–600 Вт, ей нужны мощный блок питания, хорошая продуваемость корпуса и место.
На графике ниже современные видеокарты и ИИ-компьютеры расположены по двум главным для LLM характеристикам. Объём памяти по горизонтали показывает, какие модели поместятся, пропускная способность по вертикали — насколько быстро они будут работать:
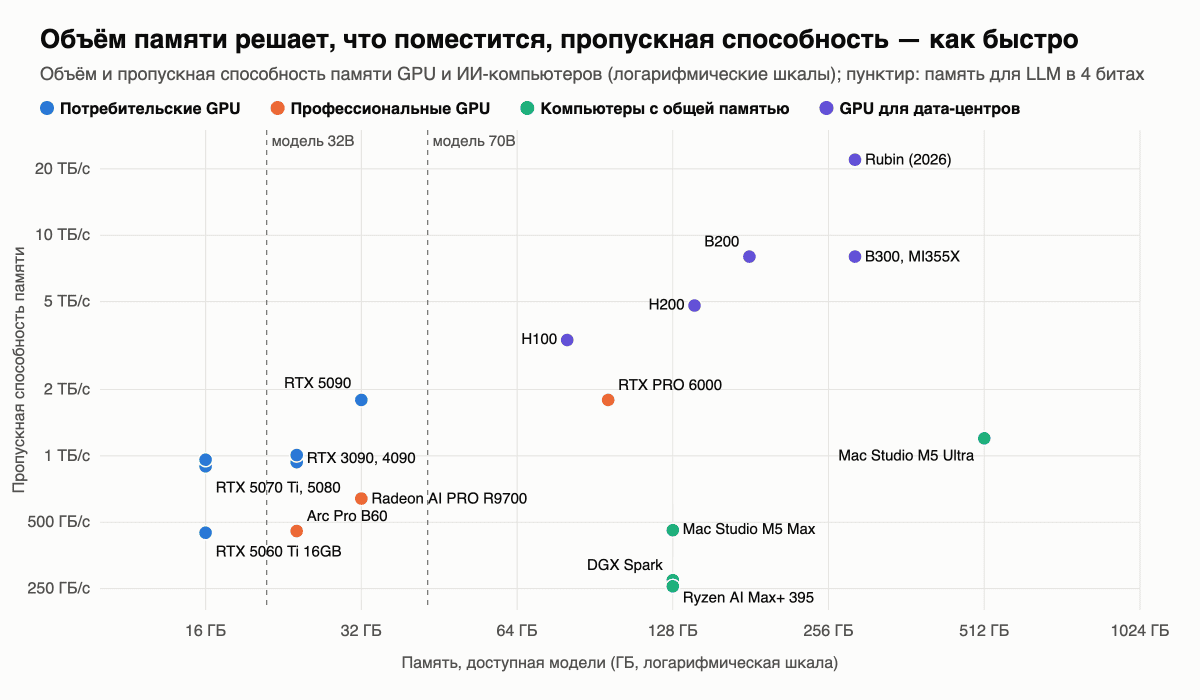
Видно три группы. Игровые видеокарты быстрые, но памяти у них немного — 16–32 ГБ. Компьютеры с общей памятью — NVIDIA DGX Spark, системы на AMD Ryzen AI Max+ и Mac Studio — дают 128–512 ГБ, но с меньшей пропускной способностью: огромные модели в них помещаются, но генерируют текст медленно. Серверные GPU сочетают и то и другое, но по такой цене, что доступны в основном в облаке.
Сколько видеопамяти нужно
Для запуска модели (инференса) память примерно равна размеру весов — числу параметров, умноженному на байты на параметр (2 для FP16, 1 для 8 бит, около 0,55 для распространённых 4-битных форматов), плюс KV-кэш, который растёт с длиной контекста. Для обучения с оптимизатором Adam в смешанной точности нужно около 16 байт на параметр на веса, градиенты и состояния оптимизатора, плюс активации. Скрипт ниже делает эти оценки и показывает, почему скорость генерации ограничена пропускной способностью:
# Грубая оценка видеопамяти для запуска и дообучения языковой модели на основе трансформера
GB = 1024 ** 3

def inference_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1):
    weights = params_b * 1e9 * bits / 8                                  # веса модели
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * 2    # ключи и значения (KV-кэш) в FP16
    return (weights + kv_cache) * 1.1 / GB                               # +10% на активации и среду выполнения

def full_finetune_gb(params_b):
    # веса и градиенты в FP16/BF16 + FP32-копия весов и два момента Adam = 16 байт на параметр,
    # не считая активаций
    return params_b * 1e9 * 16 / GB

models = {                       # параметры (млрд), слои, KV-головы, размер головы (архитектура как у Llama 3)
    "8B":  (8, 32, 8, 128),
    "32B": (32, 64, 8, 128),
    "70B": (70, 80, 8, 128),
}
print("модель  16 бит   8 бит   4 бита  (запуск, контекст 8K)   полное дообучение с Adam")
for name, (p, layers, kv, hd) in models.items():
    row = [inference_gb(p, bits, layers, kv, hd, 8192) for bits in (16, 8, 4.5)]
    print(f"{name:>5}  {row[0]:6.0f} ГБ {row[1]:4.0f} ГБ {row[2]:4.0f} ГБ {'':24}{full_finetune_gb(p):6.0f} ГБ")

# Для генерации каждого токена нужно один раз прочитать все веса, поэтому скорость ограничена пропускной способностью
weights_gb = 32 * 4.5 / 8          # модель 32B в 4-битном формате (около 4,5 бита на вес с учётом масштабов): 18 ГБ
for gpu, bandwidth in [("DGX Spark", 273), ("RTX 3090", 936), ("RTX 5090", 1792), ("H200", 4800)]:
    print(f"{gpu:10s} {bandwidth:5d} ГБ/с -> не больше {bandwidth / weights_gb:4.0f} токенов/с для модели 32B в 4 битах")
модель 16 бит 8 бит 4 бита (запуск, контекст 8K) полное дообучение с Adam
8B 17 ГБ 9 ГБ 6 ГБ 119 ГБ
32B 68 ГБ 35 ГБ 21 ГБ 477 ГБ
70B 146 ГБ 74 ГБ 43 ГБ 1043 ГБ
DGX Spark 273 ГБ/с -> не больше 15 токенов/с для модели 32B в 4 битах
RTX 3090 936 ГБ/с -> не больше 52 токенов/с для модели 32B в 4 битах
RTX 5090 1792 ГБ/с -> не больше 100 токенов/с для модели 32B в 4 битах
H200 4800 ГБ/с -> не больше 267 токенов/с для модели 32B в 4 битахПрактические ориентиры:
- 8–12 ГБ: обучение и учебные проекты, классическое компьютерное зрение на свёрточных сетях, небольшие LLM до 8 млрд параметров в 4 битах, генерация изображений небольшими диффузионными моделями.
- 16 ГБ: LLM на 8–14 млрд параметров, большинство моделей для генерации изображений, дообучение небольших моделей с LoRA.
- 24–32 ГБ: LLM на 32 млрд параметров в 4 битах, дообучение QLoRA моделей на 8–32 млрд, крупные модели для изображений и видео.
- 48–128 ГБ: модели на 70 млрд параметров и модели mixture-of-experts на 100+ млрд параметров в 4 битах.
- Полное обучение или дообучение моделей от 7 млрд параметров: серверные GPU с 80 ГБ, обычно несколько штук, то есть облако.
LoRA и QLoRA, gradient checkpointing, 8-битные оптимизаторы и шардирование FSDP сильно уменьшают требования к памяти при обучении, поэтому на одной карте с 24 ГБ можно дообучать модели, которым для полного обучения понадобились бы сотни гигабайт.
Лучшие видеокарты для нейросетей в 2026 году
В таблице — самые актуальные варианты на конец октября 2026 года. Цены на старте продаж — официальные рекомендованные цены в США; реальные цены в 2026 году сильно изменились, см. пояснение под таблицей.
| Видеокарта или система | Память | Пропускная способность | Цена на старте | Для чего |
|---|---|---|---|---|
| NVIDIA RTX 5060 Ti 16GB | 16 ГБ GDDR7 | 448 ГБ/с | $429 | Начальный уровень, обучение, небольшие LLM, генерация изображений |
| NVIDIA RTX 5070 Ti | 16 ГБ GDDR7 | 896 ГБ/с | $749 | Быстрая карта на 16 ГБ для обучения небольших и средних моделей |
| NVIDIA RTX 5080 | 16 ГБ GDDR7 | 960 ГБ/с | $999 | Скорость, но упирается в объём памяти |
| NVIDIA RTX 3090 (б/у) | 24 ГБ GDDR6X | 936 ГБ/с | $1,499 в 2020 году | Самая доступная NVIDIA с 24 ГБ, популярна для локальных LLM |
| NVIDIA RTX 4090 | 24 ГБ GDDR6X | 1 008 ГБ/с | $1,599 | Быстрая карта на 24 ГБ, сейчас в основном б/у |
| NVIDIA RTX 5090 | 32 ГБ GDDR7 | 1 792 ГБ/с | $1,999 | Самая быстрая игровая видеокарта для нейросетей |
| Intel Arc Pro B60 | 24 ГБ GDDR6 | 456 ГБ/с | около $599 | Бюджетные 24 ГБ для инференса |
| AMD Radeon AI PRO R9700 | 32 ГБ GDDR6 | 640 ГБ/с | $1,299 | 32 ГБ с ROCm, рабочие станции с несколькими GPU |
| NVIDIA RTX PRO 6000 Blackwell | 96 ГБ GDDR7 | 1 792 ГБ/с | около $8,500 | Профессиональные рабочие станции, модели 70B+ на одной карте |
| NVIDIA DGX Spark | 128 ГБ общей памяти | 273 ГБ/с | $3,999, сейчас $4,699 | Разработка под стек NVIDIA, большие модели на умеренной скорости |
| Системы на AMD Ryzen AI Max+ 395 | до 128 ГБ общей памяти | 256 ГБ/с | зависит от производителя | Недорогой инференс больших моделей |
| Apple Mac Studio M5 Max / M5 Ultra | до 128 / 512 ГБ общей памяти | 460 ГБ/с / 1,2 ТБ/с | от $2,499 / $5,499 | Очень большие модели локально через MLX или llama.cpp |
| NVIDIA H100 / H200 | 80 / 141 ГБ HBM | 3,35 / 4,8 ТБ/с | H100 около $25,000–40,000; H200 продаётся в серверах | Обучение и инференс в дата-центрах, чаще арендуют |
| NVIDIA B200 / B300 | 180 / 288 ГБ HBM3e | 8 ТБ/с | от $30,000, продаются в серверах | Крупномасштабное обучение на текущем поколении |
| AMD Instinct MI355X | 288 ГБ HBM3e | 8 ТБ/с | продаётся в серверах | Инференс и обучение больших моделей на ROCm |
О ценах 2026 года. Спрос на память со стороны ИИ-дата-центров с конца 2025 года вызвал мировой дефицит DRAM, и сильнее всего он ударил по видеокартам, на которых много памяти GDDR. NVIDIA в феврале 2026 года подняла цену DGX Spark с $3,999 до $4,699, сославшись на нехватку памяти, а в августе её собственный магазин показывал RTX PRO 6000 за $16,000 — почти вдвое дороже, чем на старте. Подорожали и игровые карты: к августу RTX 5070 Ti стоила около $1,050–1,100, а RTX 5090 — около $4,400–4,700, в сентябре и октябре самые дешёвые предложения RTX 5090 на маркетплейсах превышали $6,000. Обновлённая серия RTX 50 Super с увеличенной памятью, по сообщениям прессы, отложена на неопределённый срок, а следующее поколение RTX 60 по слухам выйдет не раньше 2027 года. Карты AMD Radeon подорожали меньше. Перед покупкой сравните актуальные цены у продавцов в своей стране: при таких ценах б/у RTX 3090 или аренда облачных GPU часто оказываются выгоднее.
В верхнем сегменте отгрузки следующего серверного поколения NVIDIA — Vera Rubin — запланированы на третий квартал 2026 года, с наращиванием объёмов к концу года. У каждого GPU Rubin 288 ГБ памяти HBM4 с пропускной способностью около 22 ТБ/с — почти втрое больше, чем у Blackwell. AMD отвечает серией Instinct MI400 и стойками Helios с 432 ГБ HBM4 на GPU, их выпуск наращивается во втором полугодии 2026 года. Большинству пользователей эти чипы будут доступны через облачных провайдеров.
Что выбрать под бюджет и задачи
- Только начинаете изучать глубокое обучение: начните бесплатно с Google Colab или Kaggle — там доступны NVIDIA T4 с 16 ГБ. Если покупать, хватит видеокарты NVIDIA с 12–16 ГБ, например б/у RTX 3060 12GB или RTX 5060 Ti 16GB.
- Локальные LLM при небольшом бюджете: б/у RTX 3090 по-прежнему самый популярный выбор благодаря 24 ГБ и высокой пропускной способности. Intel Arc Pro B60 даёт 24 ГБ дешевле, но работает медленнее и требует больше настройки.
- Серьёзная работа на одной игровой карте: RTX 5090 с 32 ГБ и 1,8 ТБ/с — самый быстрый вариант, модели на 32 млрд параметров в 4 битах работают на ней очень быстро. Но при ценах конца 2026 года она оправдана, только если нужна именно скорость; две б/у RTX 3090 дают 48 ГБ дешевле.
- Kaggle, компьютерное зрение, табличные данные: RTX 5070 Ti или аналогичная NVIDIA с 16 ГБ. Здесь скорость важнее огромной памяти. Полезно почитать, как попасть в топ 2% соревнования Kaggle.
- Самые большие открытые модели дома: Mac Studio с M5 Ultra и до 512 ГБ общей памяти, либо DGX Spark или система на Ryzen AI Max+ со 128 ГБ. На них помещаются модели, которые не влезут ни в одну игровую видеокарту, но генерируют они в разы медленнее GPU с той же моделью в памяти и хуже подходят для обучения.
- Профессиональная рабочая станция: RTX PRO 6000 Blackwell с 96 ГБ или, при меньшем бюджете, несколько Radeon AI PRO R9700 по 32 ГБ на ROCm.
- Обучение больших моделей и дообучение, которое не помещается на одну карту: арендуйте H100, H200 или B200 в облаке почасово вместо покупки.
Для генерации изображений логика та же: 12 ГБ хватает для старых версий Stable Diffusion, 16–24 ГБ комфортно для современных моделей и обучения LoRA, а моделям генерации видео нужно от 24 ГБ.
Купить или арендовать: облачные GPU
Покупать стоит, если видеокарта будет загружена каждый день. Арендовать — если большие задачи бывают время от времени, если нужны GPU, которые вы не можете себе позволить, или если нужно сразу много видеокарт. Ориентировочные цены по требованию за один GPU в час осенью 2026 года:
- H100 80GB: около $1,40–2 на GPU-маркетплейсах, $3–5 у специализированных ИИ-облаков и $6–12 в AWS, Google Cloud и Azure.
- H200 141GB: примерно $4–6 у специализированных облаков.
- B200: примерно $5–8,50 у специализированных облаков, дешевле при spot-аренде или долгосрочном резерве.
- RTX PRO 6000 и класс RTX 4090/5090: часто дешевле $2 в час — хороший вариант для инференса и небольшого дообучения.
Облако в 2026 году тоже подорожало: например, Nebius с 1 октября 2026 года поднял цену H100 по требованию с $3,85 до $4,50 в час, а B200 — с $7,15 до $8,50. Российские облачные провайдеры также сдают серверные GPU в аренду; цены в рублях сравнивайте на их сайтах. Подробнее о выборе провайдера — в нашем сравнении облачных GPU для машинного обучения.
Простая проверка окупаемости: если видеокарта стоит $2,500, а аналогичный облачный сервер — $0,70 в час, покупка окупится примерно через 3 500 часов работы, около пяти месяцев непрерывного обучения, без учёта электричества.
Несколько видеокарт, питание и охлаждение
Несколько GPU позволяют обучать быстрее, помещать большие модели, разделяя их между картами, или просто запускать несколько экспериментов параллельно, что ценно само по себе: вы быстрее понимаете, какие идеи и параметры работают. При параллелизме по данным свёрточные сети на двух GPU ускоряются примерно в 1,9 раза, на четырёх — примерно в 3,5 раза; инференс LLM с тензорным параллелизмом тоже хорошо масштабируется. У игровых карт начиная с серии RTX 40 нет NVLink, поэтому видеокарты обмениваются данными через PCIe, и обучение с большим объёмом обмена замедляется. Убедитесь, что материнская плата даёт достаточно линий PCIe.
Самые частые ошибки при покупке видеокарты для нейросетей остались прежними: платить за скорость, когда узкое место — память; брать карту со слишком маленьким объёмом памяти; экономить на охлаждении. Современная топовая видеокарта потребляет 450–600 Вт. Нужен качественный блок питания с запасом и правильные кабели 12V-2×6. Перегретый GPU сбрасывает частоты и может терять 20–30% скорости. Если ставите несколько карт вплотную, лучше подходят карты с турбинным охлаждением или серверный или открытый корпус, чем карты с открытым кулером, которые дуют горячим воздухом на соседнюю.
Что изменилось с 2018 года
В первой версии этой статьи, вышедшей в 2018 году на основе известного анализа Тима Деттмерса, лучшим выбором называлась RTX 2070, а при небольшом бюджете — недорогие карты серии GTX 10. Памяти 8–11 ГБ тогда считалось достаточно почти для любых исследований. Графики из того анализа:
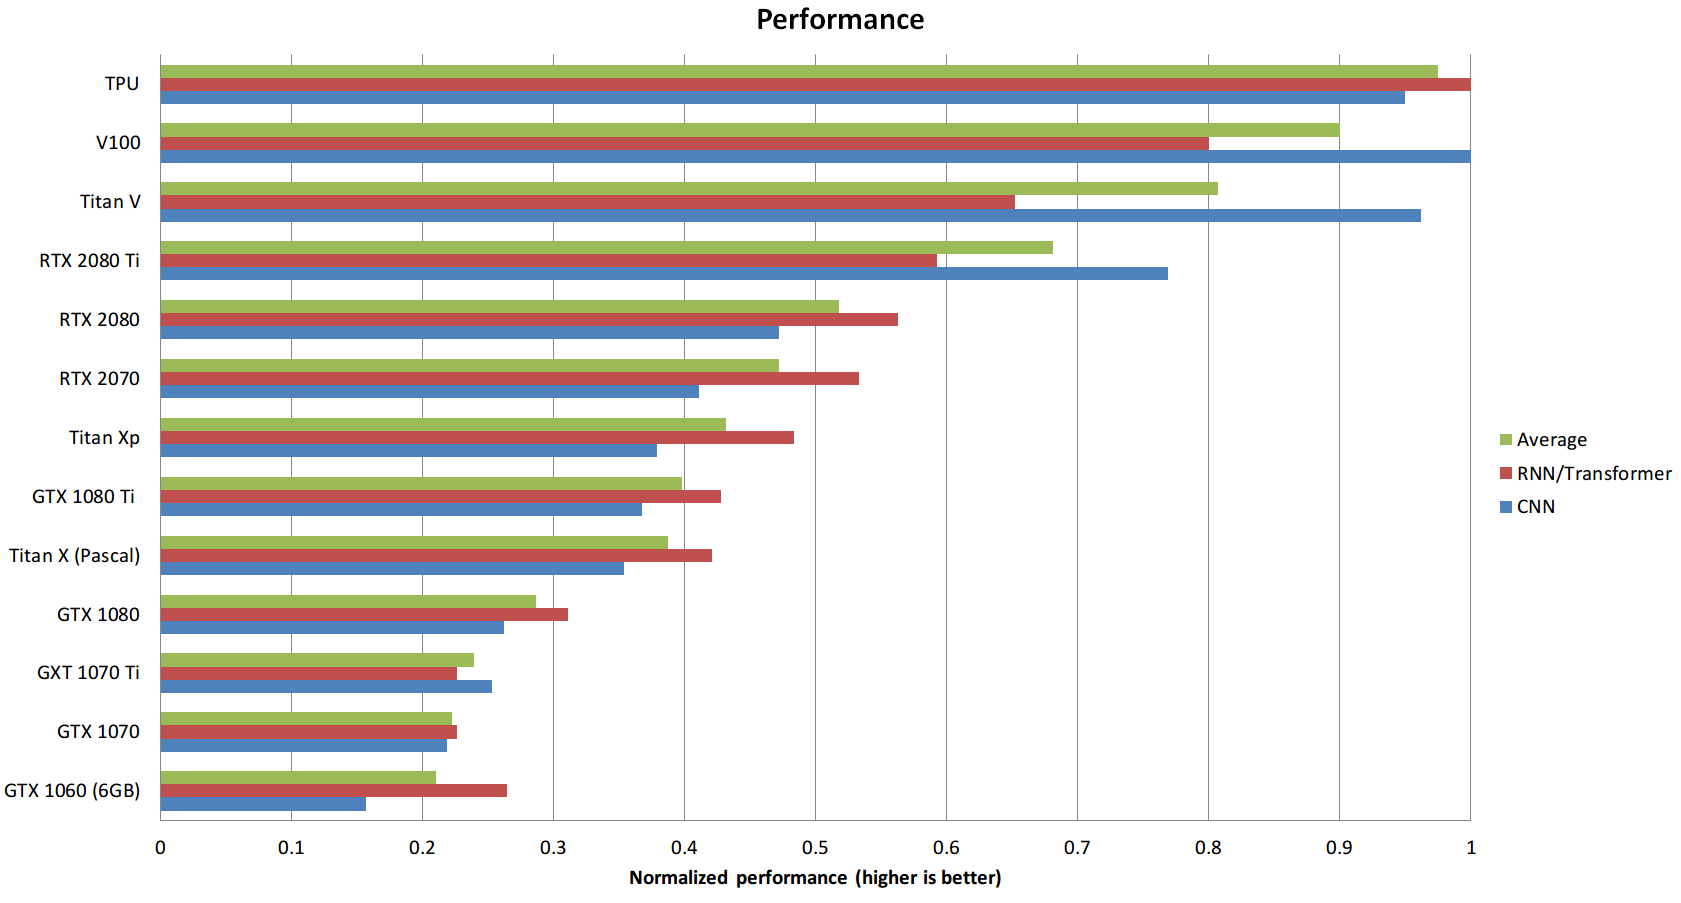
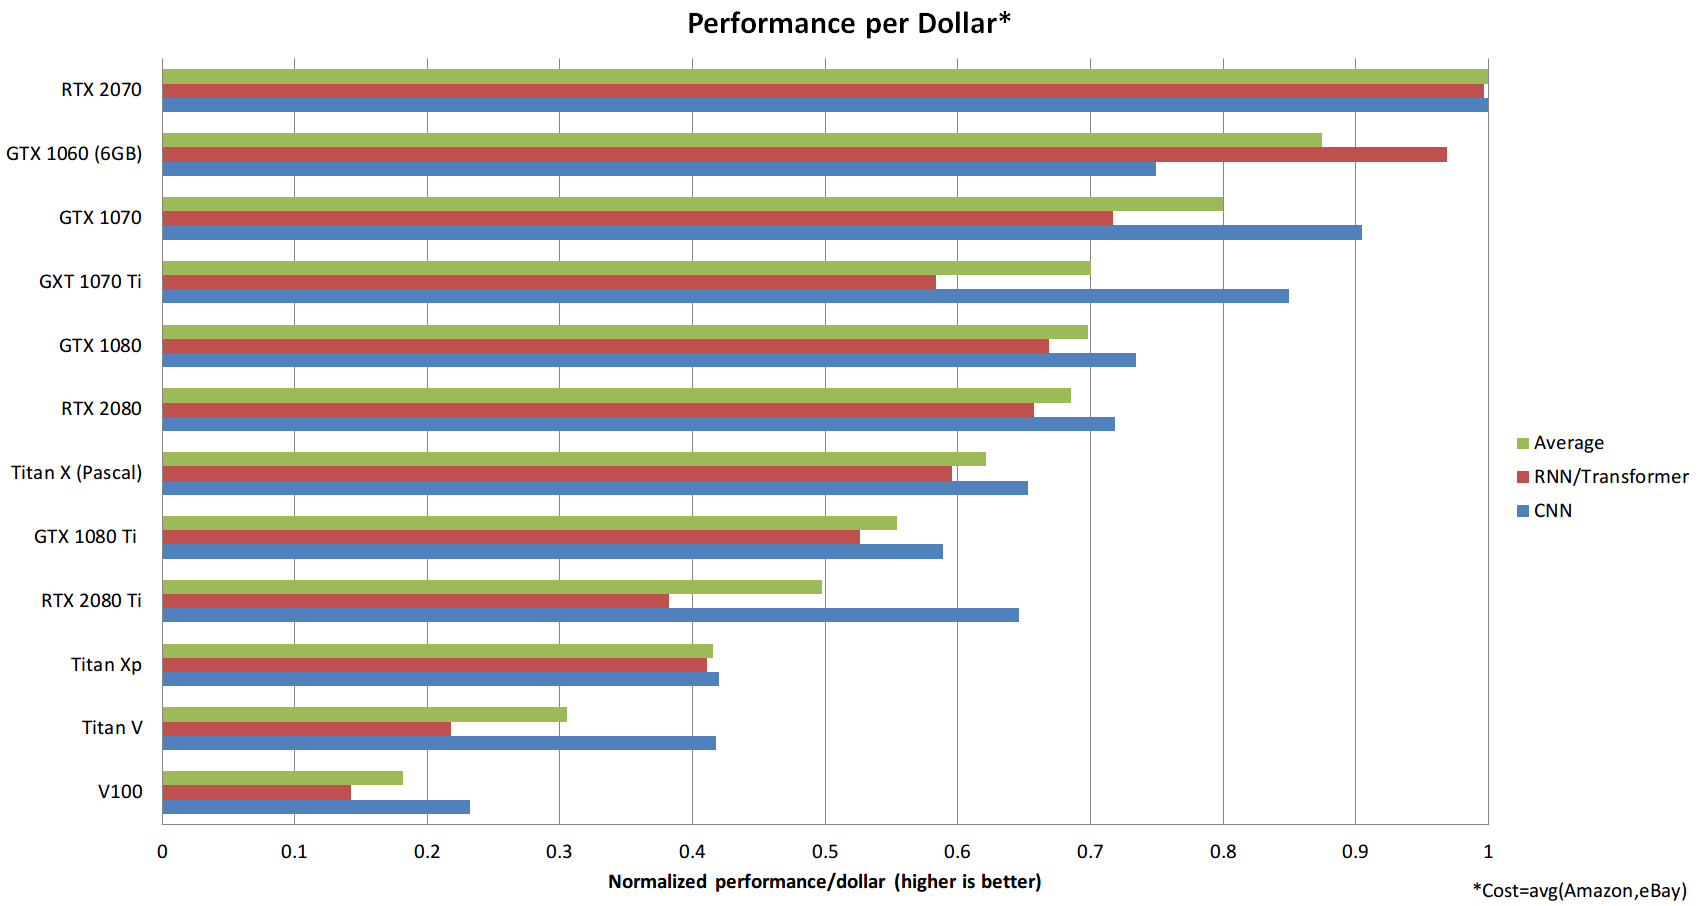
Два вывода того времени верны и сейчас: тензорные ядра и обучение в пониженной точности стоят того, а производительность на доллар важнее пиковой производительности. Изменилась роль памяти. Большие языковые модели сделали объём памяти первым вопросом, пропускную способность — вторым, а вычислительную мощность — третьим. Появление компьютеров с общей памятью и мировой дефицит памяти сделали рынок гораздо менее предсказуемым, чем в эпоху GTX и первых RTX.
Частые вопросы
Какая видеокарта лучше всего подходит для нейросетей в 2026 году?
Среди игровых карт самая быстрая — NVIDIA RTX 5090 с 32 ГБ. Лучшее соотношение цены и возможностей по-прежнему у б/у RTX 3090 с 24 ГБ. Для больших моделей на одной карте — RTX PRO 6000 с 96 ГБ, для самых больших моделей дома — Mac Studio с общей памятью до 512 ГБ. Для обучения в больших масштабах — серверные H100, H200 и B200, обычно в аренду.
Сколько видеопамяти нужно для нейросетей?
Для обучения и большинства проектов по классическому компьютерному зрению и обработке текста хватает 12–16 ГБ. Для локальных LLM 24 ГБ позволяют запускать модели на 32 млрд параметров в 4 битах, а для моделей на 70 млрд нужно 48 ГБ и больше. Полное дообучение больших моделей требует серверных GPU.
Что лучше для нейросетей — NVIDIA или AMD?
У NVIDIA самая зрелая программная платформа CUDA, и почти все инструменты для ИИ поддерживают её в первую очередь. AMD ROCm уже работает с PyTorch, vLLM и llama.cpp на новых Radeon и Instinct и часто даёт больше памяти за те же деньги, но настройки и проблем совместимости будет больше.
Подойдёт ли игровая видеокарта для машинного обучения?
Да. Видеокарты GeForce RTX отлично подходят для глубокого обучения, и именно на них работает большинство исследователей и студентов. Профессиональные карты в основном добавляют больше памяти, сертифицированные драйверы и охлаждение, рассчитанное на несколько GPU в одном корпусе.
Подходит ли Mac для нейросетей?
Для запуска больших LLM локально — да: общая память Apple Silicon позволяет Mac Studio вместить модели, для которых понадобилось бы несколько видеокарт, а MLX и llama.cpp хорошо их запускают. Для обучения видеокарты NVIDIA намного быстрее и лучше поддерживаются.
Обязательна ли видеокарта для машинного обучения?
Для классического машинного обучения — линейной регрессии, деревьев решений, градиентного бустинга — нет, они хорошо работают на процессоре. Для глубокого обучения видеокарта ускоряет обучение в десятки и сотни раз, а для запуска современных LLM с приемлемой скоростью она практически необходима.
Купить видеокарту или арендовать облако?
Покупайте, если будете пользоваться ею почти каждый день несколько месяцев. Арендуйте, если большие вычисления нужны время от времени, если нужны GPU мощнее, чем вы можете купить, или если хотите проверить идею до вложений. Многие совмещают: локальная карта для разработки и облачные GPU для больших запусков.
Читайте также: эпоха, батч, итерация — о том, как размер батча связан с памятью видеокарты, и градиентный спуск.
Статья полностью обновлена в октябре 2026 года. Первая версия 2018 года была переводом руководства Тима Деттмерса; её выводы и графики мы сохранили в разделе «Что изменилось с 2018 года».
Выбрал себе 1660. Посмотрим на что способна.