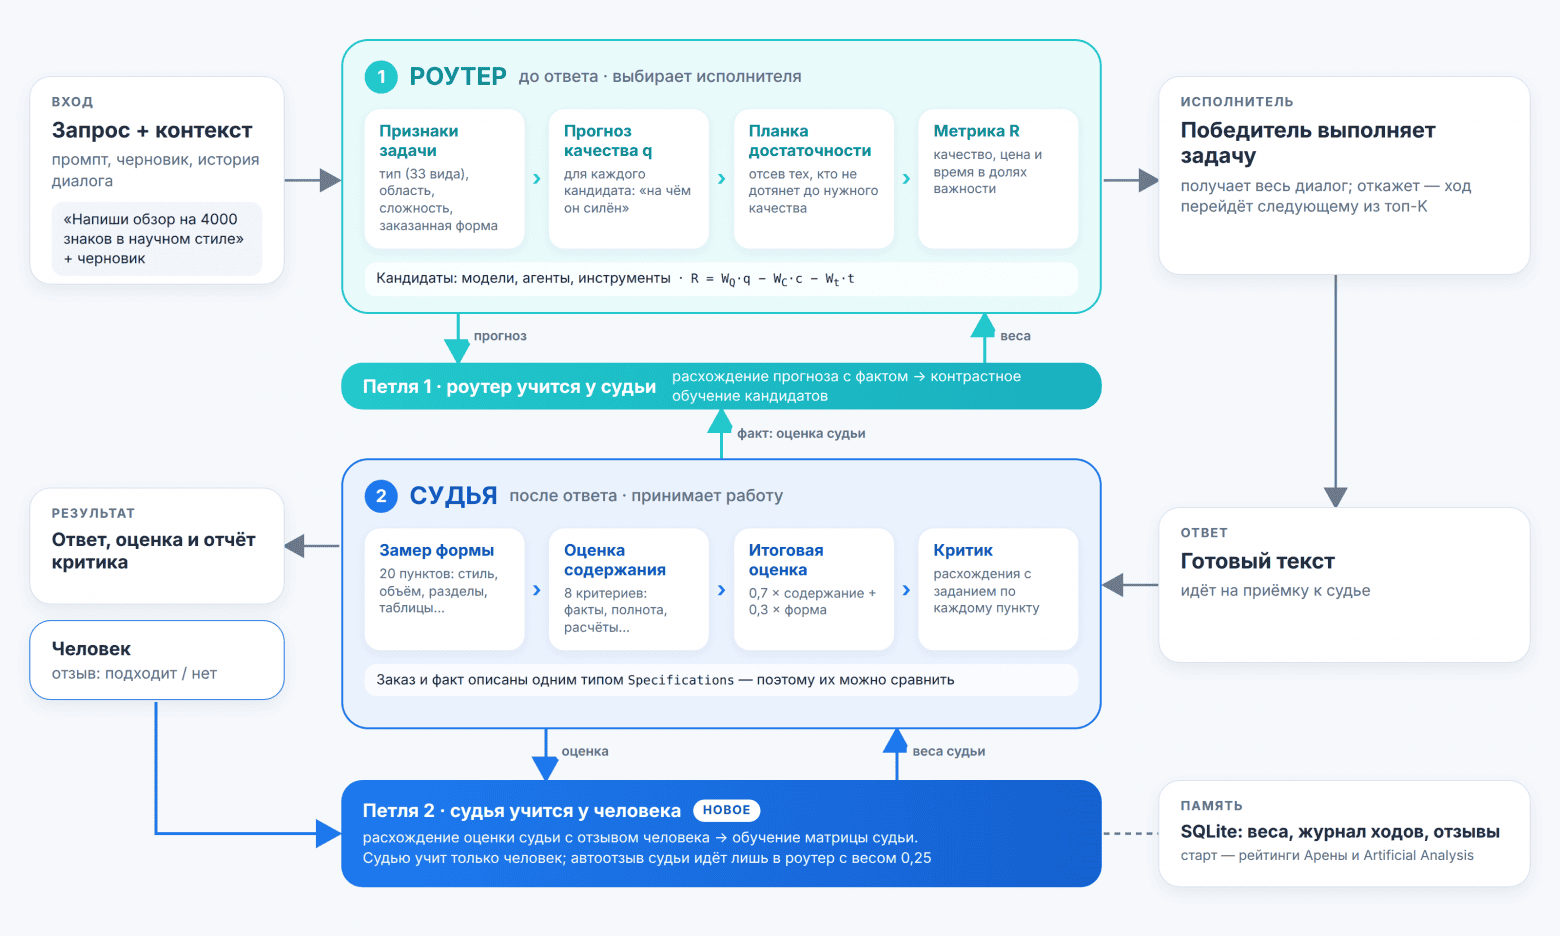
Команда Fractal Agents выпустила FAIRouter, открытый LLM-роутер: библиотеку маршрутизации запросов между языковыми моделями, агентами и инструментами. Для каждого запроса она прогнозирует, какая модель справится с ним достаточно хорошо и при этом обойдётся дешевле, а после ответа модель-судья сверяет результат с заданием и находит расхождения по каждому пункту. Из этих расхождений роутер и учится. В проверке на восьми новых задачах экономный профиль роутера дал качество 0.686 при цене $0.00059 за задачу: это выше, чем у стратегии «всегда самая дешёвая модель» (0.682 за $0.00053), и столько же, сколько у самой дорогой модели (0.687), но в пять раз дешевле. Судья различает хороший и плохой по смыслу ответ на 0.19-0.69 балла, тогда как проверка одной только формы почти не видит разницы (0.01-0.02).
Код открыт под лицензией Apache 2.0 и написан в двух независимых версиях: на Python с единственной зависимостью numpy и на C# под .NET 10. Готовых весов для скачивания нет: веса обучаются локально и хранятся в одном файле SQLite, а стартовый снимок бенчмарков идёт в комплекте. Код, стенды и замеры лежат на GitHub, подробный разбор авторы опубликовали на Хабре, а агентов той же команды можно попробовать в сервисе MAS. На Hugging Face моделей и датасетов проекта нет.
Зачем нужен LLM-роутер
Разброс цен между моделями огромен. По данным авторов, в каталоге OpenRouter 428 моделей, и цена выходных токенов у них отличается в 20 тысяч раз: от $0.03 до $600 за миллион. Авторы исходят из простой идеи: пользователю важно не соотношение цены и качества, а то, хватит ли качества для его задачи. Слабый ответ всё равно придётся переделывать, и сэкономленные деньги ничего не стоят. Поэтому LLM-роутер сначала отсеивает модели, которые прогнозируемо не дотянут до нужного уровня, а среди оставшихся выбирает по цене и скорости.
Как устроен LLM-роутер FAIRouter
Библиотека состоит из двух контуров обучения. Роутер предсказывает качество до ответа, опираясь только на текст запроса. Судья измеряет качество после. Разница между прогнозом и оценкой судьи учит роутер, а разница между оценкой судьи и отзывом человека учит самого судью.
Выбор делается по метрике R = WQ·q − WC·c − Wt·t. Здесь q это прогноз качества, то есть скалярное произведение вектора признаков задачи на обучаемый вектор кандидата («на каких задачах я силён»), c это логарифм стоимости, а t логарифм ожидаемого времени. Веса задают профиль: в «качестве» на качество приходится 0.8, в «балансе» 0.5, в «цене» 0.3. Поверх метрики можно включить планку достаточности: прогноз переводится в вероятность того, что ответ понравится человеку, через калибровку σ(A·q + B), подобранную по журналу отзывов. Кандидаты ниже планки в выбор не попадают, даже если они в разы дешевле. Библиотеку можно запустить как OpenAI-совместимый сервер с одной моделью auto и подключить, например, к агенту OpenClaw.
Признаки задачи извлекает небольшая LLM одним обращением по строгой схеме: тип задачи (33 вида в 8 группах, от писем до кода), одна из 15 областей, сложность, число явных ограничений, а также заказанная форма ответа: стиль, объём, разделы, таблицы. Чтобы LLM-роутер был полезен с первого запроса, начальные веса берутся из внешних рейтингов: в комплект входят 34 серии парных предпочтений людей с Arena и 118 серий бенчмарков Artificial Analysis.
Как работает судья
Судья оценивает ответ по двум осям. Форму сверяет арифметика и небольшая модель: до 19 пунктов, которые запрос задал явно. Содержание оценивает LLM по восьми критериям: фактология, полнота по смысловым пунктам заказа, выполнение указаний, верность расчётов, экспертная глубина, наполнение таблиц, качество источников и пригодность для дела. Для фактологии ответ разбирается на атомарные утверждения (до 12), и у каждого своя вероятность истинности. Итоговая оценка берёт 0.7 содержания и 0.3 формы.
Зачем нужна вторая ось, авторы показали на контрольных парах: два ответа одной формы, но один с ошибками по сути. Данные взяты из файла docs/research/business-evaluation.md, раздел «Замер 3».
| Пара | Изъян плохого ответа | Форма: хороший / плохой | Содержание: хороший / плохой |
|---|---|---|---|
| Тарифы | выдуманные цифры, неверный расчёт | 0.73 / 0.72 | 0.93 / 0.40 |
| Исковая давность | неверные нормы ГК РФ | 0.73 / 0.71 | 0.93 / 0.24 |
| Скорость света | ложные факты и выдуманные источники | 0.71 / 0.69 | 0.81 / 0.35 |
| Перенос оплаты | нарушены указания | 0.69 / 0.74 | 0.78 / 0.59 |
В паре с письмом проверка формы даже поставила плохой ответ выше хорошего. Судья содержания при этом называет у плохих ответов от 10 до 22 конкретных расхождений с заданием, например «4×990 = 3 960 руб., а не 1 980 руб.».
Модель для судьи выбирали замером. Семь моделей проверили на текстах с заранее известным стилем, и лучшей оказалась дешёвая gpt-4o-mini: 5 из 5 по стилю за 8.2 секунды. claude-sonnet-4.5 распознал стиль хуже (4 из 5) и потратил 18.5 секунды. Требования из запроса извлекли все модели одинаково, 6 из 6, потому что точность здесь обеспечивает строгая схема ответа.
Лучше ли LLM-роутер очевидных стратегий
Сквозную проверку провели 8 сентября 2026 года на трёх кандидатах (gemini-2.5-flash, gpt-4.1-mini, claude-haiku-4.5) и восьми задачах четырёх типов, которых роутер не видел. Первый прогон роутер проиграл всем стратегиям, включая случайный выбор: он отдал все восемь задач одной модели. Оказалось, что в векторе признаков длина входа хранилась в сырых токенах, числами порядка 50-90, и занимала 100% длины вектора, так что тип задачи роутер не видел вовсе. Похожая ошибка нашлась и в цене: в долларах за запрос она имела порядок 0.0002, и её вклад в решение был в 1156 раз меньше вклада качества. После перевода на логарифмическую шкалу и стандартизации слагаемых веса заработали как переключатель (docs/research/router-eval.md, раздел «Третий прогон»):
| Стратегия | Качество | Цена, $ | Качество на цент |
|---|---|---|---|
| всегда самая дешёвая | 0.682 | 0.00053 | 12.78 |
| всегда самая дорогая | 0.687 | 0.00304 | 2.26 |
| роутер, профиль «качество» | 0.701 | 0.00227 | 3.10 |
| роутер, профиль «цена» | 0.686 | 0.00059 | 11.69 |
| идеальный выбор (задним числом) | 0.721 | 0.00174 | 4.16 |
По качеству на цент стратегия «всегда самая дешёвая» всё ещё впереди на 9%, потому что на этих задачах дешёвая модель почти не уступает дорогим. Зато роутер единственный покрывает всю шкалу от «дешевле» до «сильнее».
На 66 бизнес-задачах и четырёх моделях выяснилось, почему важна оценка содержания: лучшая по форме модель совпала с лучшей по содержанию только в 2 группах задач из 8. Если бы роутер учился на сверке формы, в большинстве групп он учился бы не у той модели.
Ограничения
Авторы честно перечисляют слабые места. Восемь задач по две на тип слишком мало, и разница в 0.02 между стратегиями лежит внутри разброса. Замер шёл на старой версии признаков и не повторялся на текущей. Обучение на живых отзывах людей ещё не проверено, и команда называет его главной следующей задачей. Судья проверяет факты без веб-поиска, а судья и один из кандидатов принадлежат одному поставщику, OpenAI. Набор из 66 задач составлен вручную, а не взят из реальных запросов.