Все статьи

Картинки и видео

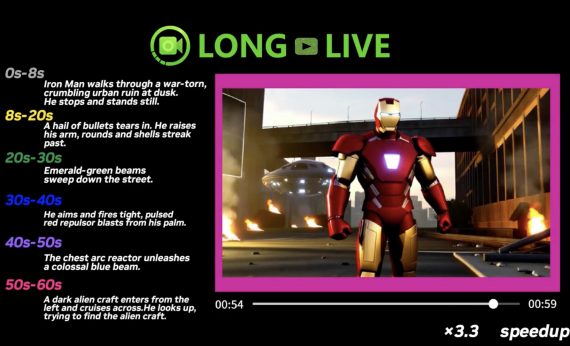
LongLive — 1.3B модель генерации видео со скоростью 20.7 FPS, позволяющая управлять сценарием в реальном времени

Команда исследователей из NVIDIA, MIT и других институтов представила LongLive — фреймворк для генерации длинных видео в реальном времени, которые позволяет управлять сюжетом по ходу создания ролика. В отличие от…
Картинки и видео

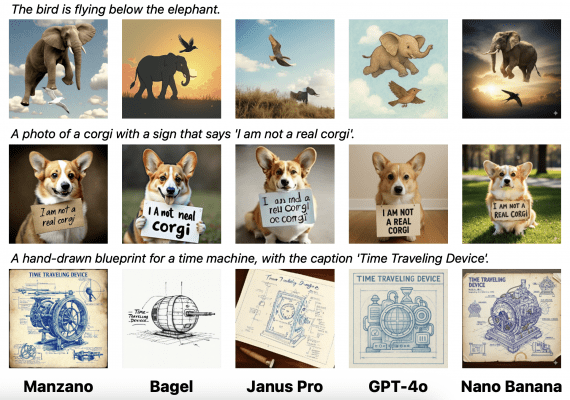
Гибридный токенизатор изображений: новый подход Apple к созданию мультимодальных моделей

Команда исследователей Apple представила Manzano — унифицированную мультимодальную большую языковую модель, которая объединяет возможности понимания и генерации визуального контента через гибридный токенизатор изображений и тщательно подобранную стратегию обучения. Авторегрессивная модель…
Открытые LLM

WebWeaver — открытый фреймворк для глубоких исследований преводсходит OpenAI DeepResearch, Gemini Deep Research на бенчмарках

Исследователи из Tongyi Lab (Alibaba Group) представили WebWeaver — открытый двухагентный фреймворк для глубоких исследований, который симулирует человеческий исследовательский процесс. Фреймворк состоит из планировщика, который итеративно чередует веб-поиск источников и…

Искусственный интеллект в ставках на спорт: как технологии меняют прогнозы и рынок

Искусственный интеллект меняет мир спортивных ставок, повышая точность прогнозов и предлагая индивидуальные рекомендации. Современные технологии позволяют анализировать большие данные в реальном времени, делают ставки более эффективными для пользователей. Введение Использование…
Открытые LLM

Mini-o3: открытая мультимодальная 7B-модель превзошла GPT-4o в визуальном поиске благодаря 30-шаговым цепочкам рассуждений

Исследователи из ByteDance и Университета Гонконга представили Mini-o3 — мультимодальную модель, которая выполняет глубокие многошаговые рассуждения для решения сложных задач визуального поиска. Mini-o3 достигает SOTA результатов на сложных бенчмарках, превосходя…
Картинки и видео

Google представила Gemini 2.5 Flash Image aka Nano Banana — новую модель генерации изображений

Google представила Gemini 2.5 Flash Image (с внутренним кодовым названием nano-banana) — модель для генерации и редактирования изображений. Модель поддерживает комбинирование нескольких изображений в одно, сохраняет консистентность персонажей между генерациями,…
Приложения

Реставрация старых фото онлайн: топ-8 нейросетей

В жизни часто возникают ситуации, когда необходимо освежить старые фото: улучшить четкость, удалить царапины, желтизну и прочие следы времени. Самый легкий путь – это реставрация старых фото онлайн, то есть…
Новости

RRNCB — первый российский открытый бенчмарк для оценки RAG-моделей

RRNCB (Russian RAG Normative — Corporate Benchmark) — первый российский открытый бенчмарк для комплексной оценки RAG-моделей при работе с нормативной, правовой и технической документацией компаний. RRNCB адаптирован под специфику русскоязычных…
Открытые LLM

Nemotron Nano 2 9B: модель от NVIDIA обходит Qwen3-8B на бенчмарках, работает в 6 раз быстрее и поддерживает контекст 128k

Команда исследователей NVIDIA представила Nemotron-Nano-9B-v2 — гибридную Mamba-Transformer языковую модель, которая выдает ответы в 6 раз быстрее Qwen-3-8B на задачах рассуждения, превосходя ее в точности. Модель с 9 миллиардами параметров…
Модели мира

Matrix-3D: открытый фреймворк для генерации всенаправленных исследуемых 3D-миров из одного изображения

Исследователи из Skywork AI, Гонконгского университета науки и технологий представили Matrix-3D — фреймворк для создания полностью исследуемых трехмерных миров из одного изображения или текстового описания. Matrix-3D решает проблему ограниченного поля…
Модели мира

3D-R1: открытая модель с рассуждениями для 3D-сцен превосходит современные методы на 10% на 3D-бенчмарках

Исследователи из Шанхайского университета инженерных наук и Пекинского университета представили 3D-R1 — новую foundation-модель, которая значительно улучшает способности к рассуждению в трёхмерных vision-language моделях (VLM).  Модель демонстрирует среднее улучшение производительности…
ИИ-агенты

Seed Diffusion: новый state-of-the-art в балансе скорость-качество для моделей генерации кода

Команда исследователей ByteDance Seed совместно с Институтом AIR Университета Цинхуа представила Seed Diffusion Preview — языковую модель на основе дискретной диффузии, демонстрирующую рекордную скорость инференса. Модель достигает 2,146 токенов в…

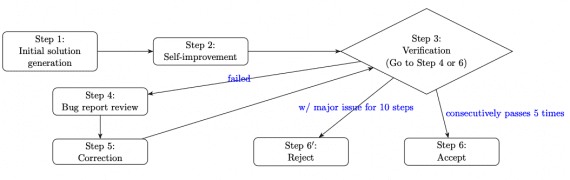
Gemini 2.5 Pro показала уровень золотого медалиста на Международной математической олимпиаде IMO 2025, решив 5 из 6 задач

Большие языковые модели хорошо справляются с математическими бенчмарками вроде AIME, однако задачи Международной математической олимпиады (IMO) требуют глубокого понимания, креативности и формального рассуждения. Китайские исследователи использовали Google Gemini 2.5 Pro…

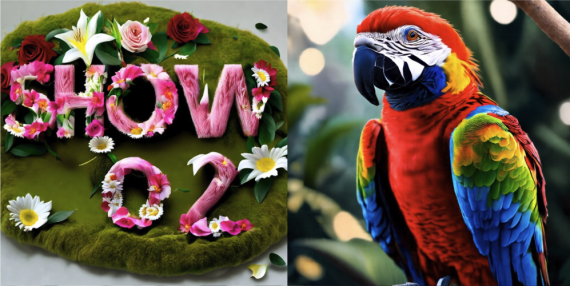
Show-o2: открытая мультимодальная 7B модель обходит 14B-модели на бенчмарках, используя в разы меньше данных для обучения

Исследователи из Show Lab Национального университета Сингапура и ByteDance представили Show-o2 — второе поколение мультимодальной модели, которая демонстрирует превосходные результаты в задачах понимания и генерации изображений и видео. Show-o2 использует…
Открытые LLM

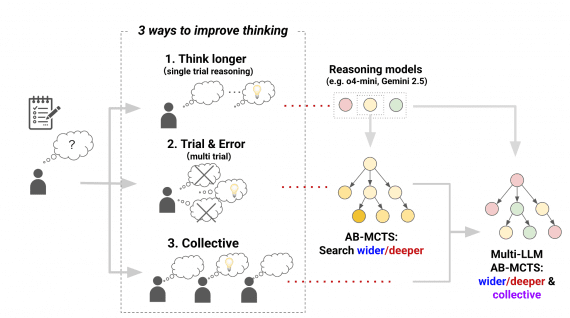
Фреймворк TreeQuest: адаптивные команды LLM превосходят отдельные модели на 30%

Исследователи из Sakana AI представили Adaptive Branching Monte Carlo Tree Search (AB-MCTS) — революционный подход к созданию «команд мечты» из больших языковых моделей, который позволяет им динамически сотрудничать для решения…
Открытые LLM

MiniCPM4: открытая локальная модель достигает производительности Qwen3-8B при 7-кратном ускорении инференса

Команда исследователей OpenBMB представила MiniCPM4 — высокоэффективную языковую модель, разработанную специально для локальных устройств. MiniCPM4-8B достигает сопоставимой с Qwen3-8B производительности (81.13 против 80.55), при этом для обучения требуется в 4.5…
Открытые LLM

Строгое on-policy обучение с оптимальным бейзлайном: Microsoft представила упрощенный алгоритм для RLHF

Исследовательская команда Microsoft Research представила On-Policy RL with Optimal reward baseline (OPO) — упрощенный алгоритм обучения с подкреплением для выравнивания больших языковых моделей. Новый метод решает ключевые проблемы современных RLHF…
State-of-the-art

NVIDIA Canary достигла 90% точности предсказания временных меток в синхронном переводе

Исследовательская команда NVIDIA представила подход для генерации временных меток на уровне слов в модели синхронного перевода Canary. Точная информация о времени критически важна для создания синхронизированных субтитров. Исследователи опубликовали код…
ИИ-агенты

Mistral Agents API: фреймворк для создания AI-агентов с веб-поиском, генерирующих код и изображения

Французский стартап Mistral AI представил Agents API — фреймворк для создания автономных AI-агентов со встроенными коннекторами, постоянной памятью и возможностями оркестрации. Разработчики могут создавать неограниченнное число агентов и выстраивать пайплайны…
ИИ-агенты

Visual-ARFT: новый метод обучения AI-агентов обходит GPT-4o в мультимодальных задачах

Исследовательская группа из Шанхайского университета Цзяо Тонг и Шанхайской лаборатории искусственного интеллекта представила Visual Agentic Reinforcement Fine-Tuning (Visual-ARFT) — новый подход к обучению крупных мультимодальных моделей агентным возможностям. Методика демонстрирует…