Открытые LLM

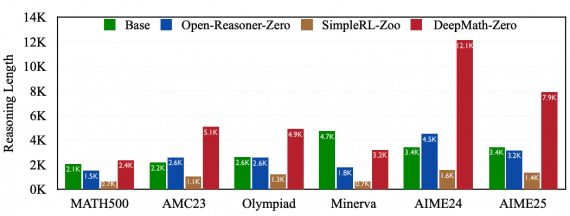
DeepMath-103K: датасет для обучения с подкреплением моделей рассуждения от Tencent

Исследователи из Tencent и Шанхайского университета Цзяо Тонг опубликовали DeepMath-103K — крупный математический датасет, созданный для разработки продвинутых моделей рассуждения с помощью обучения с подкреплением. Создание набора данных стоило исследователям…
Новости

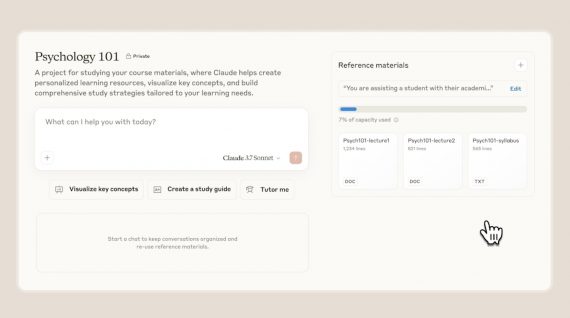
Anthropic представил образовательную версию Claude для внедрения в университетах и колледжах

Anthropic выпустил версию Claude для образования, разработанную специально для внедрения в университеты и другие высшие учебные заведения. В то время как классический чат-бот выдает прямые ответы на вопросы, Claude for…
Открытые LLM

Llama Nemotron: семейство открытых моделей от Nvidia обходит DeepSeek R1 в рассуждении и математике

NVIDIA анонсировала семейство открытых моделей Llama Nemotron с продвинутыми возможностями в задачах рассуждения. Дообучение моделей Llama 3.3 и 3.1 позволило Nvidia улучшить их точность на 20% при достижении в 5…
Архитектуры

На каком языке «мыслят» большие языковые модели

Новое исследование EPFL проливает свет на внутренние механизмы обработки многоязычных данных в LLM, что критично для понимания принципов работы современных языковых моделей и их оптимизации. Исследователи применили метод Logit lens…
Картинки и видео

Токенизатор TA-TiTok от Bydedance обновил бенчмарки в генерации изображений при обучении на открытых данных

ByteDance и POSTECH представили токенизатор TA-TiTok (Text-Aware Transformer-based 1-Dimensional Tokenizer), новый подход к созданию доступных и эффективных text-to-image моделей. Маскированная генеративная модель MaskGen с токенизотором TA-TiTok достигла SOTA для text-to-image…
State-of-the-art

SmolLM2: открытая компактная LLM от Hugging Face превосходит Llama-1B и Qwen2.5-1.5B

Компания Hugging Face представила SmolLM2 — новое семейство компактных языковых моделей, которое преводсходит существующие state-of-the-art модели. Так версия с 1.7B параметров опережает Llama-1B и Qwen2.5-1.5B на нескольких ключевых бенчмарках: 68.7%…
State-of-the-art

EzAudio: гиперреалистичная открытая Text-to-Audio модель

EzAudio — новая диффузная модель генерации аудио на основе текста (T2A), разработанная исследователями из Tencent AI Lab и Университета Джонса Хопкинса. В основе модели — архитектура диффузионного трансформера для обработки…
Базовый курс

DeeplearningAI выпустил бесплатный курс «Мультимодальный RAG: Общение с видео»

DeeplearningAI выпустил бесплатный видеокурс «Multimodal RAG: Chat with Video«. На курсе инженер Intel Labs Васудев Лал рассказывает, как создавать нейросети для поиска и анализа видеоконтента с использованием мультимодальных моделей. Основной…
State-of-the-art

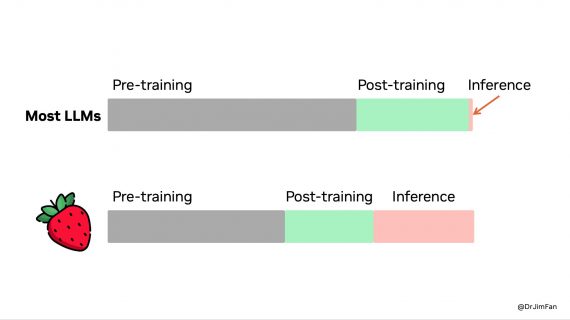
OpenAI выпустила семейство моделей o1 с продвинутой логикой в решении сложных задач

OpenAI представила новое семейство моделей o1, следующее поколение моделей GPT. Модели o1 — в частности, o1-preview и o1-mini — разработаны для выполнения более сложных логических задач, чем их предшественники, и…
State-of-the-art

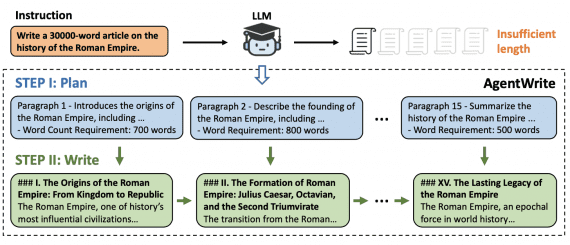
LongWriter — открытый фреймворк и набор LLM для генерации текстов длиной до 20000 слов

LongWriter — открытый фреймворк и набор больших языковых моделей (LLMs) для генерации связных и релевантных ответов, превышающих 10 000 слов. Longwriter использует пайплайн AgentWrite, который разбивает задачу генерации длинных текстов…
State-of-the-art

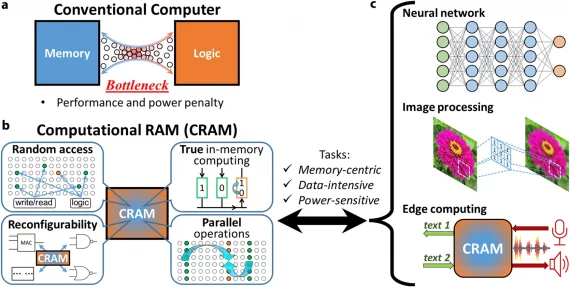
CRAM: новая аппаратная архитектура снижает энергопотребление ИИ в 1000 раз

Исследователи из Университета Миннесоты Твин-Ситис представили архитектуру аппаратного обеспечения Computational Random-Access Memory (CRAM), которая призвана трансформировать вычисления в области ИИ, резко сократив энергопотребление. CRAM способен сократить использование энергии ИИ в…
State-of-the-art

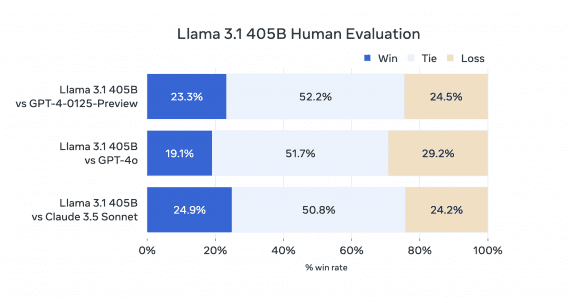
Состоялся релиз LLaMA 3.1: открытая модель превосходит GPT-4o и Claude Sonnet 3.5 на бенчмарках

Модели LLaMA 3.1 официально выпущены, включая самую большую открытую модель с 405 миллиардами параметрами, модели 70B и 8B и мультимодальную модель. Контекст расширен до 128K токенов, поддерживается восемь языков, а…
Приложения

Как ИИ помог студии King разработать 13755 уровней для игры Candy Crush Saga

Компания King, разработчик известной мобильной игры Candy Crush Saga, активно внедряет искусственный интеллект в процесс разработки и оптимизации игры. В недавнем интервью Сахар Асади (Sahar Asadi) из AI Labs Activision…
State-of-the-art

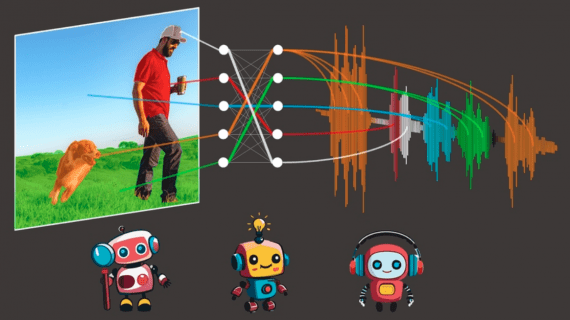
Модель обучили понимать язык с помощью видеозаписей

Разработанный в MIT алгоритм DenseAV обучается понимать значение слов и предложений, просматривая видео с разговорами людей. DenseAV превзошел другие алгоритмы в задачах идентификации объектов по их названию. Исследователи решили задачу…
Приложения

GPT-4 обучили прогнозировать финансовые показатели лучше аналитиков

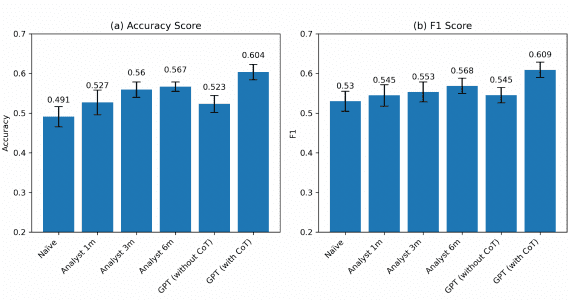
Ученые из Чикагского университета продемонстрировали, что большие языковые модели могут проводить анализ финансовой отчетности компаний с точностью, превосходящей точность профессиональных аналитиков. Выводы исследования могут иметь последствия для развития отрасли финансового…
Приложения

Модель NVIDIA DrEureka обучает роботов быстрее, чем люди

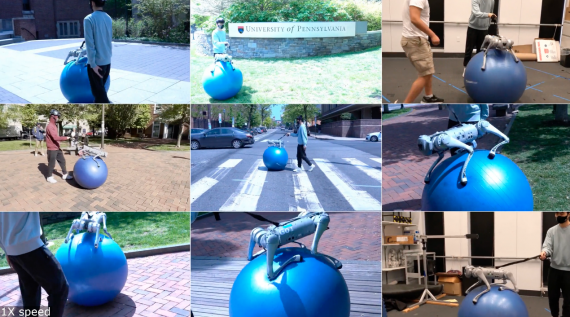
NVIDIA продемонстрировала, что большие языковые модели могут ускорить обучение роботов. Роботы с четырьмя конечностями, обученные с помощью модели DrEureka, превосходят стандартные системы обучения на 34% по скорости движения робота в…
Датасеты

Google Gecko: бенчмарк для text-to-image моделей

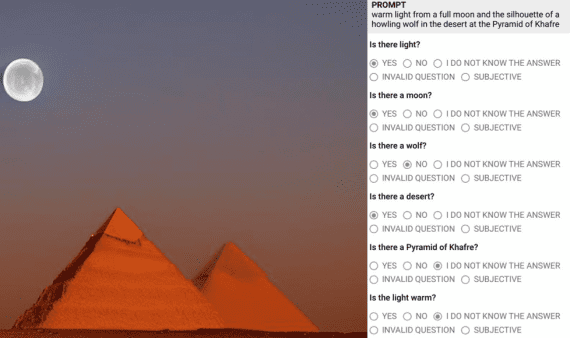
Google DeepMind разработала Gecko – бенчмарк, обеспечивающий более точное и надежное тестирование и сравнение text-to-image моделей, чем существующие подходы. Исследование Google DeepMind выявило скрытые ограничения в том, как в настоящее…
Датасеты

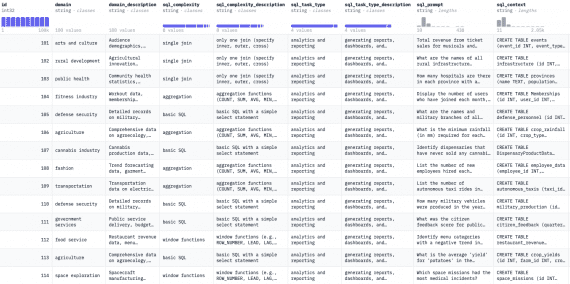
Gretel: крупнейший открытый Text-to-SQL датасет

Стартап Gretel, специализирующийся на генерации высококачественных синтетических данных, объявил о создании крупнейшего открытого text-to-SQL датасета, нацеленного на ускорение развития no-code инструментов аналитики. Датасет содержит более 100 000 корректных синтетических образцов…
Приложения

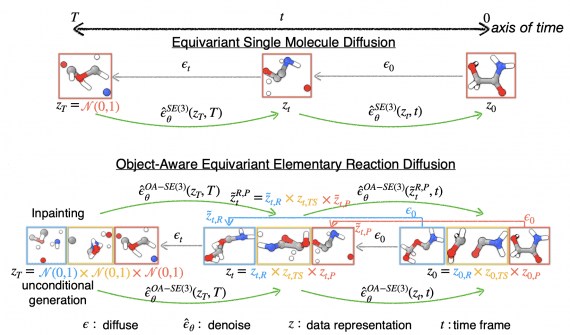
Диффузионную модель обучили прогнозировать химические реакции

Ученые MIT разработали модель, прогнозирующую вероятность достижения молекулой переходного состояния – состояния, определяющего вероятность протекания химической реакции. Модель будет использоваться в исследованиях реакций и катализаторов для разработки новых видов топлива…

MIT публикует бесплатный курс лекций TinyML & Efficient DL Computing на Youtube

В последние годы большие языковые и диффузные модели продемонстрировали впечатляющие результаты, но их требовательность к вычислительным ресурсам и потребление памяти ставит перед исследователями и разработчиками серьезные вызовы. Курс TinyML &…