Все статьи

State-of-the-art

VideoPoet: языковая модель Google для генерации и редактирования видео

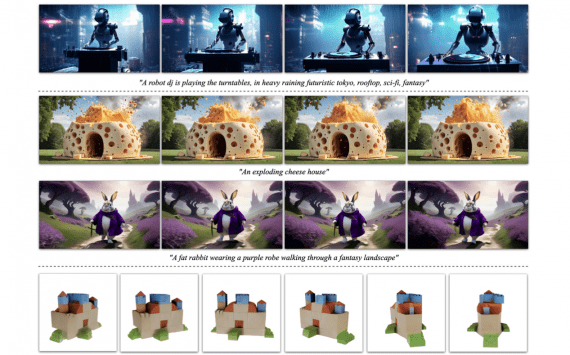
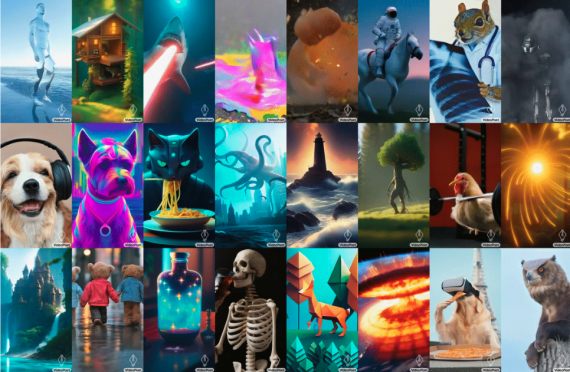
Google представила VideoPoet – языковую модель для мультимодальной работы с видеоконтентом, способную преобразовывать текст и изображение в ролики, стилизовать существующие видео и генерировать аудиодорожки к ним без подсказок. VideoPoet обучает…
Новости

Google MusicFX: создание музыки по текстовому запросу

Google запустил MusicFX – онлайн-сервис для генерации музыки по текстовому запросу. В продукте используется модель Google MusicLM, а каждый аудиофайл содержит незаметный для слушателя водяной знак, сгенерированный с помощью DeepMind…
Приложения

FractalGPT запустил агента вопросно-ответной системы для общения с загруженными документами

Разработчики FractalGPT запустили QA-агента FractalGPT для работы с документами, который позволяет использовать в диалогах загруженные пользователями PDF, TXT и DOCX файлы. Ключевые особенности FractalGPT QA: Обработка документов любой длины, без типичного…
Приложения

Shopping Muse: рекомендательная система Mastercard

Mastercard представила Shopping Muse – модуль для интернет-магазинов в формате чат-бота, рекомендующий покупателю товары на основе его истории покупок и поиска, региона и других признаков. Shopping Muse работает на базе…
State-of-the-art

Нейросеть DeepMind GNoME открыла 2 миллиона новых материалов

DeepMind разработала графовую нейросеть GNoME, прогнозирующую стабильность материалов. GNoME обнаружила 2,2 миллиона новых материалов, 380 тысяч из которых являются стабильными и могут быть применены для разработки компьютерных чипов, аккумуляторов и…
State-of-the-art

Stable Video Diffusion: генератор видео по изображению от Stability AI

Компания Stability AI объявила о выпуске Stable Video Diffusion – набора из двух моделей, генерирующих видео продолжительностью до 4 секунд по входному изображению. Обе модели опубликованы в открытом доступе. Модели…
State-of-the-art

LCM-LoRA: генерация изображений в реальном времени

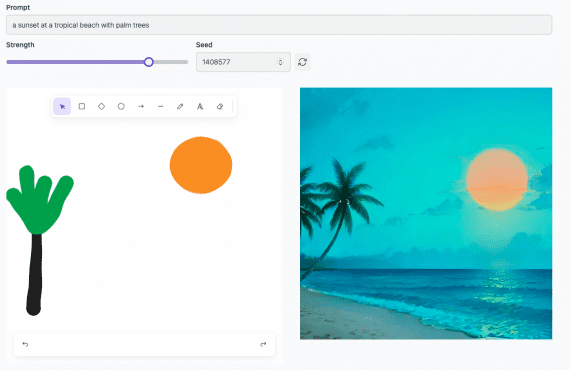
Исследователи Университета Цинхуа разработали алгоритм LCM-LoRA, позволяющий в реальном времени генерировать изображения по текстовому описанию или наброску. Наиболее популярным text-to-image моделям, таким как Stable Diffusion, Midjourney и DALLE-3, требуется от…
Новости

Microsoft LeMa: обучение языковых моделей на их ошибках

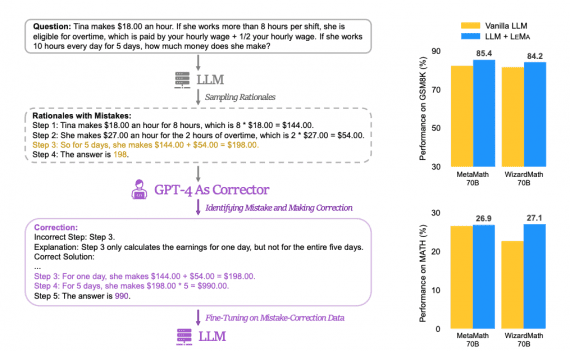
Исследователи Microsoft представили LeMa (Learning from Mistakes) – алгоритм с открытым исходным кодом для улучшения способности больших языковых моделей решать математические задачи. LeMa заставляет модель учиться на своих ошибках, имитируя…
Новости

В Shutterstock добавили редактирование изображений на основе DALL-E 2

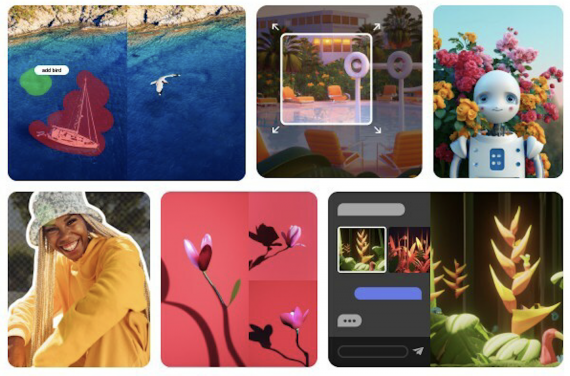
В хранилище стоковых изображений Shutterstock добавили возможность обработки изображений перед скачиванием c помощью текстовых запросов. Новые функции работают на основе OpenAI DALL-E 2 и позволяют менять угол обзора сцены, заменять…
Новости

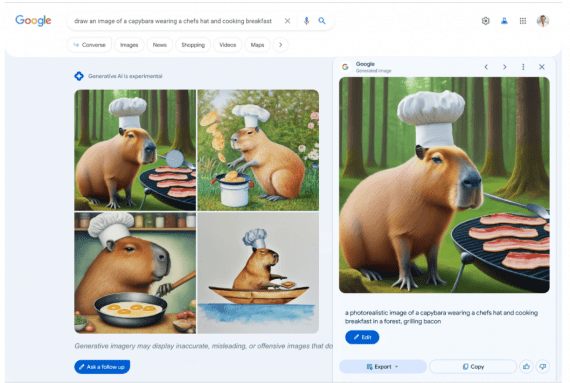
Google добавила в поиск генерацию изображений

Google объявила о внедрении в поиск генерации изображений по описанию и ряда других AI-функций. Инструмент основан на модели Imagen и позволяет несколько раз уточнять запрос для получения требуемого результата. На…
Приложения

Adobe Firefly 2 объединила модели генерации изображений и переноса стиля

Adobe представила бета-версию модели для генерации изображений Firefly 2, соединяющую в себе функции text-to-image и style transfer. Инструмент Generative Match в Firefly 2 позволяет сочетать текстовые запросы с референсным изображением,…
ИИ-агенты

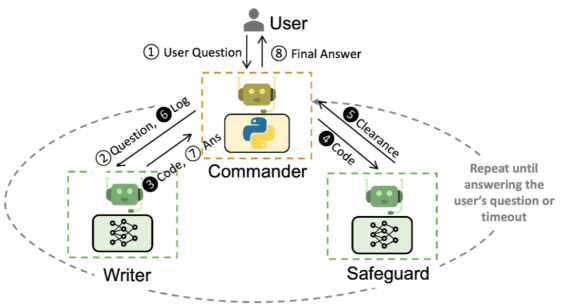
Microsoft AutoGen: фреймворк для настройки LLM-агентов

Microsoft представила AutoGen, open-source библиотеку для создания и настройки LLM-агентов – отдельных сеансов больших языковых моделей, которые могут взаимодействовать друг с другом для совместного решения задач. LLM-агенты – перспективная область…
Новости

Microsoft Copilot и другие 150 AI-функций Windows 11

Microsoft выпустила обновление Windows 11, включающее более 150 AI-функций и чат-бота Copilot, поддерживающего большинство приложений операционной системы. Copilot является единой точкой входа для взаимодействия с приложениями и контентом с помощью…

MIT публикует бесплатный курс лекций TinyML & Efficient DL Computing на Youtube

В последние годы большие языковые и диффузные модели продемонстрировали впечатляющие результаты, но их требовательность к вычислительным ресурсам и потребление памяти ставит перед исследователями и разработчиками серьезные вызовы. Курс TinyML &…
Новости

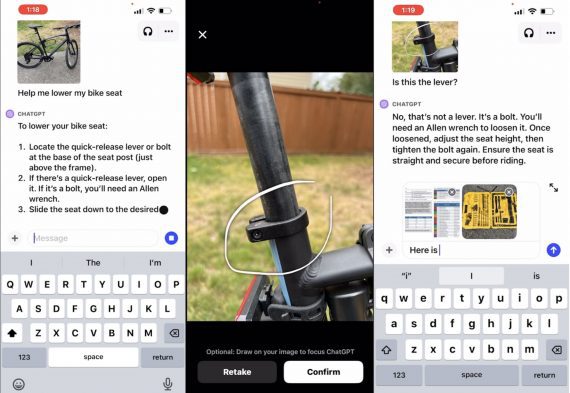
ChatGPT научился вести диалог голосом и распознавать объекты на изображениях

В ChatGPT внедрили функции общения голосом и распознавания объектов на изображении для углубленного погружения в задачу. Например, ChatGPT готов будет прочитать сказку на ночь, поможет справится с составлением рецепта по…
State-of-the-art

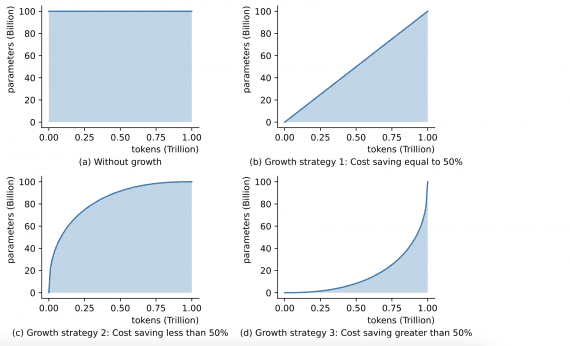
FLM-101B: языковую модель со 101 миллиардом параметров обучили с нуля «всего» за $100 000

Исследователи из Пекинского университета представили FLM-101B — открытую большую языковую модель с 101 миллиардом параметров, обученную с нуля на 300 миллиардах токенов при затратах «всего лишь» $100 000. Обучение таких…