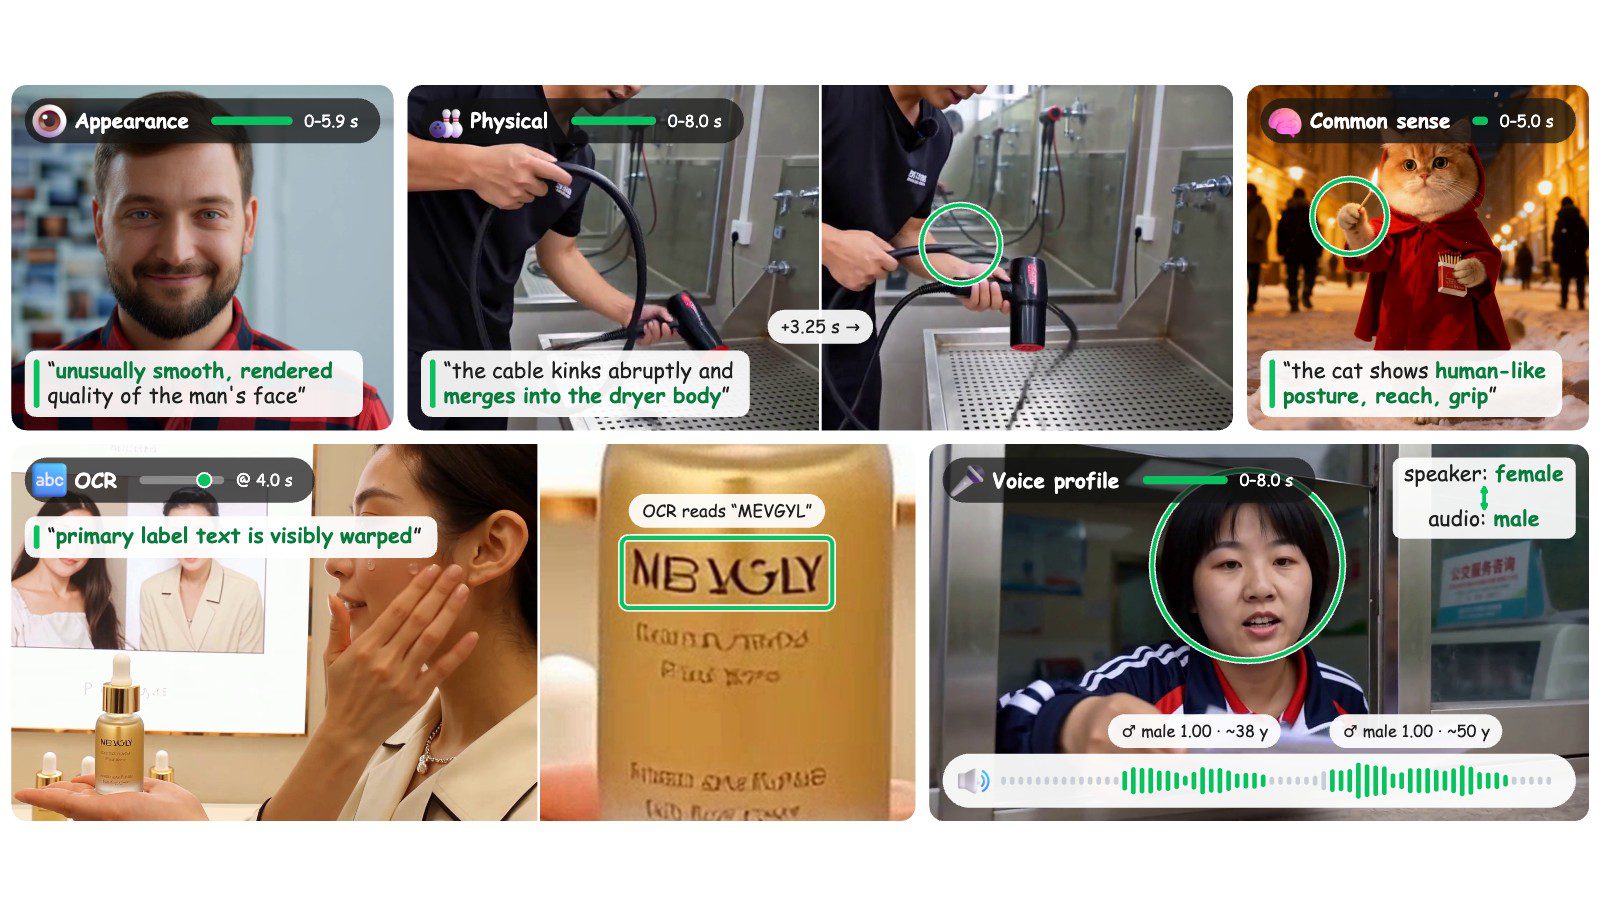
Исследователи WeChat Vision и Nanjing University представили WeVisForensics — ИИ-агента, который распознаёт сгенерированные видео. Главный агент решает, кого из шести экспертов позвать (по внешнему виду, физике, здравому смыслу, тексту, голосу и речи), какой отрезок им показать и когда данных достаточно для вердикта. Эксперты отвечают отчётами с таймкодами, и решение можно проверить по кадрам. В отличие от прошлых агентных детекторов, визуальные эксперты тоже дообучаются на запросах главного агента. Агент на базе Qwen3.5-4B набирает в среднем 95.2% на четырёх бенчмарках, на 9 пунктов больше прошлого лидера VideoVeritas. На новом бенчмарке AgenticCue с роликами Sora 2, Veo 3.1 и Kling 3.0 агент получает 97-98.8% на всех пяти категориях артефактов, а VideoVeritas на звуке 69.3%. Код инференса, демо и LoRA-адаптеры открыты под Apache 2.0, агенту хватает видеокарты с 24 ГБ. Датасет ForenCue-30K и код обучения не опубликованы, AgenticCue обещают выложить позже. Код лежит на GitHub, веса на Hugging Face, примеры на странице проекта.
Как агент отличает сгенерированные видео от настоящих
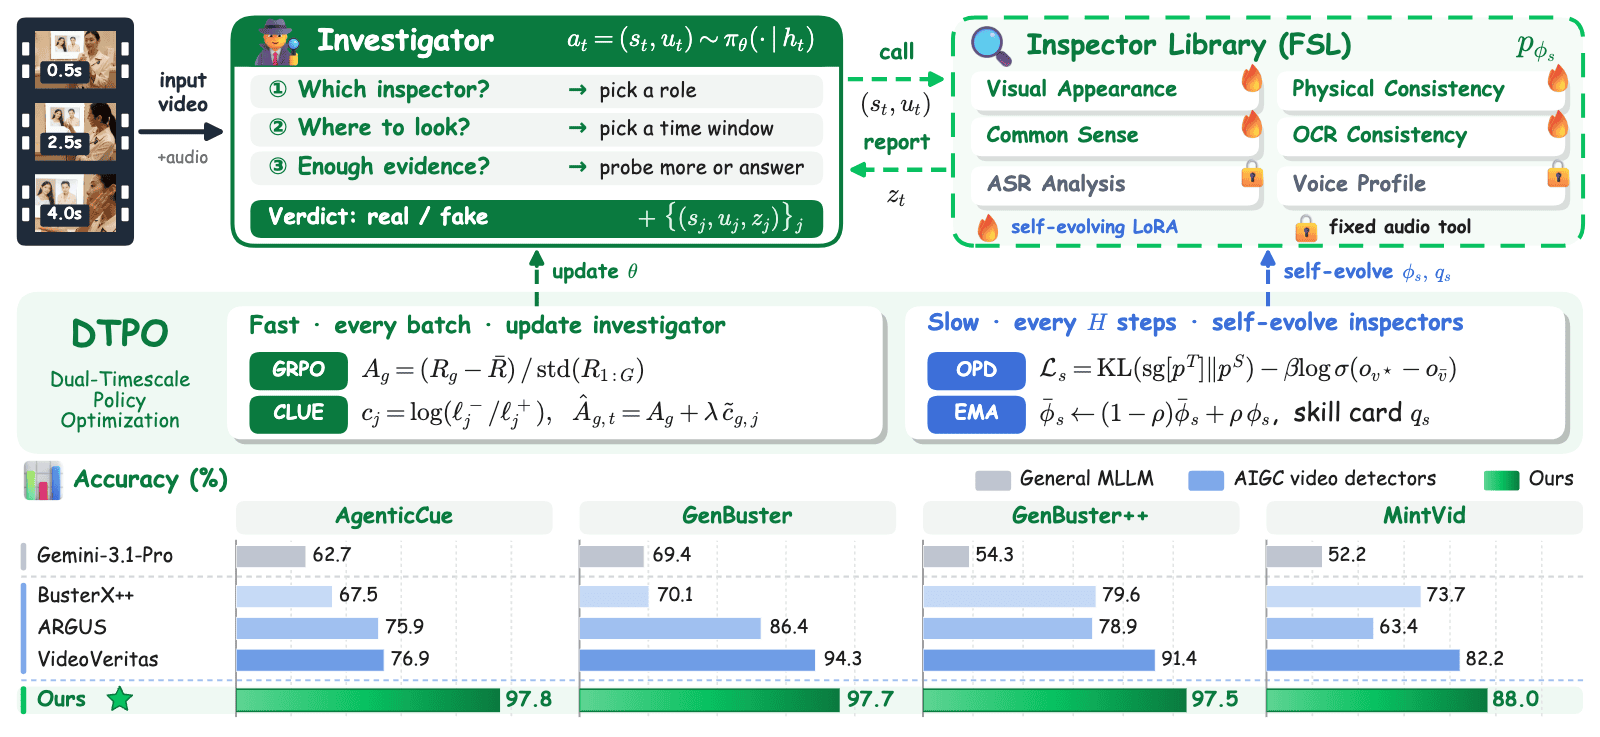
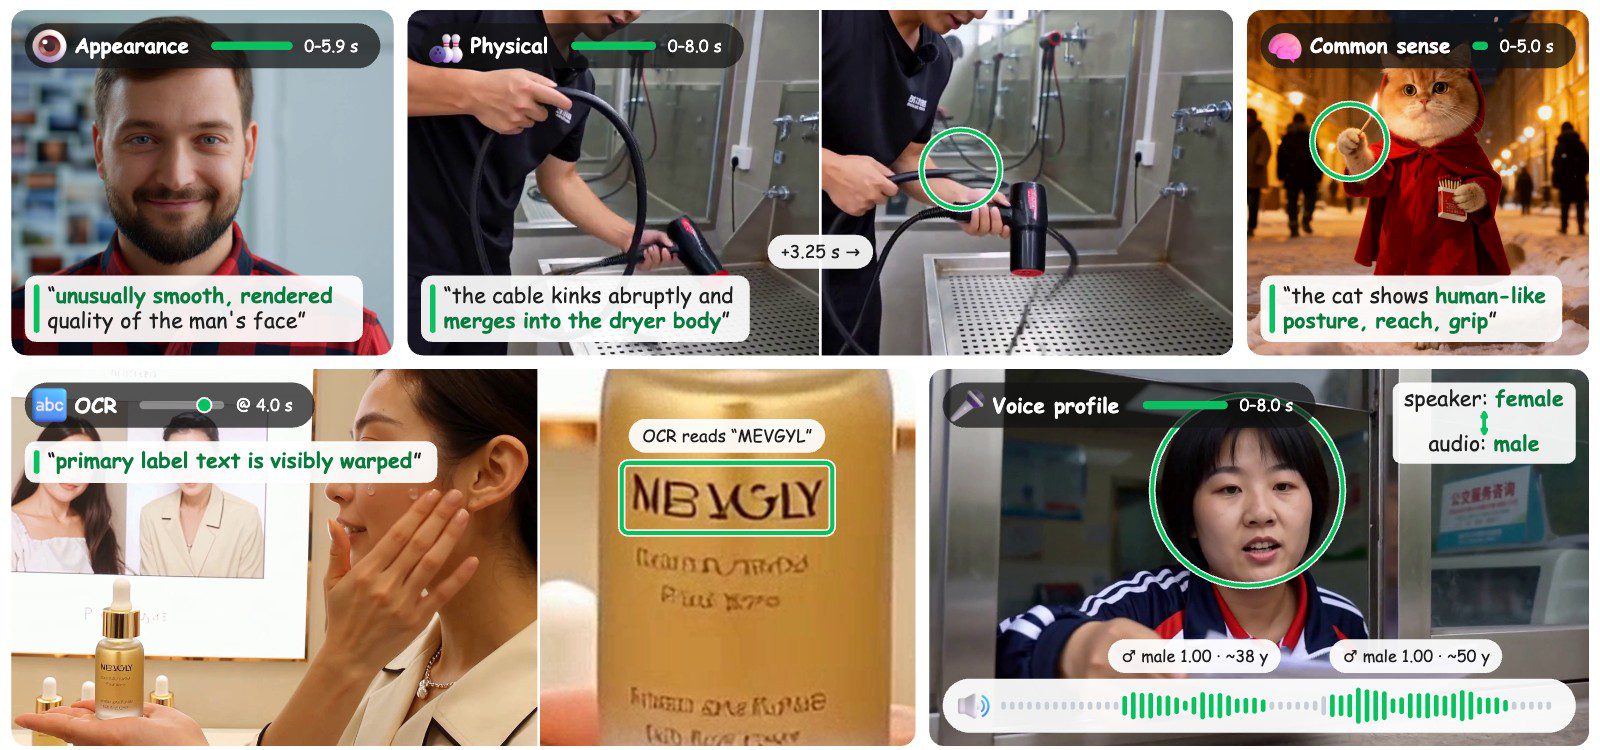
Сначала главный агент бегло просматривает ролик. Ему показывают до 16 кадров, взятых равномерно по всему видео, и сообщают, сколько оно длится и есть ли в нём звук На каждом шаге он пишет рассуждение и либо вызывает эксперта, либо выносит вердикт. Вызовов не больше четырёх на шесть экспертов, повторять их нельзя. Четыре визуальных эксперта работают на той же Qwen3.5-4B, что и главный агент, но со своими LoRA-адаптерами:
- Внешний вид: текстура при движении, волосы, пальцы, зубы, свет, тени и отражения;
- Физика: движение тел, форма предметов, касания объектов, жидкости, исчезновение объектов за препятствием;
- Здравый смысл: причины и следствия, порядок событий и нереалистичные сцены вроде кошки за рулём;
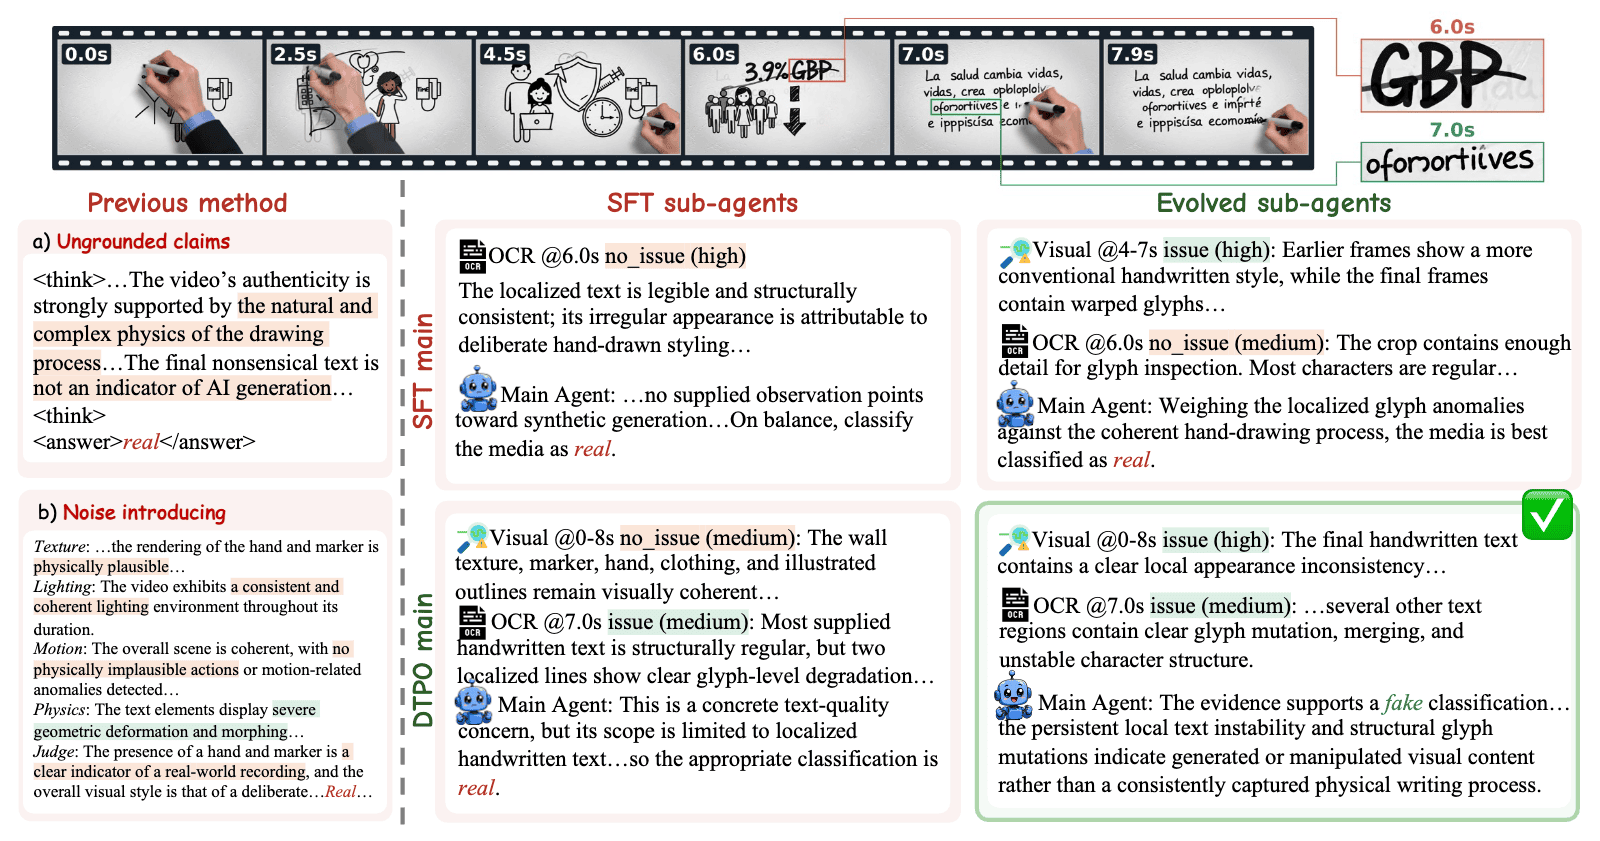
- Текст в кадре: PaddleOCR находит надписи, а эксперт ищет слипшиеся и сломанные буквы на увеличенных фрагментах;
- Голос и речь: два необучаемых инструмента оценивают пол и возраст говорящего и ищут в расшифровке неестественно ровный темп речи.
Первые три эксперта смотрят выбранное окно по 2 кадра в секунду и отвечают вердиктом (артефакт есть, нет или определить нельзя), уверенностью и объяснением со ссылками на секунды. Смазывание при движении, сжатие и стилизацию эксперты признаками генерации не считают.
Почему экспертов тоже нужно обучать
Детекторы с цепочкой рассуждений (chain-of-thought) смотрят видео целиком за один проход и пропускают артефакты, которые видны недолго или занимают малую часть кадра. Агентные детекторы вроде ARGUS обучают только оркестратор поверх замороженных экспертов, но если эксперт не видит артефакт, никакая маршрутизация это не исправит. Обновлять обе стороны на каждом батче тоже плохо: главный агент решает, что увидят эксперты, а их ответы меняют его решения, и каждый становится движущейся мишенью для другого.
DTPO: быстрое и медленное обучение
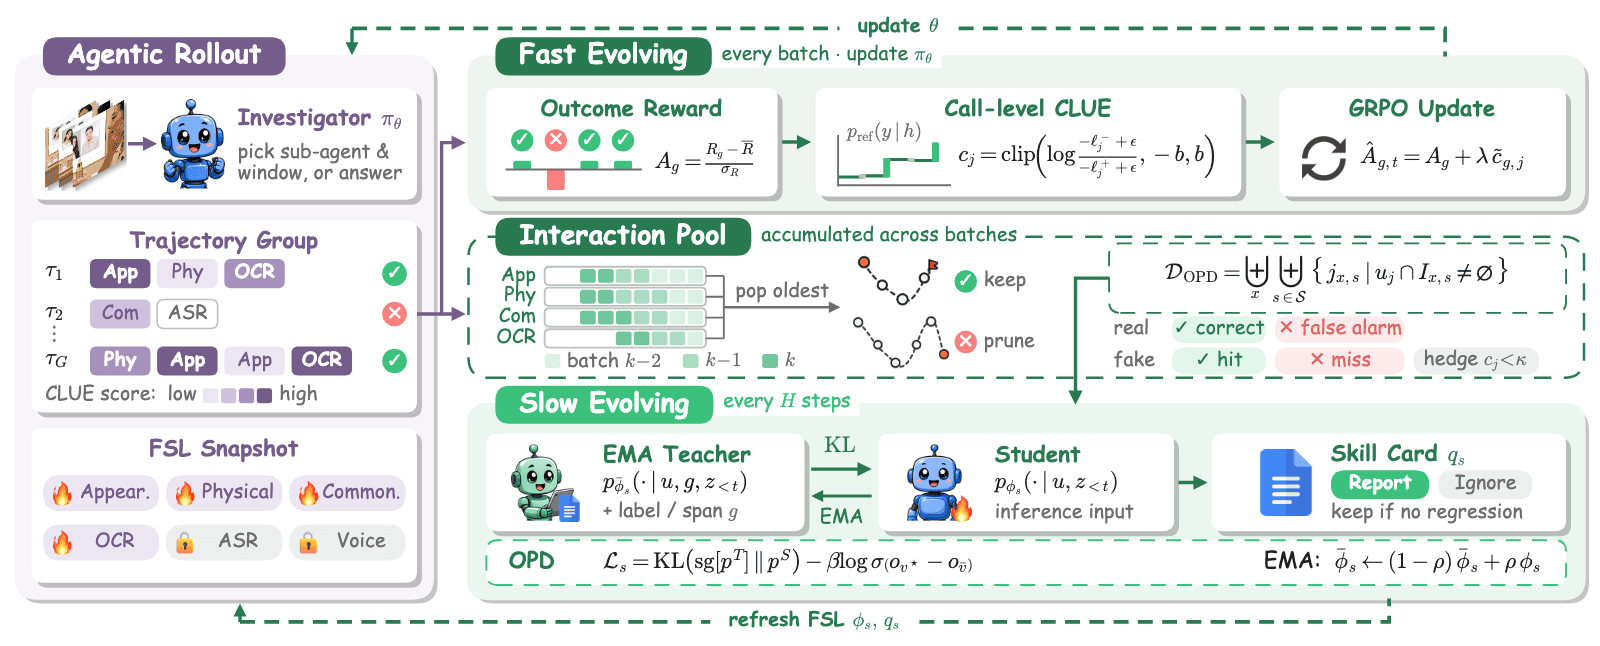
После supervised fine-tuning (SFT) на ForenCue-30K агента и экспертов обучают вместе методом DTPO (Dual-Timescale Policy Optimization):
- Быстрый процесс. Главного агента обновляют на каждом батче через GRPO с наградой за верный вердикт без нарушений протокола. Дополнительно CLUE оценивает каждый вызов: замороженная Qwen3.5-4B проверяет, насколько после отчёта эксперта выросла вероятность правильного ответа;
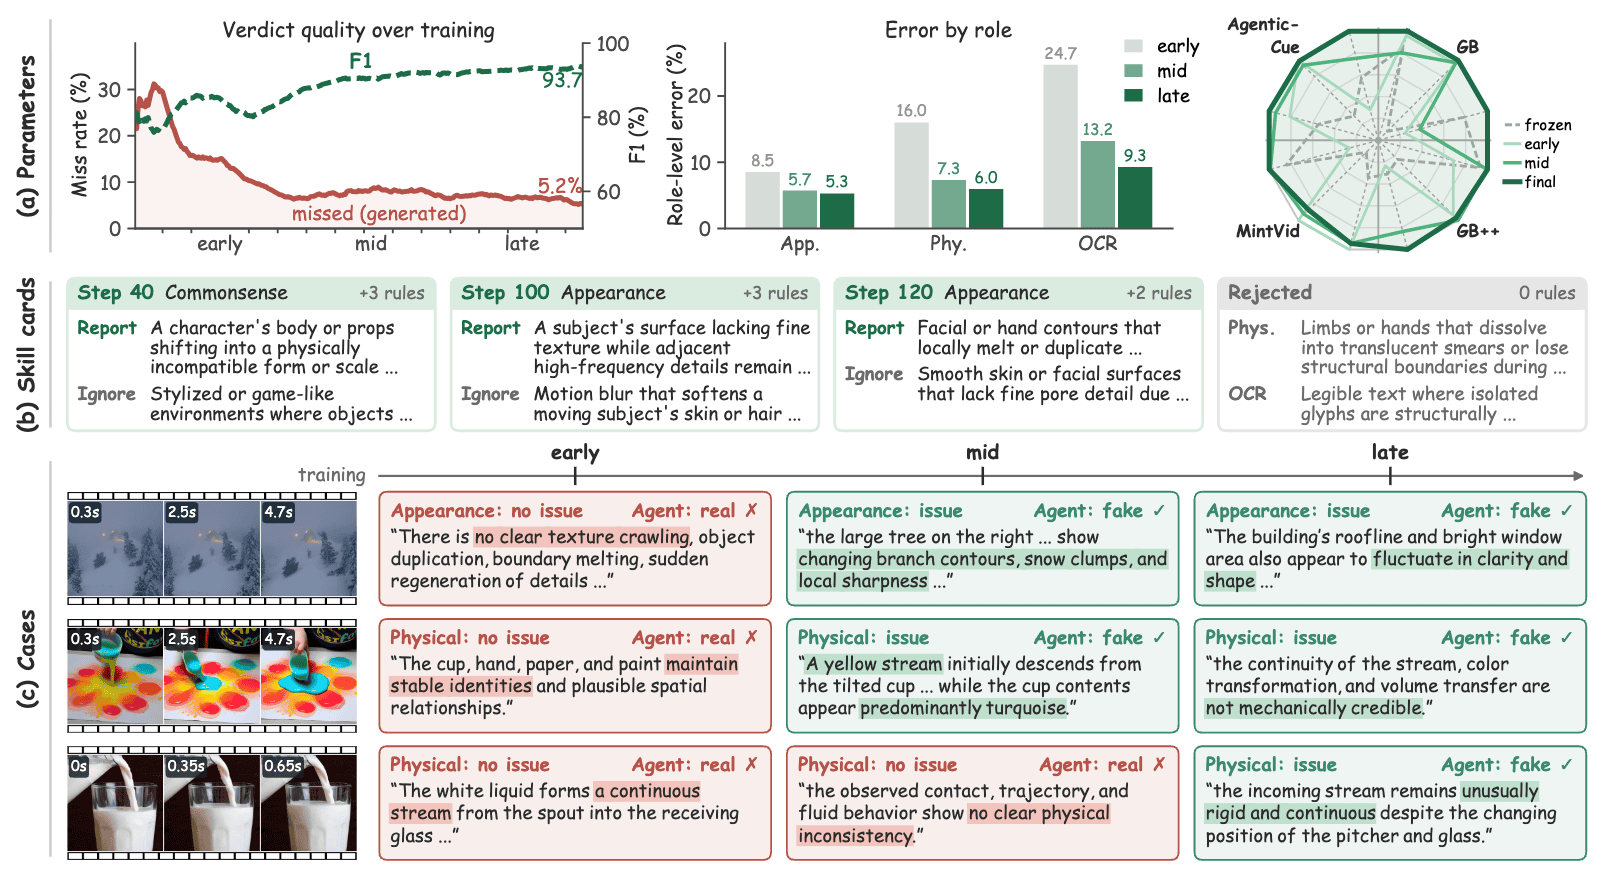
- Медленный процесс. Раз в 20 шагов экспертов дообучают на накопленных вызовах, окно которых пересекается с размеченным артефактом. Учитель, медленно обновляемая копия эксперта, видит кадры, метку и интервалы артефактов, а ученик только кадры и подтягивает свои ответы к ответам учителя (дистилляция с привилегированной информацией);
- Карточки навыков (skill cards). Замороженная LLM разбирает ошибки эксперта и предлагает правила «сообщать» или «игнорировать», например не считать дефектом волосы, смазанные при быстром движении. Правило принимают, только если верных вердиктов становится больше и ни один прежний верный вердикт не ломается.
Совместное обучение занимает около суток на кластере авторов.
Датасет ForenCue-30K и бенчмарк AgenticCue
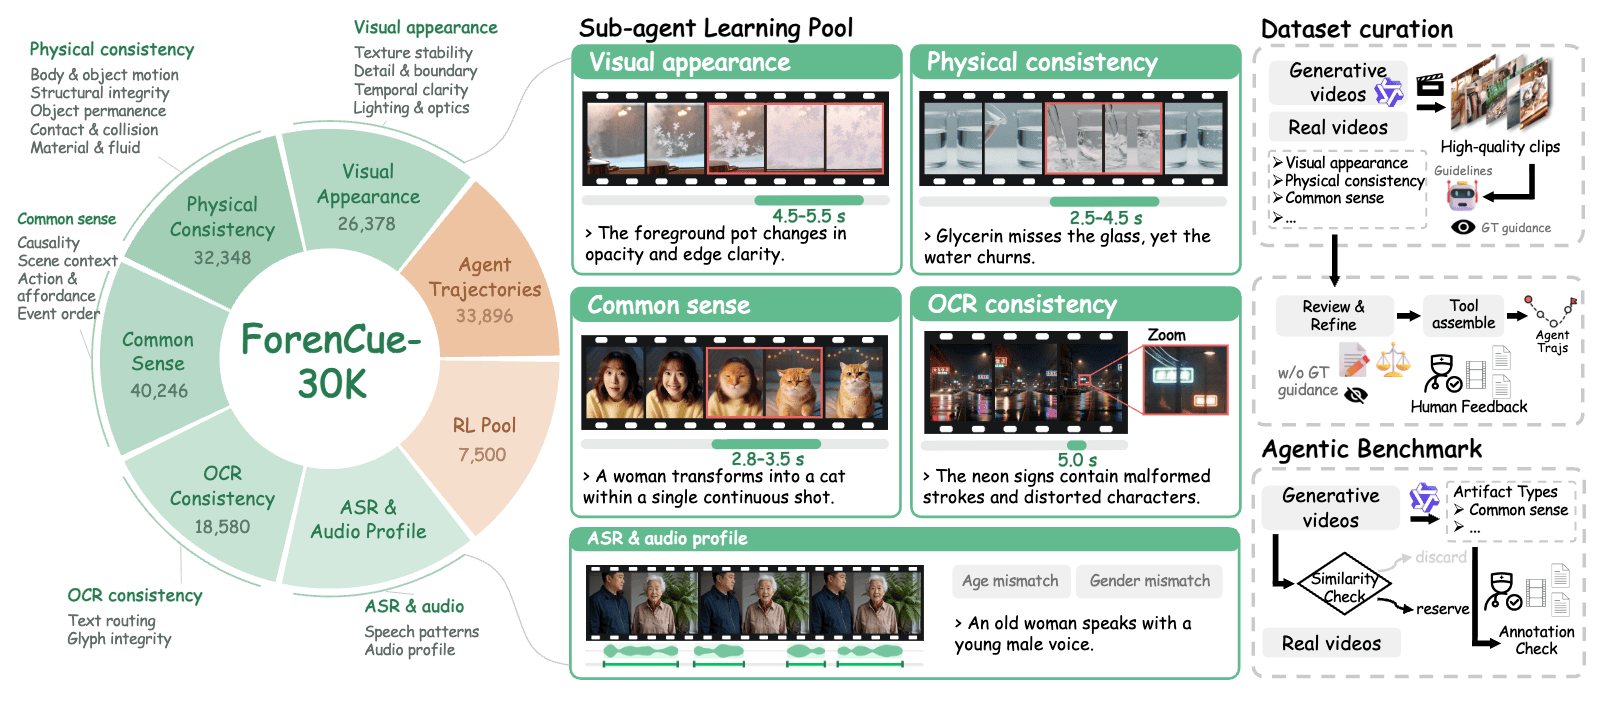
ForenCue-30K собран из 30 тысяч видео. Сгенерированные видео сделаны CogVideoX, HunyuanVideo, Wan 2.1/2.2, Kling 1.0/1.5, Veo 3 и другими моделями, настоящие взяты из OpenVid-1M, Koala-36M, Pexels и Pixabay. Каждое видео размечено отдельно для каждого эксперта: вердикт, уверенность, объяснение и интервал артефакта. Разметку делает VLM, другая VLM её проверяет, люди просматривают выборку, а звук размечали вручную. Из 340 проверенных пар «видео и роль» 99.1% подтвердились кадрами хотя бы частично. Траектории главного агента собраны из настоящих вызовов экспертов, а не из придуманных ответов.
AgenticCue проверяет обобщение на новые модели: Veo 3.1, Kling 2.5/3.0, Seedance 1.5/2.0, Hailuo 2.3, Wan 2.6, Sora 2 и другие, плюс цифровые аватары, замену лиц и чужой голос. В каждой из пяти категорий 500 сгенерированных видео и общие 500 настоящих. Бенчмарк оценивает и точность, и то, позвал ли агент нужного эксперта.
Насколько точно агент распознаёт сгенерированные видео
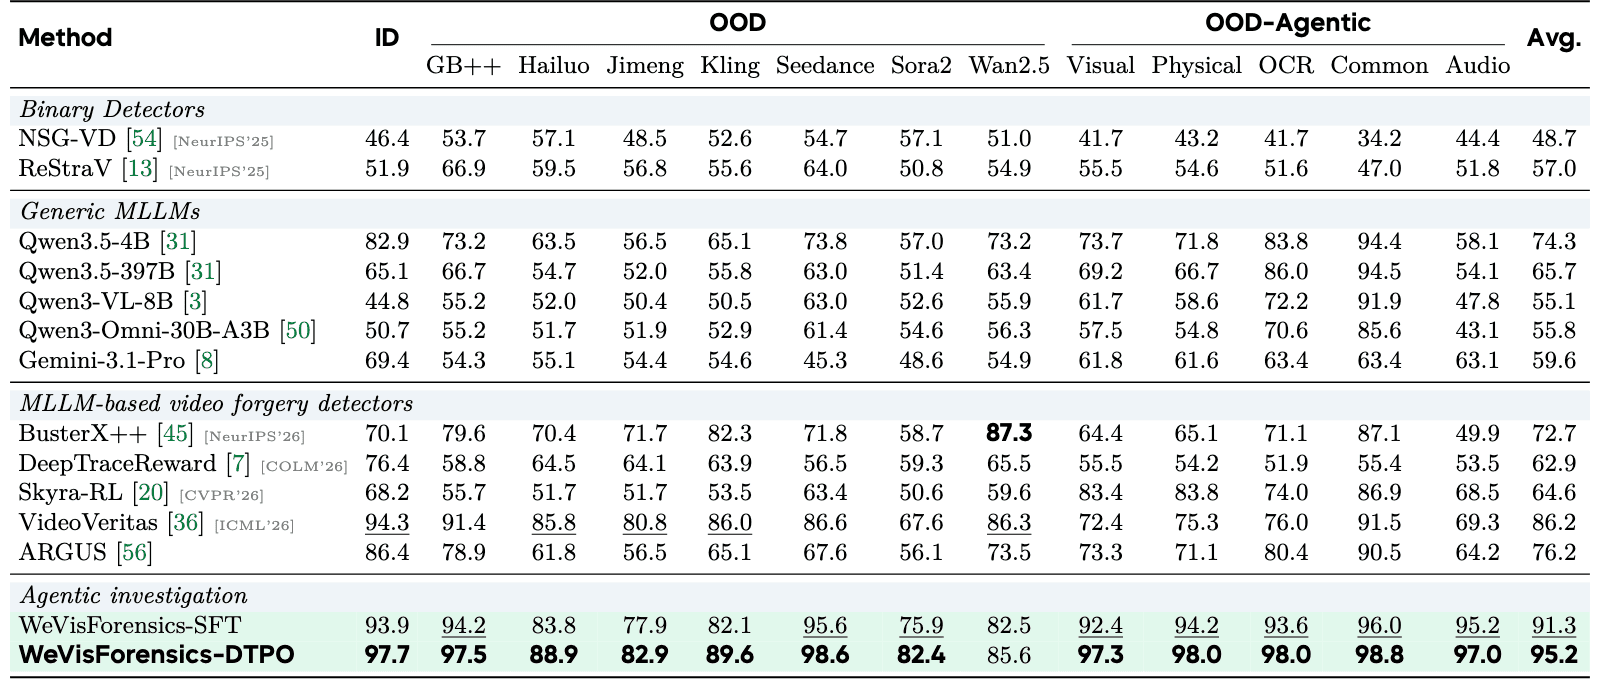
Бенчмарк GenBuster-Bench близок к обучающим данным, а в GenBuster-Bench++, MintVid и AgenticCue есть генераторы, которых в обучении не было. Бинарные детекторы NSG-VD и ReStraV, обученные на тех же данных, остаются на уровне случайного угадывания: 46.4% и 51.9% на GenBuster-Bench. WeVisForensics набирает там 97.7% против 94.3% у VideoVeritas, на GenBuster-Bench++ 97.5% против 91.4%, на шести генераторах MintVid 88.0% против 82.2%. Без дообучения Qwen3.5-4B в среднем набирает 74.3%.
Универсальные мультимодальные модели распознают сгенерированные видео заметно хуже. У Qwen3.5-397B на AgenticCue 94.5% в категории здравого смысла, но 54.1% в категории звука. Gemini-3.1-Pro находит 99% подделок на GenBuster-Bench++, но бракует и настоящие видео, поэтому её точность 54.3%. После DTPO агент делает на AgenticCue 2.19 вызова на видео вместо 2.50 после SFT. Когда он зовёт эксперта по физике, тексту, здравому смыслу или звуку, артефакт этого типа на видео есть в 94.3-99.7% случаев.
Что дала эволюция экспертов
Авторы проверили четыре сочетания агента и экспертов до и после DTPO. Если обучить только экспертов, средняя точность растёт с 91.3% до 92.0%, только агента до 93.2%, обоих до 95.2%. Совместный прирост на 1.3 пункта больше суммы отдельных: обученный агент точнее выбирает вопросы, а эксперты полезнее на них отвечают.
Сильнее всех изменился эксперт по физике: на GenBuster-Bench его F1 вырос с 66.5% до 97.8%, а доля ответов «определить нельзя» упала с 26.9% до 0.3%. Люди вслепую сравнили 200 пар ответов исходных и обученных экспертов: обученные лучше в 65 парах, исходные в 20, доля ответов с ошибками упала с 30.5% до 8.0%. Если обновлять экспертов на каждом батче, а не раз в 20 шагов, точность падает на всех шести генераторах MintVid.
Ограничения: какие сгенерированные видео агент пропускает
На незнакомых коммерческих генераторах агент осторожен: все настоящие ролики MintVid он признаёт настоящими, но находит только 64.6% подделок Sora 2 и 67.0% подделок Jimeng. Звуковые инструменты не дообучаются: размеченных звуковых подделок мало. Авторы предупреждают, что модель сделана для исследований и не должна сама принимать важные решения о людях.