Статья полностью обновлена в октябре 2026 года. Первая версия 2019 года была переводом сравнения Кирилла Добовикова «PyTorch vs TensorFlow — spotting the difference»; что изменилось с тех пор, мы собрали в разделе «Что изменилось с 2018 года».
Много лет вопрос «PyTorch или TensorFlow?» был первым на любом курсе по глубокому обучению. В 2026 году ответ стал гораздо яснее. PyTorch — основной фреймворк для исследований, больших языковых моделей и большинства новых продуктов. TensorFlow по-прежнему работает в тысячах систем, но в марте 2026 года Google объявил, что дальше будет выпускать для него только исправления безопасности, критических ошибок и обновления зависимостей. А граница между фреймворками размылась: Keras 3 запускает один и тот же код модели на TensorFlow, PyTorch или JAX.
В статье сравним PyTorch и TensorFlow такими, какие они в конце октября 2026 года: откуда они взялись, насколько широко используются, чем отличается код, как устроены отладка, компиляция, распределённое обучение и развёртывание, и что выбрать для своего проекта. Весь код ниже запущен на PyTorch 2.14, TensorFlow 2.21 и Keras 3.15, результаты приведены в том виде, в каком их напечатала программа.
Главное
- PyTorch — выбор по умолчанию в 2026 году. С PyPI его скачивают примерно в пять раз чаще, чем TensorFlow, а моделей с тегом PyTorch на Hugging Face примерно в 14 раз больше.
- TensorFlow на поддержке. С марта 2026 года Google обещает только исправления безопасности и критических ошибок и обновления зависимостей, а для новых проектов в генеративном ИИ советует Keras 3, JAX или PyTorch. Существующие системы на TensorFlow продолжают работать.
- Код стал очень похожим. Оба фреймворка по умолчанию выполняют операции сразу, сами считают градиенты и умеют компилировать код в быстрые графы:
torch.compileв PyTorch,tf.functionв TensorFlow. - Keras 3 — мост между ними: одно описание модели обучается на TensorFlow, JAX или PyTorch; в нашем тесте все три варианта дали точность 96–97% с одинаковым кодом.
- Для мобильных устройств у обоих есть зрелые решения: ExecuTorch для PyTorch и LiteRT, бывший TensorFlow Lite, который умеет запускать и сконвертированные модели PyTorch.
Короткий ответ
- Изучаете глубокое обучение или начинаете новый проект: PyTorch. На нём написано большинство курсов, статей, туториалов, открытых моделей, его чаще всего требуют в вакансиях.
- Работаете с большими языковыми моделями и генеративным ИИ: PyTorch. Hugging Face Transformers v5 поддерживает только PyTorch, на нём же построены движки инференса vLLM и SGLang.
- Поддерживаете систему на TensorFlow: пусть работает, поддержка продолжается; новые компоненты планируйте на Keras 3 или PyTorch.
- Нравится высокоуровневый API Keras: берите Keras 3 и выбирайте бэкенд, при необходимости меняйте его.
- Обучаете на Google TPU в большом масштабе: естественнее всего JAX; PyTorch тоже работает на TPU через PyTorch/XLA.
PyTorch, TensorFlow, Keras и JAX в 2026 году
| Фреймворк | Кто создал | Первый релиз | Последняя версия (октябрь 2026) | Статус |
|---|---|---|---|---|
| PyTorch | Meta AI (тогда Facebook AI Research); с 2022 года развивается PyTorch Foundation при Linux Foundation | 2016 | 2.15 (28 октября 2026) | Активная разработка, несколько крупных релизов в год |
| TensorFlow | Google Brain | Ноябрь 2015 | 2.21 (март 2026) | Только исправления безопасности, критических ошибок и обновления зависимостей |
| Keras | Франсуа Шолле, сейчас развивается в Google | 2015; Keras 3 — ноябрь 2023 | 3.15 | Активная разработка; работает на TensorFlow, JAX или PyTorch |
| JAX | 2018 | 0.12 | Активная разработка; на нём Google DeepMind обучает Gemini |
Фреймворки начинали с противоположных идей. TensorFlow 1.x требовал сначала построить статический граф вычислений, а потом запускать его в сессии: это упрощало развёртывание и оптимизацию, но отладка была мучительной. PyTorch, наследник Torch на языке Lua, выполнял операции сразу, как обычный код на Python, и этим понравился исследователям. С тех пор подходы сблизились: TensorFlow 2.0 (2019) сделал немедленное (eager) выполнение режимом по умолчанию и взял Keras основным API, а PyTorch 2.0 (2023) добавил torch.compile, который превращает обычный код в оптимизированный граф.
Кто чем пользуется: цифры
Идеального способа посчитать пользователей фреймворка нет, но два открытых показателя говорят одно и то же:
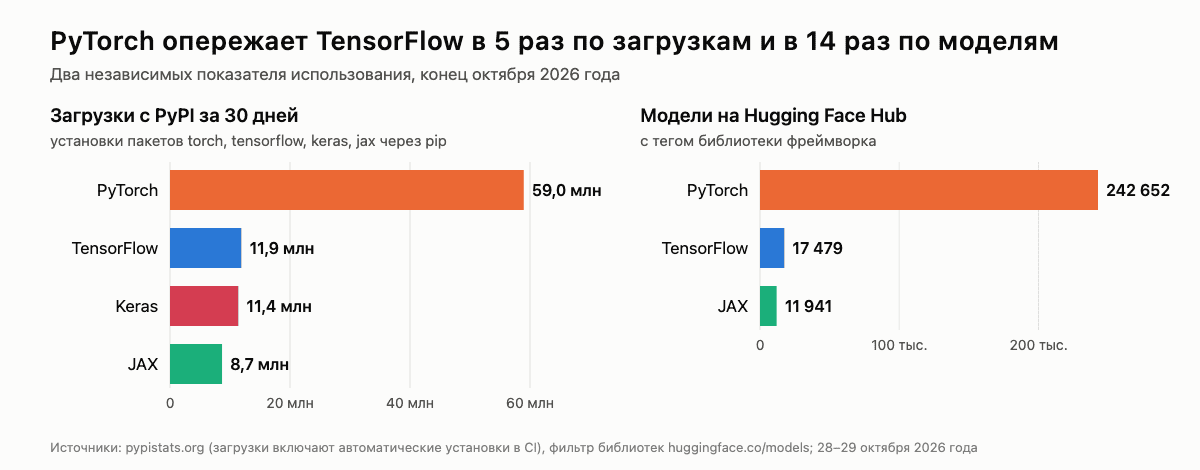
- Загрузки с PyPI. За 30 дней до 28 октября 2026 года пакет
torchскачали 59,0 млн раз,tensorflow— 11,9 млн,keras— 11,4 млн,jax— 8,7 млн. В загрузки входят автоматические установки в CI, поэтому людей меньше, но соотношение примерно пять к одному показательно. - Модели на Hugging Face. С тегом библиотеки PyTorch на Hub 242 652 модели, с TensorFlow — 17 479, с JAX — 11 941. Многие новые модели публикуются только в формате safetensors без тега фреймворка, так что общее число моделей больше, но почти все они загружаются через PyTorch.
Экосистема движется туда же. В декабре 2025 года Hugging Face выпустил Transformers v5, где PyTorch — единственный бэкенд, а поддержка TensorFlow и Flax сворачивается. Исследовательский код уже много лет пишут в основном на PyTorch, и популярные инструменты обучения и запуска LLM, от DeepSpeed и FSDP до vLLM, построены на нём.
TensorFlow умер?
Нет, но и не развивается. В анонсе TensorFlow 2.21 от 6 марта 2026 года Google написал, что команда дальше будет заниматься только исправлениями безопасности и критических ошибок, обновлением зависимостей (включая поддержку новых версий Python) и рассмотрением важных правок от сообщества. То же касается связанных проектов: tf.data, TensorFlow Serving и TFX. Для новой работы в генеративном ИИ Google советует присмотреться к Keras 3, JAX и PyTorch.
На практике это значит:
- Существующие модели и пайплайны на TensorFlow продолжат работать и получать обновления безопасности; срочно переписывать их не нужно.
- Новых возможностей, новых архитектур в библиотеках TensorFlow и поддержки нового железа сверх существующего ждать не стоит.
- Часть для устройств, бывший TensorFlow Lite, живёт дальше под именем LiteRT и развивается отдельно и активно.
- Новые проекты, которые раньше начали бы на TensorFlow, лучше начинать на Keras 3 (с привычным API) или на PyTorch.
Одна задача на двух фреймворках
В версии этой статьи 2019 года фреймворки сравнивались на игрушечной задаче: по данным найти неизвестный показатель степени φ функции f(x) = xφ с помощью градиентного спуска.

В 2019 году версии на TensorFlow требовались placeholder, сессия и явный граф. В 2026 году два варианта совпадают почти строка в строку. PyTorch:
import torch

torch.manual_seed(0)
x = torch.rand(1000) * 2                       # входные данные
y = x ** 2.5                                   # целевые значения: f(x) = x^phi, истинное phi = 2.5

phi = torch.tensor(1.0, requires_grad=True)    # неизвестный параметр, начальное приближение 1.0
optimizer = torch.optim.SGD([phi], lr=0.01, momentum=0.9)

for step in range(1, 201):
    loss = torch.mean((x ** phi - y) ** 2)          # среднеквадратичная ошибка
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    if step in (1, 25, 50, 100, 200):
        print(f"step {step:3d}  phi = {phi.item():.4f}  loss = {loss.item():.5f}")
step 1 phi = 1.0148 loss = 1.72853
step 25 phi = 2.7988 loss = 0.17768
step 50 phi = 2.4707 loss = 0.00371
step 100 phi = 2.5031 loss = 0.00003
step 200 phi = 2.5000 loss = 0.00000TensorFlow:
import tensorflow as tf

tf.random.set_seed(0)
x = tf.random.uniform([1000]) * 2
y = x ** 2.5

phi = tf.Variable(1.0)
optimizer = tf.keras.optimizers.SGD(learning_rate=0.01, momentum=0.9)

for step in range(1, 201):
    with tf.GradientTape() as tape:
        loss = tf.reduce_mean((x ** phi - y) ** 2)
    optimizer.apply_gradients([(tape.gradient(loss, phi), phi)])
    if step in (1, 25, 50, 100, 200):
        print(f"step {step:3d}  phi = {phi.numpy():.4f}  loss = {loss.numpy():.5f}")
step 1 phi = 1.0136 loss = 1.57933
step 25 phi = 2.7704 loss = 0.10983
step 50 phi = 2.4311 loss = 0.01033
step 100 phi = 2.5066 loss = 0.00008
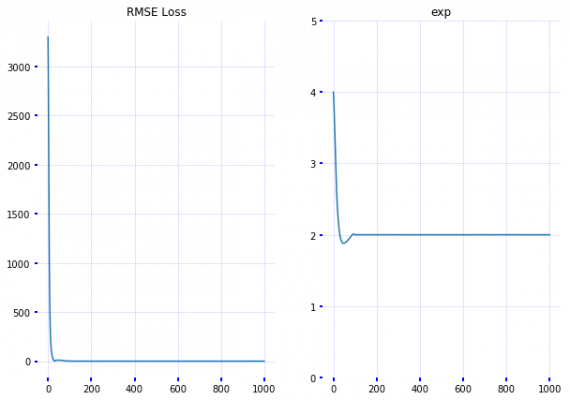
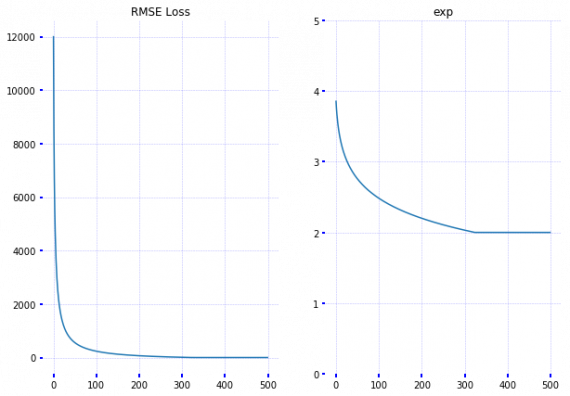
step 200 phi = 2.5000 loss = 0.00000Оба за 200 шагов градиентного спуска с инерцией находят φ = 2.5000. Отличается только то, как записываются градиенты: PyTorch отслеживает операции над тензорами с requires_grad=True и считает градиенты вызовом loss.backward(), а TensorFlow записывает операции внутри блока tf.GradientTape и запрашивает градиенты у этой «ленты». Оба автоматически выполняют обратное распространение ошибки. Для сравнения — графики из версии 2019 года: функция потерь и оценка показателя по ходу обучения, сначала в PyTorch, потом в TensorFlow 1.x:
Нейронная сеть на PyTorch и TensorFlow
Пример поближе к реальности: небольшая полносвязная сеть, многослойный персептрон с одним скрытым слоем из 128 нейронов, которая распознаёт рукописные цифры на картинках 8×8. В обеих версиях одинаковые данные, архитектура, оптимизатор Adam, размер батча 32 и 20 эпох. PyTorch с явным циклом обучения:
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
X, y = load_digits(return_X_y=True)                      # 1 797 изображений цифр 8x8 пикселей
X_train, X_test, y_train, y_test = train_test_split(X / 16.0, y, test_size=0.25, random_state=0)
X_train, X_test = torch.tensor(X_train, dtype=torch.float32), torch.tensor(X_test, dtype=torch.float32)
y_train, y_test = torch.tensor(y_train), torch.tensor(y_test)

model = nn.Sequential(nn.Linear(64, 128), nn.ReLU(), nn.Linear(128, 10))
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_fn = nn.CrossEntropyLoss()

for epoch in range(20):                                   # цикл обучения - обычный Python
    perm = torch.randperm(len(X_train))
    for i in range(0, len(X_train), 32):
        idx = perm[i:i + 32]
        loss = loss_fn(model(X_train[idx]), y_train[idx])
        optimizer.zero_grad()
        loss.backward()                                   # autograd вычисляет градиенты
        optimizer.step()

model.eval()
with torch.no_grad():
    acc = (model(X_test).argmax(1) == y_test).float().mean().item()
print(f"PyTorch {torch.__version__}: точность на тесте {acc:.3f}")
PyTorch 2.14.1+cu130: точность на тесте 0.967TensorFlow с собственным шагом обучения и tf.data:
import tensorflow as tf
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

tf.random.set_seed(0)
X, y = load_digits(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X / 16.0, y, test_size=0.25, random_state=0)
X_train, X_test = X_train.astype("float32"), X_test.astype("float32")

model = tf.keras.Sequential([
    tf.keras.Input(shape=(64,)),
    tf.keras.layers.Dense(128, activation="relu"),
    tf.keras.layers.Dense(10),
])
optimizer = tf.keras.optimizers.Adam(learning_rate=1e-3)
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)
dataset = tf.data.Dataset.from_tensor_slices((X_train, y_train)).shuffle(2000, seed=0).batch(32)

@tf.function                                              # компилирует шаг в граф для скорости
def train_step(xb, yb):
    with tf.GradientTape() as tape:                       # записывает операции для вычисления градиентов
        loss = loss_fn(yb, model(xb, training=True))
    grads = tape.gradient(loss, model.trainable_variables)
    optimizer.apply_gradients(zip(grads, model.trainable_variables))

for epoch in range(20):
    for xb, yb in dataset:
        train_step(xb, yb)

pred = tf.argmax(model(X_test), axis=1).numpy()
print(f"TensorFlow {tf.__version__}: точность на тесте {(pred == y_test).mean():.3f}")
TensorFlow 2.21.0: точность на тесте 0.971Результаты совпадают в пределах случайного разброса: 96,7% и 97,1% на тестовой выборке. Разница в стиле. В PyTorch всё остаётся обычным Python: индексируете тензоры, вызываете модель, потом backward() и step(). TensorFlow использует свой конвейер данных (tf.data), выносит шаг обучения в отдельную функцию и компилирует её декоратором @tf.function. Обычно в TensorFlow цикл вообще не пишут, а вызывают model.fit() — именно это Keras 3 предлагает на любом бэкенде.
Keras 3: одна модель, три бэкенда
Keras 3 — высокоуровневый API, который работает поверх TensorFlow, JAX или PyTorch. Бэкенд выбирается одной переменной окружения до импорта Keras, а код модели не меняется:
import os
import sys
os.environ["KERAS_BACKEND"] = sys.argv[1]                 # "tensorflow", "jax" или "torch", до импорта keras
import keras
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

keras.utils.set_random_seed(0)
X, y = load_digits(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X / 16.0, y, test_size=0.25, random_state=0)

model = keras.Sequential([
    keras.Input(shape=(64,)),
    keras.layers.Dense(128, activation="relu"),
    keras.layers.Dense(10),
])
model.compile(optimizer=keras.optimizers.Adam(learning_rate=1e-3),
              loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics=["accuracy"])
model.fit(X_train, y_train, epochs=20, batch_size=32, verbose=0)
loss, acc = model.evaluate(X_test, y_test, verbose=0)
print(f"Keras {keras.__version__} on {keras.backend.backend()}: точность на тесте {acc:.3f}")
Запускаем скрипт три раза с аргументами tensorflow, jax и torch:
Keras 3.15.1 on tensorflow: точность на тесте 0.964
Keras 3.15.1 on jax: точность на тесте 0.969
Keras 3.15.1 on torch: точность на тесте 0.969
Одни и те же двадцать строк обучают одну и ту же сеть на трёх разных фреймворках с одинаковым результатом. Модель Keras на бэкенде PyTorch одновременно является обычным torch.nn.Module, её можно смешивать с кодом на PyTorch, а сохранённые модели Keras загружаются на любом бэкенде. Для команд с большим объёмом кода на Keras это самый простой путь уйти с TensorFlow: сменить бэкенд, проверить и оставить код как есть.
Главные отличия
| PyTorch | TensorFlow | |
|---|---|---|
| Стиль кода | Близкий к Python, объектно-ориентированный: модели — классы nn.Module, цикл обучения пишется вручную или с Lightning, Hugging Face Accelerate и похожими библиотеками |
API Keras с model.fit() или собственные циклы с GradientTape |
| Выполнение | Немедленное по умолчанию; torch.compile компилирует модель в оптимизированные ядра; torch.export сохраняет полный граф для развёртывания |
Немедленное по умолчанию; tf.function превращает код в граф, при желании с компиляцией XLA |
| Отладка | Любой отладчик Python, print, точки останова внутри модели | То же в немедленном режиме; внутри графов tf.function отлаживать сложнее, нужен tf.config.run_functions_eagerly(True) |
| Железо | NVIDIA CUDA, AMD ROCm, Apple Silicon (MPS), видеокарты Intel; TPU через PyTorch/XLA | Видеокарты NVIDIA (в Windows с версии 2.11 только через WSL2), Google TPU; другое железо через плагины |
| Распределённое обучение | DDP, FSDP2, тензорный и конвейерный параллелизм, DeepSpeed, Megatron; стандарт для обучения LLM | Стратегии tf.distribute, зрелый параллелизм по данным на GPU и TPU |
| Модели и библиотеки | Hugging Face Transformers и Diffusers, timm, torchvision, vLLM, SGLang и почти все открытые инструменты для LLM | Kaggle Models (бывший TensorFlow Hub), KerasHub, TFX для продакшн-пайплайнов |
| Визуализация | TensorBoard (через torch.utils.tensorboard), Weights & Biases, MLflow |
TensorBoard, с TensorFlow 2.21 устанавливается отдельно |
| Сервинг | vLLM и SGLang для LLM, NVIDIA Triton, Ray Serve, ONNX Runtime; TorchServe больше активно не развивается | TensorFlow Serving, на поддержке, как и весь TensorFlow |
| Мобильные и встраиваемые устройства | ExecuTorch (версия 1.0 с октября 2025) | LiteRT (бывший TensorFlow Lite) |
| Развитие | Активное, новые релизы каждые несколько месяцев | С марта 2026 года только поддержка |
Скорости в таблице нет намеренно. Одна и та же модель на одной видеокарте в обоих фреймворках вызывает одни и те же библиотеки NVIDIA (cuDNN, cuBLAS), а разница в опубликованных бенчмарках обычно объясняется реализацией модели, загрузкой данных или настройками компиляции, а не самим фреймворком. Выбирайте по экосистеме и удобству работы, а не по графикам бенчмарков.
Развёртывание и мобильные устройства
Развёртывание раньше было главным козырем TensorFlow: в 2019 году у TensorFlow Serving и TensorFlow Lite не было полноценных аналогов в PyTorch. Сейчас разрыва нет.
- Серверы. Модели PyTorch разворачивают через
torch.exportи AOTInductor, NVIDIA Triton Inference Server, ONNX Runtime после экспорта в ONNX или через специализированные движки для LLM — vLLM и SGLang. Собственный сервер моделей PyTorch, TorchServe, переведён в режим ограниченной поддержки. TensorFlow Serving по-прежнему хорошо работает с существующими моделями TensorFlow. - Мобильные и встраиваемые устройства. ExecuTorch, среда выполнения PyTorch для устройств, вышел в версии 1.0 в октябре 2025 года; Meta использует его в Instagram, WhatsApp, Messenger и Facebook и в своих умных очках. LiteRT, переименованный TensorFlow Lite, активно развивается Google, поддерживает ускорение на GPU и NPU и запускает модели, сконвертированные из PyTorch конвертером AI Edge Torch. Подробнее о запуске моделей на телефонах — в статье про TensorFlow на iOS и Android.
- Браузер. Для моделей TensorFlow и Keras остаётся TensorFlow.js; экспортированные модели PyTorch запускает ONNX Runtime Web.
Общий знаменатель — формат ONNX: большинство моделей PyTorch и TensorFlow можно экспортировать в ONNX и запускать через ONNX Runtime на серверах, телефонах и в браузере.
А как же JAX?
JAX — третий фреймворк Google и основной для его исследований: Google DeepMind обучает Gemini на JAX с системой Pathways на TPU. JAX похож на NumPy, но любую функцию в нём можно продифференцировать через jax.grad, скомпилировать через jax.jit и распараллелить на много ускорителей. Поверх него работают библиотеки нейросетей Flax и Keras 3.
JAX раскрывается на TPU и в обучении большого масштаба, где окупаются его компилятор и средства параллелизма. Сообщество у него меньше, готовых моделей меньше, а порог входа выше, чем у PyTorch: нужен функциональный стиль — без изменения данных на месте, с явными ключами генератора случайных чисел и чистыми функциями. Для большинства практиков в 2026 году выбор стоит между PyTorch и Keras 3, а JAX — специализированный инструмент для TPU и передовых исследований.
Что выбрать
- Студентам и начинающим: PyTorch. По нему больше туториалов, курсов и ответов на форумах, а навыки напрямую пригодятся в исследованиях и в индустрии. Начать можно с нашего туториала по PyTorch, руководства свёрточная нейронная сеть на PyTorch и статей про свёрточные, рекуррентные сети и LSTM.
- Исследователям: PyTorch или JAX, если работаете на TPU или нужны его функциональные преобразования.
- Разработчикам LLM и генеративного ИИ: PyTorch: Hugging Face, vLLM, библиотеки дообучения и почти все открытые модели рассчитаны на него.
- Командам с TensorFlow в продакшне: продолжайте поддерживать систему; новые модели пишите на Keras 3, чтобы потом можно было сменить бэкенд; переходите, когда система всё равно требует серьёзной переделки.
- Мобильным разработчикам: подойдёт любой: ExecuTorch для моделей PyTorch, LiteRT для моделей TensorFlow и сконвертированных из PyTorch.
Важно и железо: какой бы фреймворк вы ни выбрали, скорость обучения в основном определяется видеокартой и её памятью. Об этом — в статье как выбрать видеокарту для нейросетей.
Что изменилось с 2018 года
В первой версии статьи было пять главных отличий. Вот как каждое выглядит в 2026 году:
| Отличие в 2018 году | В 2026 году |
|---|---|
| Распространённость: TensorFlow — стандарт, PyTorch — новинка в бета-версии | Наоборот: PyTorch с большим отрывом впереди, TensorFlow на поддержке |
| Динамический (PyTorch) и статический (TensorFlow) граф | Оба по умолчанию выполняют операции сразу, оба умеют компилировать в граф |
| Отладка: любые инструменты Python в PyTorch, специальный tfdbg в TensorFlow | В немедленном режиме обычная отладка Python работает в обоих |
| Визуализация: TensorBoard против visdom | TensorBoard работает с обоими; популярны также Weights & Biases и MLflow |
| Развёртывание: TensorFlow заметно впереди | Сопоставимо: ExecuTorch и LiteRT на устройствах, много вариантов сервинга у обоих |
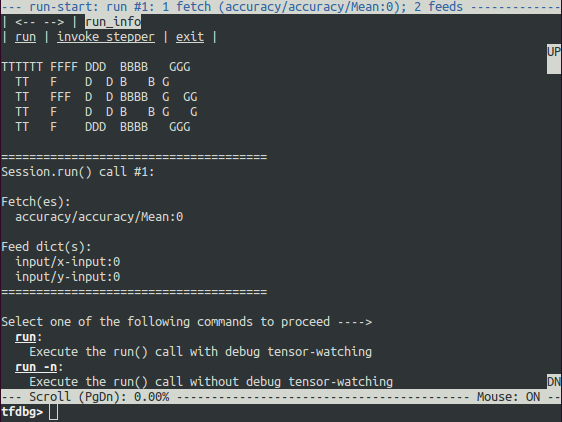
В 2018 году для отладки графов TensorFlow нужен был собственный отладчик tfdbg с терминальным интерфейсом:
Частые вопросы
Что лучше: PyTorch или TensorFlow?
Для большинства новых проектов в 2026 году — PyTorch: у него гораздо больше сообщество, на нём выходят почти все новые модели и инструменты, он активно развивается и удобнее в работе. TensorFlow остаётся надёжным выбором для систем, которые на нём уже построены, и для его зрелых инструментов сервинга и пайплайнов, но новых возможностей он больше не получает.
Используют ли TensorFlow в 2026 году?
Да, широко, в основном в уже работающих системах: за последний месяц его скачали с PyPI около 12 млн раз. С марта 2026 года Google выпускает для него исправления безопасности и обновления зависимостей, а новые проекты в генеративном ИИ направляет на Keras 3, JAX и PyTorch.
Что учить первым: PyTorch или TensorFlow?
PyTorch. Понятия — тензоры, автоматическое дифференцирование, слои, оптимизаторы, цикл обучения — в обоих одинаковые, поэтому перейти потом на TensorFlow или Keras можно за несколько дней.
PyTorch быстрее TensorFlow?
В общем случае нет. На одной видеокарте оба используют одни и те же библиотеки NVIDIA, и хорошо написанный код работает с похожей скоростью. Компиляция (torch.compile или XLA), смешанная точность и загрузка данных влияют намного сильнее, чем выбор фреймворка.
Чем Keras отличается от TensorFlow?
Keras — высокоуровневый API для создания и обучения моделей, TensorFlow — полноценный фреймворк со своими тензорами, автоматическим дифференцированием и инструментами развёртывания. Keras был официальным API TensorFlow, а начиная с Keras 3 снова стал независимым и работает на TensorFlow, JAX или PyTorch.
Можно ли перевести модель с TensorFlow на PyTorch?
Конвертации в один клик нет, но есть рабочие способы: запустить модель Keras на бэкенде PyTorch в Keras 3, экспортировать модель в ONNX и запускать через ONNX Runtime или загрузить веса в такую же архитектуру на PyTorch. Для популярных архитектур на Hugging Face обычно уже есть веса для PyTorch.