VideoJev: открытая модель отвечает на вопросы по видео с точностью режима Thinking, но в 100 раз быстрее

14 октября 2026
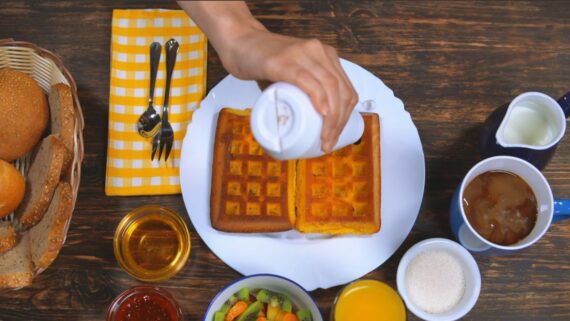
Кадр из видео, по которому VideoJev отвечает на вопросы: в вафли добавляют шоколад, вид сверху на стол с завтраком

VideoJev: открытая модель отвечает на вопросы по видео с точностью режима Thinking, но в 100 раз быстрее

Исследователи из Nanjing University, JD.com и ещё шести китайских университетов представили VideoJev, семейство видеомоделей, которые отвечают на вопросы по видео в сотню раз быстрее моделей в режиме рассуждений (Thinking) и…
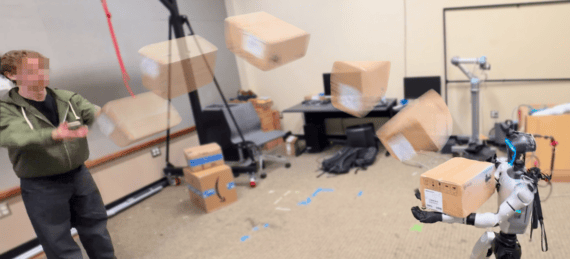
Гуманоидный робот ловит коробки весом до 2 кг на расстоянии до 7 метров, ориентируясь на данные с камеры

13 октября 2026
Гуманоидный робот Unitree G1 ловит брошенную коробку с методом Reflex

Гуманоидный робот ловит коробки весом до 2 кг на расстоянии до 7 метров, ориентируясь на данные с камеры

Исследователи из University of Washington, USC, National University of Singapore, UNC Chapel Hill и Allen Institute for AI научили гуманоидного робота Unitree G1 ловить брошенные ему коробки весом до 2…

Vidu S2: модель генерирует видео-аватары в 720p при 25–42 FPS и редактирует часовые стримы на лету

19 сентября 2026
Vidu S2

Vidu S2: модель генерирует видео-аватары в 720p при 25–42 FPS и редактирует часовые стримы на лету

Исследователи Tsinghua University и Shengshu Technology представили Vidu S2 — две видеомодели, с помощью которых можно создать цифровой аватар и провести с ним видеозвонок или запустить стрим, а видеопоток редактировать в реальном…

TurboVLA: робот получает команды в разы быстрее при 97% успешных выполнений благодаря замене LLM на BERT

3 августа 2026
TurboVLA model robot munipulation

TurboVLA: робот получает команды в разы быстрее при 97% успешных выполнений благодаря замене LLM на BERT

Исследователи из Хуачжунского университета науки и технологий и Huawei опубликовали TurboVLA — компактную vision-language-action модель, которая выдаёт действия для робота за 31.2 мс на потребительской RTX 4090 и набирает 97.7% на…

LLaVA-OneVision-2-8B: мультимодальная модель анализирует сжатый видеопоток через кодек вместо нарезки кадров

28 мая 2026
LLaVA-OneVision-2

LLaVA-OneVision-2-8B: мультимодальная модель анализирует сжатый видеопоток через кодек вместо нарезки кадров

Исследователи из Glint Lab, AIM for Health Lab и MVP Lab опубликовали LLaVA-OneVision-2 (LLaVA-OV-2) — мультимодальную модель нового поколения, которая переосмысливает то, как нейросеть «смотрит» видео. Вместо того чтобы нарезать видео…

AI-модели на 13% хуже людей распознают сгенерированные ASMR-видео

18 декабря 2025
AI-generated video

AI-модели на 13% хуже людей распознают сгенерированные ASMR-видео

Исследователи из CUHK, NUS, University of Oxford и Video Rebirth представили Video Reality Test — первый бенчмарк, который проверяет, могут ли современные AI-модели создавать видео, неотличимые от настоящих. В отличие…

Mini-o3: открытая мультимодальная 7B-модель превзошла GPT-4o в визуальном поиске благодаря 30-шаговым цепочкам рассуждений

10 сентября 2025
Observation mini-o3

Mini-o3: открытая мультимодальная 7B-модель превзошла GPT-4o в визуальном поиске благодаря 30-шаговым цепочкам рассуждений

Исследователи из ByteDance и Университета Гонконга представили Mini-o3 — мультимодальную модель, которая выполняет глубокие многошаговые рассуждения для решения сложных задач визуального поиска. Mini-o3 достигает SOTA результатов на сложных бенчмарках, превосходя…

3D-R1: открытая модель с рассуждениями для 3D-сцен превосходит современные методы на 10% на 3D-бенчмарках

6 августа 2025
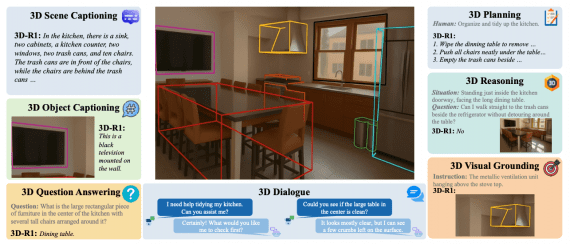
3D-R1 model

3D-R1: открытая модель с рассуждениями для 3D-сцен превосходит современные методы на 10% на 3D-бенчмарках

Исследователи из Шанхайского университета инженерных наук и Пекинского университета представили 3D-R1 — новую foundation-модель, которая значительно улучшает способности к рассуждению в трёхмерных vision-language моделях (VLM).  Модель демонстрирует среднее улучшение производительности…

NVIDIA Isaac 5.0: обучение роботов с продвинутой физикой сенсоров и генерацией синтетических данных с открытым кодом

19 мая 2025
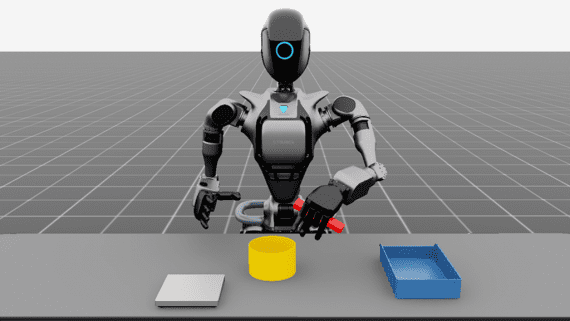
NVIDIA Isaac robotics platform showing a humanoid robot interacting with objects

NVIDIA Isaac 5.0: обучение роботов с продвинутой физикой сенсоров и генерацией синтетических данных с открытым кодом

NVIDIA представила обновления своей экосистемы Isaac для разработки роботов на выставке COMPUTEX 2025, которые улучшают возможности генерации синтетических данных и совершенствуют тестирование моделей на всех этапах разработки. Isaac Sim 5.0:…

R1-Onevision: открытая мультимодальная 7B модель обходит GPT4o в рассуждениях и математике

27 февраля 2025
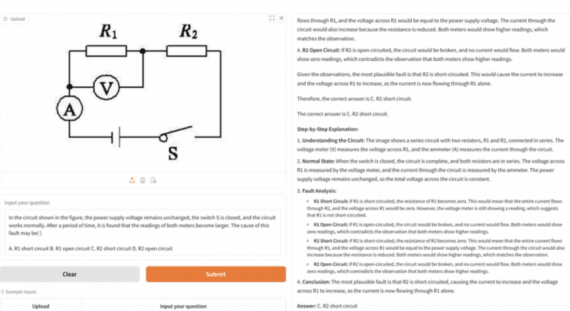
r1 demo

R1-Onevision: открытая мультимодальная 7B модель обходит GPT4o в рассуждениях и математике

Исследователи из Чжэцзянского университета представили R1-Onevision, открытую мультимодальную модель рассуждений с 7 миллиардами параметров. R1-Onevision решает сложные математические, научные и инженерные задачи с показателями производительности, превосходящими GPT-4o в математике и…

Molmo: семейство открытых мультимодальных моделей обходит Claude 3.5 и Gemini 1.5 тестах

26 сентября 2024

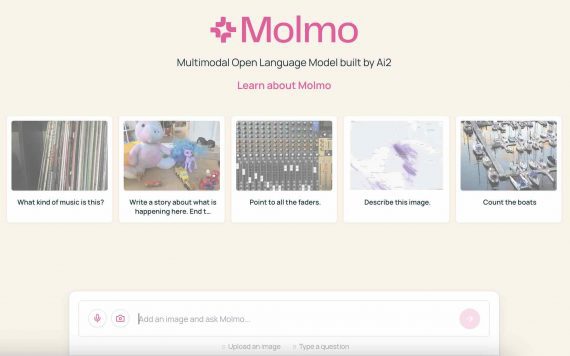
Molmo: семейство открытых мультимодальных моделей обходит Claude 3.5 и Gemini 1.5 тестах

Molmo — семейство мультимодальных моделей Vision-Language (VLM), разработанных исследователями из Allen Institute for AI и Университета Вашингтона. Семейство моделей Molmo превосходит многие проприетарные и открытые state-of-the-art модели по результатам академических…

Модель обучили понимать язык с помощью видеозаписей

23 июня 2024
DenseAV Algorithm

Модель обучили понимать язык с помощью видеозаписей

Разработанный в MIT алгоритм DenseAV обучается понимать значение слов и предложений, просматривая видео с разговорами людей. DenseAV превзошел другие алгоритмы в задачах идентификации объектов по их названию. Исследователи решили задачу…

Hugging Face и Pollen Robotics показали Reachy2 — open-source робота для работы по дому

10 июня 2024

Hugging Face и Pollen Robotics показали Reachy2 — open-source робота для работы по дому

Hugging Face и Pollen Robotics представили антропоморфного робота Reachy2, обучающий датасет и модель которого опубликованы в открытом доступе. Reachy2 умеет выполнять домашние обязанности и безопасно взаимодействует с людьми и домашними…

Microsoft VASA-1: платформа для анимирования статичных изображений

21 апреля 2024
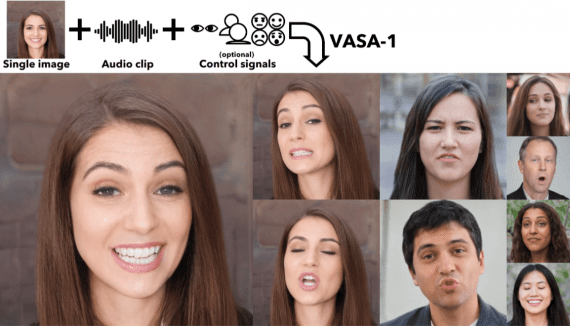
microsoft vasa-1

Microsoft VASA-1: платформа для анимирования статичных изображений

Microsoft представила платформу VASA-1, преобразующую изображение человека и аудиозапись с речью в видео с синхронизированными движениями губ и головы. Алгоритм работает в реальном времени со скоростью 40 кадров в секунду.…

SCIN: датасет изображений дерматологических заболеваний

25 марта 2024
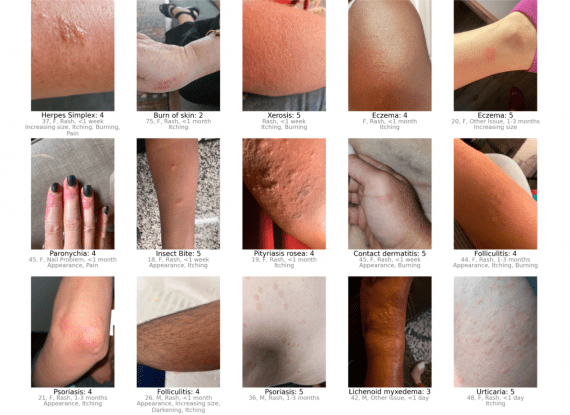
google scin dataset

SCIN: датасет изображений дерматологических заболеваний

Google представила SCIN – открытый датасет с 10 000 изображениями дерматологических заболеваний. Обученные на его основе модели смогут удаленно диагностировать аллергические, воспалительные и инфекционные состояния кожи, ногтей и волос. Медицинские…

В Midjourney добавили функцию переноса персонажа на новое изображение

17 марта 2024
перенос персонажа

В Midjourney добавили функцию переноса персонажа на новое изображение

В сервисе генерации изображений Midjourney появилась возможность переноса персонажа на новое изображение путем указания в запросе ссылки на уже существующее с ним изображение. Функция позволит использовать сервис для создания новых…

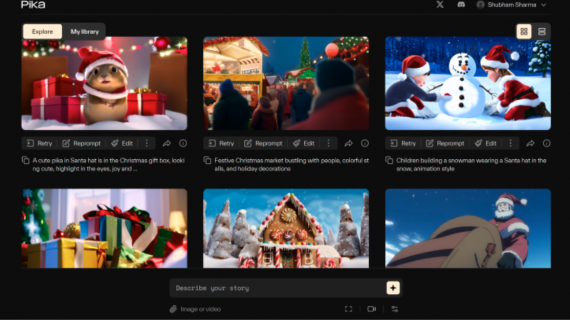
Pika 1.0: веб-платформа для генерации видео

7 января 2024
pika

Pika 1.0: веб-платформа для генерации видео

Стартап Pika Labs запустил Pika 1.0 – бесплатную веб-платформу для генерации и редактирования видео с помощью текстовых запросов. Сервис создает как реалистичные видео, так и 3D-анимацию в различных стилях. При…

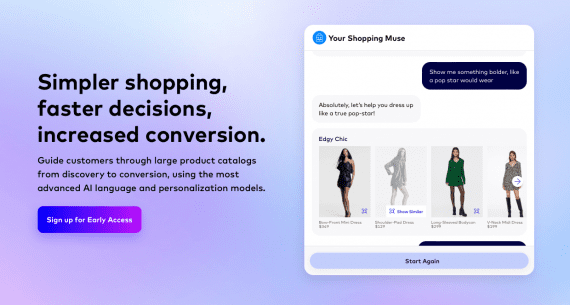
Shopping Muse: рекомендательная система Mastercard

10 декабря 2023

Shopping Muse: рекомендательная система Mastercard

Mastercard представила Shopping Muse – модуль для интернет-магазинов в формате чат-бота, рекомендующий покупателю товары на основе его истории покупок и поиска, региона и других признаков. Shopping Muse работает на базе…

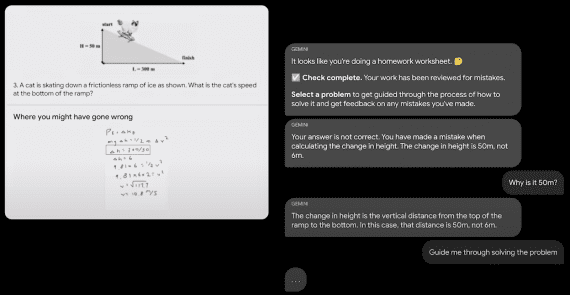
Google представила набор языковых моделей Gemini

7 декабря 2023

Google представила набор языковых моделей Gemini

Google сообщила о создании Gemini – набора из трех языковых моделей, превосходящих конкурентов в 30 из 32 бенчмарках. Старшая модель Gemini Ultra доступна через API, средняя Gemini Pro будет использоваться…

Stable Video Diffusion: генератор видео по изображению от Stability AI

26 ноября 2023
Stable Video Diffusion

Stable Video Diffusion: генератор видео по изображению от Stability AI

Компания Stability AI объявила о выпуске Stable Video Diffusion – набора из двух моделей, генерирующих видео продолжительностью до 4 секунд по входному изображению. Обе модели опубликованы в открытом доступе. Модели…

В Shutterstock добавили редактирование изображений на основе DALL-E 2

28 октября 2023

В Shutterstock добавили редактирование изображений на основе DALL-E 2

В хранилище стоковых изображений Shutterstock добавили возможность обработки изображений перед скачиванием c помощью текстовых запросов. Новые функции работают на основе OpenAI DALL-E 2 и позволяют менять угол обзора сцены, заменять…